政府网站数据爬取
微信扫码沟通,客服可协助直接对接工程师;如当前档期不合,也可继续推荐相似案例作者。
案例介绍
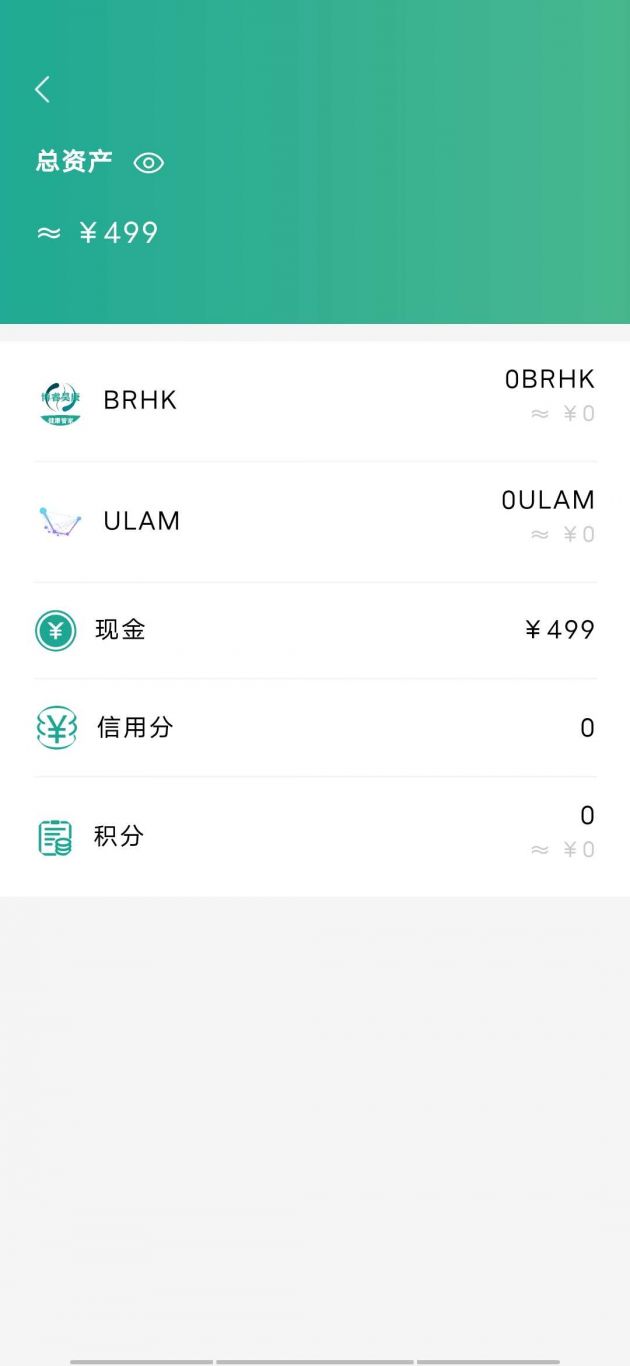
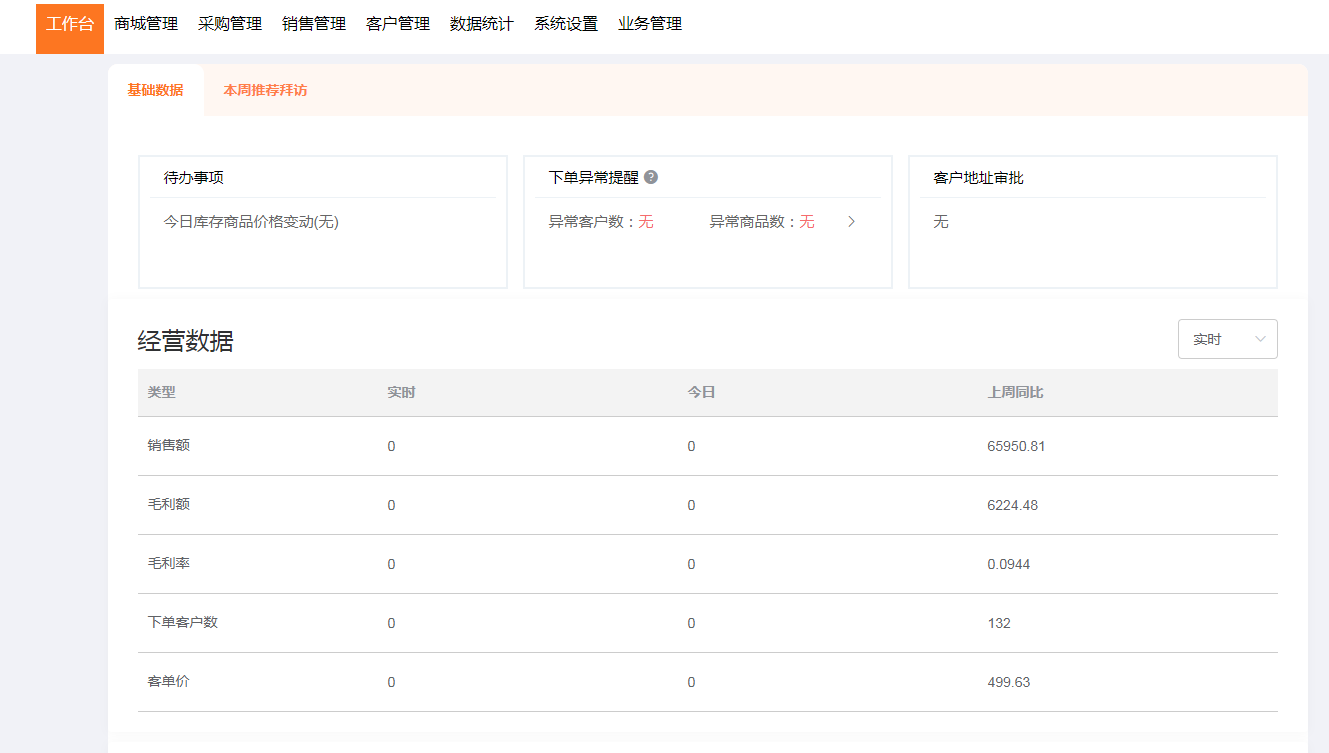
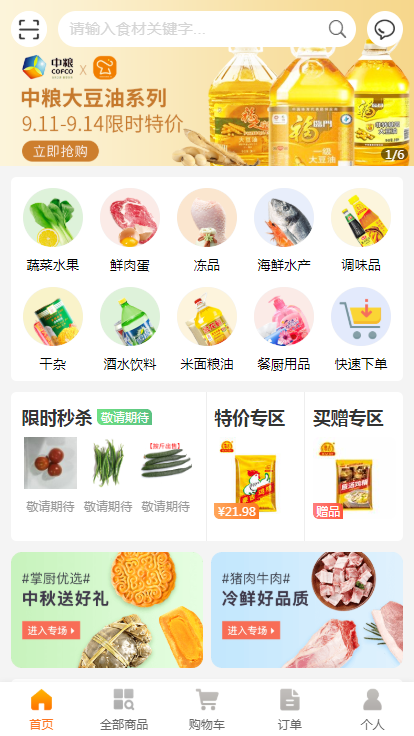
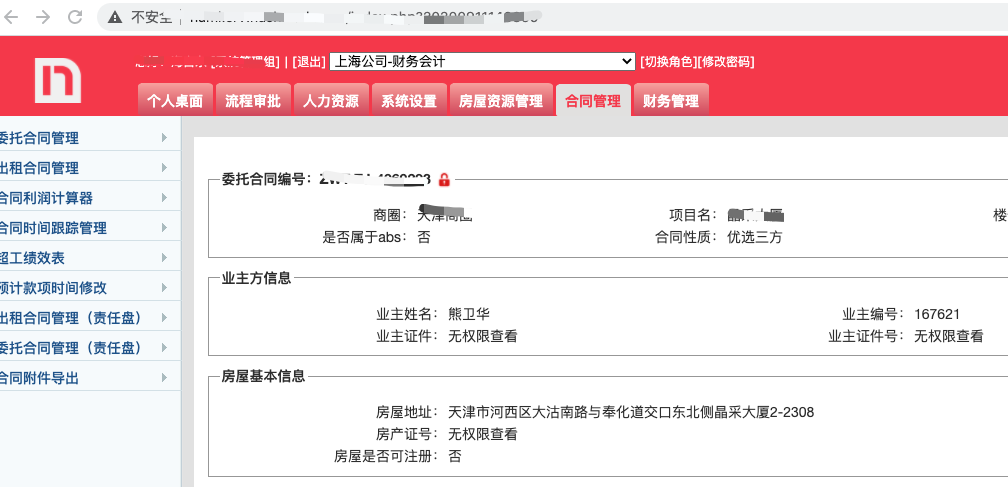
对智联、58、51、大街网、万行教师、中国商标网、BOSS直聘、招聘狗等各大招聘网站和企业数据网站进行个人简历与企业数据的爬取,爬取数据量约14亿,并对部分数据做清洗,生成报表。
技术描述:1.使用Scrapy框架进行数据的爬取;
2.参与分布式爬虫框架设计,搭建Scrapy_Redis提高爬取的效率;
3.对部分网站仍采用了Requests进行爬取,后基于aiohttp做了异步爬虫框架的封装,提高爬取效率;
4.中国商标网企业数据爬取遇到JS加密的反爬,通过不断分析网站,以数据为导向,最终找到绕过JS加密反爬手段的接口,获取到需要的数据;
5.大街网会动态更换登录的cookie信息,通过发送搜索页来获取新的cookies信息,再携带着新的cookies重新获取数据;
6.在爬取大量数据后,MySQL查询效率明显变慢,后采用大数据技术,搭建HBase集群(并使用zookeeper做高可用集群),将爬取到的数据存放到HBase中;
技术描述:1.使用Scrapy框架进行数据的爬取;
2.参与分布式爬虫框架设计,搭建Scrapy_Redis提高爬取的效率;
3.对部分网站仍采用了Requests进行爬取,后基于aiohttp做了异步爬虫框架的封装,提高爬取效率;
4.中国商标网企业数据爬取遇到JS加密的反爬,通过不断分析网站,以数据为导向,最终找到绕过JS加密反爬手段的接口,获取到需要的数据;
5.大街网会动态更换登录的cookie信息,通过发送搜索页来获取新的cookies信息,再携带着新的cookies重新获取数据;
6.在爬取大量数据后,MySQL查询效率明显变慢,后采用大数据技术,搭建HBase集群(并使用zookeeper做高可用集群),将爬取到的数据存放到HBase中;

政府网站数据爬取
联系该工程师

微信扫码,建群沟通
案例介绍
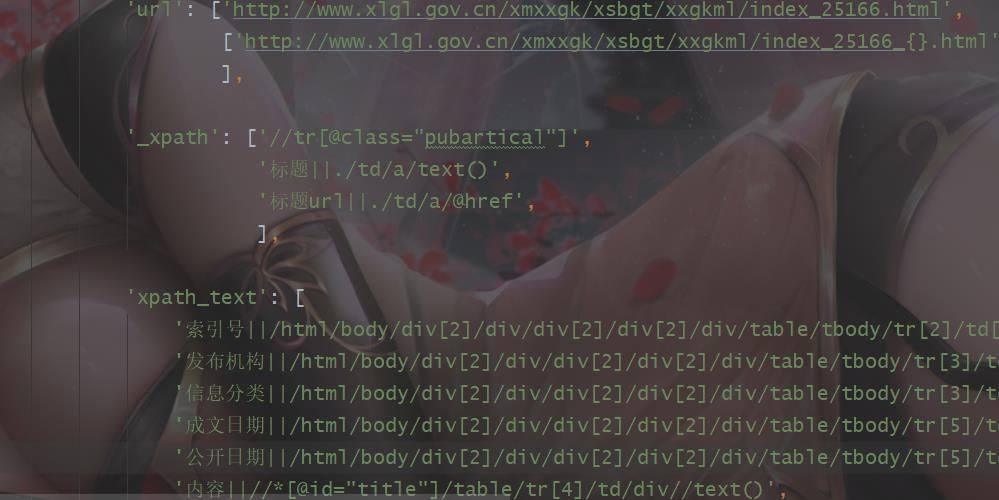
对智联、58、51、大街网、万行教师、中国商标网、BOSS直聘、招聘狗等各大招聘网站和企业数据网站进行个人简历与企业数据的爬取,爬取数据量约14亿,并对部分数据做清洗,生成报表。
技术描述:1.使用Scrapy框架进行数据的爬取;
2.参与分布式爬虫框架设计,搭建Scrapy_Redis提高爬取的效率;
3.对部分网站仍采用了Requests进行爬取,后基于aiohttp做了异步爬虫框架的封装,提高爬取效率;
4.中国商标网企业数据爬取遇到JS加密的反爬,通过不断分析网站,以数据为导向,最终找到绕过JS加密反爬手段的接口,获取到需要的数据;
5.大街网会动态更换登录的cookie信息,通过发送搜索页来获取新的cookies信息,再携带着新的cookies重新获取数据;
6.在爬取大量数据后,MySQL查询效率明显变慢,后采用大数据技术,搭建HBase集群(并使用zookeeper做高可用集群),将爬取到的数据存放到HBase中;
案例图片
1小时精推人才
需求方专属客服,免费梳理匹配

扫码加微信 · 客服人工对接
