所以一直搁浅
大数据开发运维工程师
趣头条 · 5年经验
日薪:
¥900/8h
地点:
上海 浦东
时间:
周六周日可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1、有每天千亿级数据实时从Kafka到Hdfs、ClickHouse的处理调优经验,可独立搭建维护
zookeeper+kakfa,clickhouse集群,有presto集群,hadoop集群的运维经验。以及扩容、监控、优化、
故障处理、集群迁移等工作,熟练使用ansible、python、shell编写自动化运维脚本。熟悉阿里EMR
集群/CDH集群的管理和维护。
2、熟练使用Java,Scala编程语言开发flink、spark完成etl以及指标开发,有flink百亿级数据
处理调优经验,熟练使用Java开发SpringBoot项目。
3、熟练使用azkaban,airflow 等调度框架,可完成hql,shell,python等脚本在调度平台的开发
配置。
4、熟练使用sqoop,gobblin等 etl工具,实现db与hadoop之间的数据离线交互,有每日200+ MySQL
表同步至数仓的经验。使用过 streamsets通过实时订阅binlog方式同步数据至Hbase。
5、熟练使用hive sql完成数据清洗,数仓建模,报表开发等工作。
6、使用过Hbase,Redis,TiDB了解其工作原理存储流程,可以完成表的设计,以及实时程序对接
写入。
7、熟悉Zookeeper,Flume,Kafka等框架之间的对接 ,可以搭建高效的平台对数据采集处理
8、能够运用superset,metabase,teableau报表展示工具对数据结果进行分析展示
zookeeper+kakfa,clickhouse集群,有presto集群,hadoop集群的运维经验。以及扩容、监控、优化、
故障处理、集群迁移等工作,熟练使用ansible、python、shell编写自动化运维脚本。熟悉阿里EMR
集群/CDH集群的管理和维护。
2、熟练使用Java,Scala编程语言开发flink、spark完成etl以及指标开发,有flink百亿级数据
处理调优经验,熟练使用Java开发SpringBoot项目。
3、熟练使用azkaban,airflow 等调度框架,可完成hql,shell,python等脚本在调度平台的开发
配置。
4、熟练使用sqoop,gobblin等 etl工具,实现db与hadoop之间的数据离线交互,有每日200+ MySQL
表同步至数仓的经验。使用过 streamsets通过实时订阅binlog方式同步数据至Hbase。
5、熟练使用hive sql完成数据清洗,数仓建模,报表开发等工作。
6、使用过Hbase,Redis,TiDB了解其工作原理存储流程,可以完成表的设计,以及实时程序对接
写入。
7、熟悉Zookeeper,Flume,Kafka等框架之间的对接 ,可以搭建高效的平台对数据采集处理
8、能够运用superset,metabase,teableau报表展示工具对数据结果进行分析展示
项目经验
责任描述:
一、运维部分:独立维护集团zk+kafka、clickhouse集群300+节点,配合维护azkaban、hadoop、
presto集群以及报表系统。负责数据中台建设过程中集群融合改造和迁移。
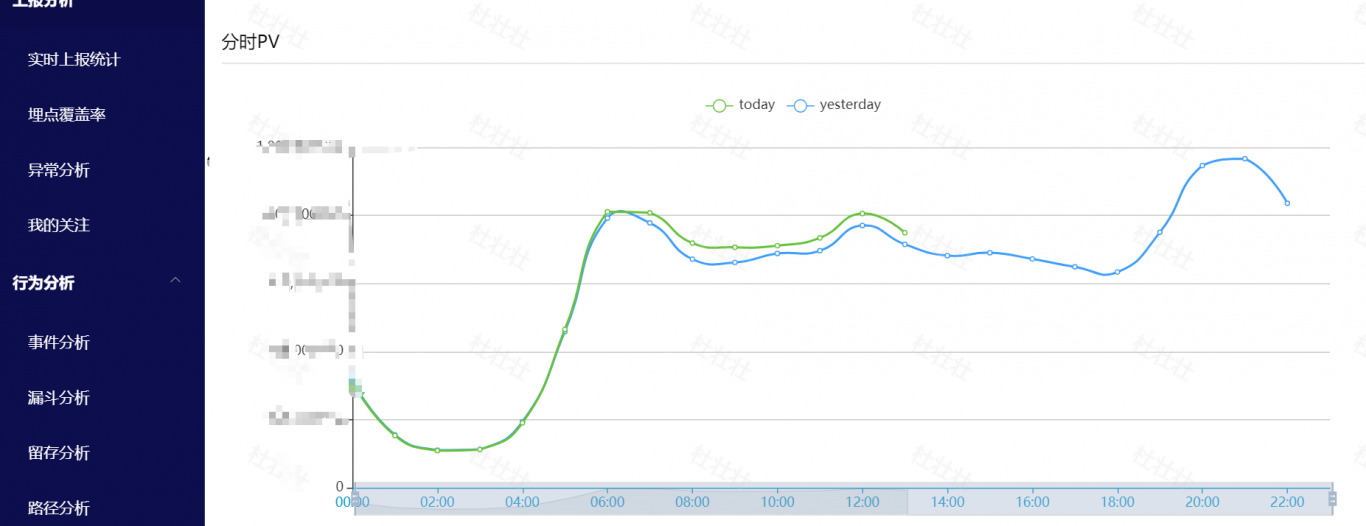
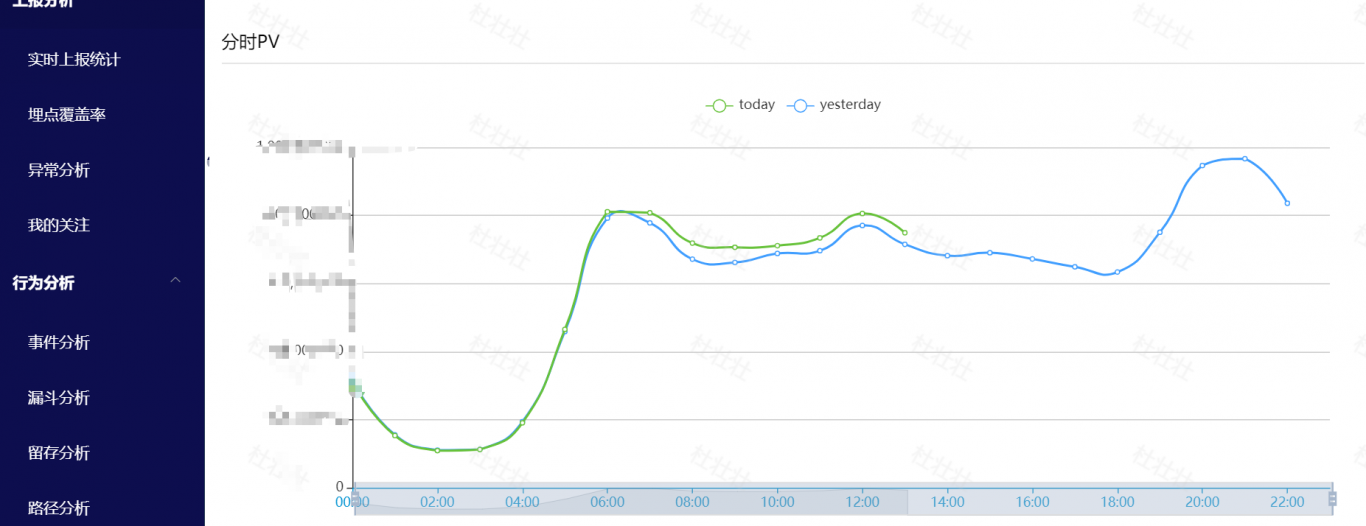
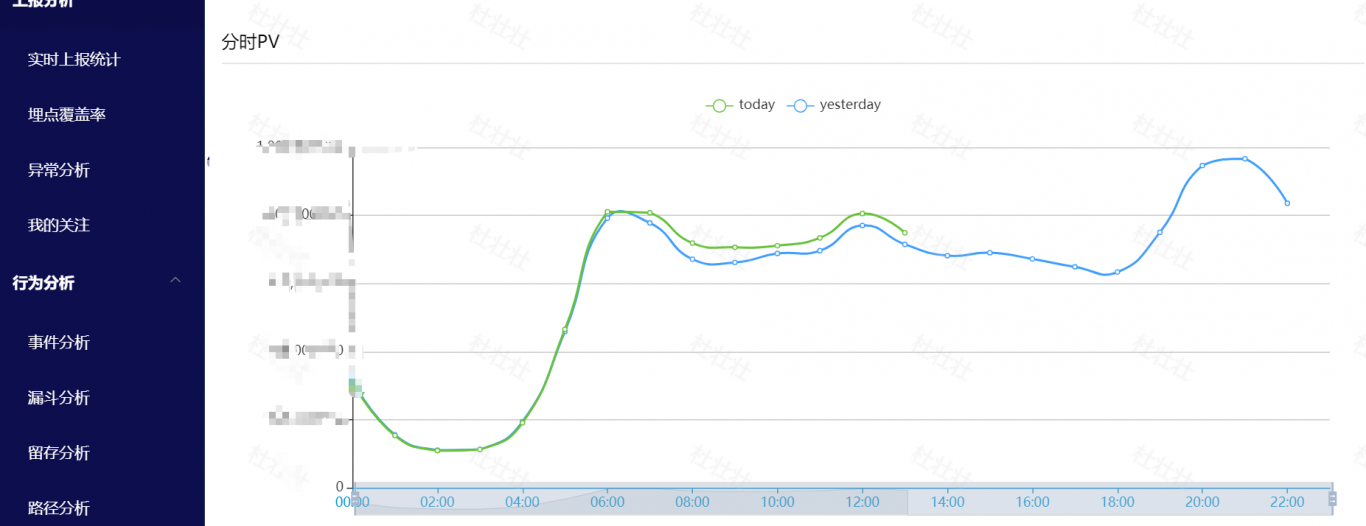
二、开发部分:参与数据中台的基础产品建设包括埋点上报管理平台、行为分析平台、数据质量
监控平台等平台,为平台提供千亿级数据的处理解决方案以及数据开发支持和后端开发支持。
工作内容:
1、参与数据中台从0-1的建设,参与埋点上报平台,专题分析平台等数据产品的springboot后端
研发以及flink、spark数据开发。独立使用flink开发支持了埋点事件实时统计、上报日志抽样分析
等模块,处理结果分钟级写入Tidb集群。累计上线维护flink实时任务150+。
2、负责clickhouse集群架构设计,搭建维护优化,使用flink秒级消费kafka上报日志写入,保障
日常OLAP查询稳定,并控制80%的OLAP查询在5S以内。
3、负责集团内zk+kafka集群的架构设计搭建维护扩容优化,故障处理等,保障了100+kafka节点,
峰值100w/s qps的数据稳定读写。
4、开发flink实时写入hive数仓、clickhouse通用程序,可处理protobuf,json 等数据格式每日
百亿级数据稳定写入。
5、使用sqoop、gobblin配合azkaban,airflow等调度系统处理每日200+的数据库表 T+1天从数据
库同步至离线数仓ODS层。
6、开发flink实时新增用户统计程序,对接外拉新平台,消费kafka数据,通过redis以及flink
state的去重,将新增用户信息通过kafka推动至外拉新平台。
7、负责公司调度平台azkaban的维护升级、二次开发,独立开发了企微、电话、SLA告警模块,a
平台日均调度任务300+。
8、负责公司海外AWS数据同步国内阿里云,跨海专线采购,网络打通。以及部署维护kafkamirror
实时同步两个跨海kafka集群。
9、在hadoop集群迁移过程中负责底层数据,hive元数据的迁移,累计迁移 hive表1000+,底层数
据10PB
10、负责使用spark开发Hdfs集群小文件合并工具,针对namenode压力日益增大的问题,该工具
累计合并减少文件数六千万,合并数据3PB。
一、运维部分:独立维护集团zk+kafka、clickhouse集群300+节点,配合维护azkaban、hadoop、
presto集群以及报表系统。负责数据中台建设过程中集群融合改造和迁移。
二、开发部分:参与数据中台的基础产品建设包括埋点上报管理平台、行为分析平台、数据质量
监控平台等平台,为平台提供千亿级数据的处理解决方案以及数据开发支持和后端开发支持。
工作内容:
1、参与数据中台从0-1的建设,参与埋点上报平台,专题分析平台等数据产品的springboot后端
研发以及flink、spark数据开发。独立使用flink开发支持了埋点事件实时统计、上报日志抽样分析
等模块,处理结果分钟级写入Tidb集群。累计上线维护flink实时任务150+。
2、负责clickhouse集群架构设计,搭建维护优化,使用flink秒级消费kafka上报日志写入,保障
日常OLAP查询稳定,并控制80%的OLAP查询在5S以内。
3、负责集团内zk+kafka集群的架构设计搭建维护扩容优化,故障处理等,保障了100+kafka节点,
峰值100w/s qps的数据稳定读写。
4、开发flink实时写入hive数仓、clickhouse通用程序,可处理protobuf,json 等数据格式每日
百亿级数据稳定写入。
5、使用sqoop、gobblin配合azkaban,airflow等调度系统处理每日200+的数据库表 T+1天从数据
库同步至离线数仓ODS层。
6、开发flink实时新增用户统计程序,对接外拉新平台,消费kafka数据,通过redis以及flink
state的去重,将新增用户信息通过kafka推动至外拉新平台。
7、负责公司调度平台azkaban的维护升级、二次开发,独立开发了企微、电话、SLA告警模块,a
平台日均调度任务300+。
8、负责公司海外AWS数据同步国内阿里云,跨海专线采购,网络打通。以及部署维护kafkamirror
实时同步两个跨海kafka集群。
9、在hadoop集群迁移过程中负责底层数据,hive元数据的迁移,累计迁移 hive表1000+,底层数
据10PB
10、负责使用spark开发Hdfs集群小文件合并工具,针对namenode压力日益增大的问题,该工具
累计合并减少文件数六千万,合并数据3PB。

所以一直搁浅
大数据开发运维工程师 · 5年经验 · 趣头条
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1、有每天千亿级数据实时从Kafka到Hdfs、ClickHouse的处理调优经验,可独立搭建维护
zookeeper+kakfa,clickhouse集群,有presto集群,hadoop集群的运维经验。以及扩容、监控、优化、
故障处理、集群迁移等工作,熟练使用ansible、python、shell编写自动化运维脚本。熟悉阿里EMR
集群/CDH集群的管理和维护。
2、熟练使用Java,Scala编程语言开发flink、spark完成etl以及指标开发,有flink百亿级数据
处理调优经验,熟练使用Java开发SpringBoot项目。
3、熟练使用azkaban,airflow 等调度框架,可完成hql,shell,python等脚本在调度平台的开发
配置。
4、熟练使用sqoop,gobblin等 etl工具,实现db与hadoop之间的数据离线交互,有每日200+ MySQL
表同步至数仓的经验。使用过 streamsets通过实时订阅binlog方式同步数据至Hbase。
5、熟练使用hive sql完成数据清洗,数仓建模,报表开发等工作。
6、使用过Hbase,Redis,TiDB了解其工作原理存储流程,可以完成表的设计,以及实时程序对接
写入。
7、熟悉Zookeeper,Flume,Kafka等框架之间的对接 ,可以搭建高效的平台对数据采集处理
8、能够运用superset,metabase,teableau报表展示工具对数据结果进行分析展示
zookeeper+kakfa,clickhouse集群,有presto集群,hadoop集群的运维经验。以及扩容、监控、优化、
故障处理、集群迁移等工作,熟练使用ansible、python、shell编写自动化运维脚本。熟悉阿里EMR
集群/CDH集群的管理和维护。
2、熟练使用Java,Scala编程语言开发flink、spark完成etl以及指标开发,有flink百亿级数据
处理调优经验,熟练使用Java开发SpringBoot项目。
3、熟练使用azkaban,airflow 等调度框架,可完成hql,shell,python等脚本在调度平台的开发
配置。
4、熟练使用sqoop,gobblin等 etl工具,实现db与hadoop之间的数据离线交互,有每日200+ MySQL
表同步至数仓的经验。使用过 streamsets通过实时订阅binlog方式同步数据至Hbase。
5、熟练使用hive sql完成数据清洗,数仓建模,报表开发等工作。
6、使用过Hbase,Redis,TiDB了解其工作原理存储流程,可以完成表的设计,以及实时程序对接
写入。
7、熟悉Zookeeper,Flume,Kafka等框架之间的对接 ,可以搭建高效的平台对数据采集处理
8、能够运用superset,metabase,teableau报表展示工具对数据结果进行分析展示
项目经验
责任描述:
一、运维部分:独立维护集团zk+kafka、clickhouse集群300+节点,配合维护azkaban、hadoop、
presto集群以及报表系统。负责数据中台建设过程中集群融合改造和迁移。
二、开发部分:参与数据中台的基础产品建设包括埋点上报管理平台、行为分析平台、数据质量
监控平台等平台,为平台提供千亿级数据的处理解决方案以及数据开发支持和后端开发支持。
工作内容:
1、参与数据中台从0-1的建设,参与埋点上报平台,专题分析平台等数据产品的springboot后端
研发以及flink、spark数据开发。独立使用flink开发支持了埋点事件实时统计、上报日志抽样分析
等模块,处理结果分钟级写入Tidb集群。累计上线维护flink实时任务150+。
2、负责clickhouse集群架构设计,搭建维护优化,使用flink秒级消费kafka上报日志写入,保障
日常OLAP查询稳定,并控制80%的OLAP查询在5S以内。
3、负责集团内zk+kafka集群的架构设计搭建维护扩容优化,故障处理等,保障了100+kafka节点,
峰值100w/s qps的数据稳定读写。
4、开发flink实时写入hive数仓、clickhouse通用程序,可处理protobuf,json 等数据格式每日
百亿级数据稳定写入。
5、使用sqoop、gobblin配合azkaban,airflow等调度系统处理每日200+的数据库表 T+1天从数据
库同步至离线数仓ODS层。
6、开发flink实时新增用户统计程序,对接外拉新平台,消费kafka数据,通过redis以及flink
state的去重,将新增用户信息通过kafka推动至外拉新平台。
7、负责公司调度平台azkaban的维护升级、二次开发,独立开发了企微、电话、SLA告警模块,a
平台日均调度任务300+。
8、负责公司海外AWS数据同步国内阿里云,跨海专线采购,网络打通。以及部署维护kafkamirror
实时同步两个跨海kafka集群。
9、在hadoop集群迁移过程中负责底层数据,hive元数据的迁移,累计迁移 hive表1000+,底层数
据10PB
10、负责使用spark开发Hdfs集群小文件合并工具,针对namenode压力日益增大的问题,该工具
累计合并减少文件数六千万,合并数据3PB。
一、运维部分:独立维护集团zk+kafka、clickhouse集群300+节点,配合维护azkaban、hadoop、
presto集群以及报表系统。负责数据中台建设过程中集群融合改造和迁移。
二、开发部分:参与数据中台的基础产品建设包括埋点上报管理平台、行为分析平台、数据质量
监控平台等平台,为平台提供千亿级数据的处理解决方案以及数据开发支持和后端开发支持。
工作内容:
1、参与数据中台从0-1的建设,参与埋点上报平台,专题分析平台等数据产品的springboot后端
研发以及flink、spark数据开发。独立使用flink开发支持了埋点事件实时统计、上报日志抽样分析
等模块,处理结果分钟级写入Tidb集群。累计上线维护flink实时任务150+。
2、负责clickhouse集群架构设计,搭建维护优化,使用flink秒级消费kafka上报日志写入,保障
日常OLAP查询稳定,并控制80%的OLAP查询在5S以内。
3、负责集团内zk+kafka集群的架构设计搭建维护扩容优化,故障处理等,保障了100+kafka节点,
峰值100w/s qps的数据稳定读写。
4、开发flink实时写入hive数仓、clickhouse通用程序,可处理protobuf,json 等数据格式每日
百亿级数据稳定写入。
5、使用sqoop、gobblin配合azkaban,airflow等调度系统处理每日200+的数据库表 T+1天从数据
库同步至离线数仓ODS层。
6、开发flink实时新增用户统计程序,对接外拉新平台,消费kafka数据,通过redis以及flink
state的去重,将新增用户信息通过kafka推动至外拉新平台。
7、负责公司调度平台azkaban的维护升级、二次开发,独立开发了企微、电话、SLA告警模块,a
平台日均调度任务300+。
8、负责公司海外AWS数据同步国内阿里云,跨海专线采购,网络打通。以及部署维护kafkamirror
实时同步两个跨海kafka集群。
9、在hadoop集群迁移过程中负责底层数据,hive元数据的迁移,累计迁移 hive表1000+,底层数
据10PB
10、负责使用spark开发Hdfs集群小文件合并工具,针对namenode压力日益增大的问题,该工具
累计合并减少文件数六千万,合并数据3PB。

 立即沟通


