Curry
大数据研发
石家庄尚云科技 · 2年经验
日薪:
¥500/8h
地点:
石家庄 全区
时间:
可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
熟练海量数据处理相关技术,包括Hadoop、Spark、Hive等,对HDFS存储架构、Map/Reduce计算框架、Spark计算框架较熟悉。
熟悉神经网络底层原理,以及SparkMlib框架
熟练Java SE,包括IO流、多线程、集合数据结构、反射等。
熟练Java Web,对SpringMvc,SpringBoot,SSM等框架熟练应用,对IOC,AOP(DI)分层设计与实现有深刻理解和灵活应用。
熟练掌握前台应用技术,包括html、css、javascript、jQuery、xml、json等。
熟练掌握常用数据库,包括mysql、hive,hbase,以及缓存组件redis,以及常用的数据库优化方法与策略。
熟练掌握linux/unix下shell脚本编程,并对Python有相当了解。
熟悉webmagic框架,可以实现简单对动态页面爬取数据
熟悉autoJs框架,可以实现复杂功能的脚本化自动化
熟悉其它编程语言,包括scala、python等。
熟悉神经网络底层原理,以及SparkMlib框架
熟练Java SE,包括IO流、多线程、集合数据结构、反射等。
熟练Java Web,对SpringMvc,SpringBoot,SSM等框架熟练应用,对IOC,AOP(DI)分层设计与实现有深刻理解和灵活应用。
熟练掌握前台应用技术,包括html、css、javascript、jQuery、xml、json等。
熟练掌握常用数据库,包括mysql、hive,hbase,以及缓存组件redis,以及常用的数据库优化方法与策略。
熟练掌握linux/unix下shell脚本编程,并对Python有相当了解。
熟悉webmagic框架,可以实现简单对动态页面爬取数据
熟悉autoJs框架,可以实现复杂功能的脚本化自动化
熟悉其它编程语言,包括scala、python等。
项目经验
电影推荐系统
根据sparkMlib框架的ALS交叉最小二乘法开发协同过滤隐语义模型,使用电影矩阵分解计算余弦相似度.以及标签的TF-IDF逆文档词频相似度计算.独立开发完成冷启动模块,以及实时推荐模块.完成根据用户标签进行电影推荐,并根据用户行为进行实时推荐
亿级微博实时流数据UA监控
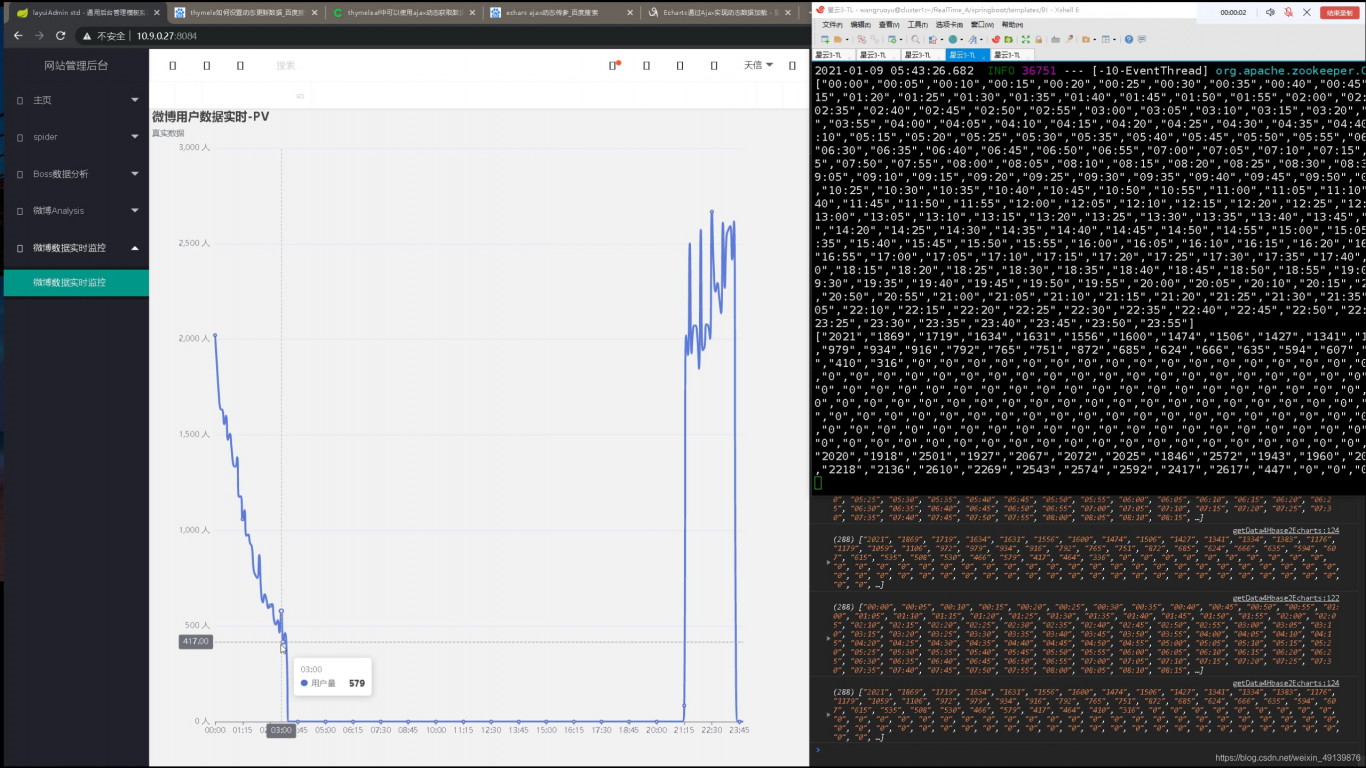
根据采集工程师实时爬取到的微博数据,实时传输到数据接收服务平台,形成微博博文数据,构建,基于该微博平台实时数据的相应数据仓库,同时做好相应的数据监控工作,用于及时发现数据潜在问题,例如数据暴增骤减等情况,以及其他潜在数据开发需求
亿级数据舆情热点挖掘项目
基于HIVE中的tez引擎,实现对微博用户数据画像的自动化处理,并将数据交互展示在前端
微博ETL
通过shell,udf,hive,hdfs, 技术将数据,抽取、清洗转换之后把干净的结构化数据加载到数据仓库的过程
IP地址库毫秒级查询项目
基于项目的需求,需要实现对ip地址的毫秒级响应,并尽量提升查询效率.合理使用集合框架的数据结构,使用二分查询,序列化与反序列化,编解码等方法多次优化,最终实现毫秒级响应
根据sparkMlib框架的ALS交叉最小二乘法开发协同过滤隐语义模型,使用电影矩阵分解计算余弦相似度.以及标签的TF-IDF逆文档词频相似度计算.独立开发完成冷启动模块,以及实时推荐模块.完成根据用户标签进行电影推荐,并根据用户行为进行实时推荐
亿级微博实时流数据UA监控
根据采集工程师实时爬取到的微博数据,实时传输到数据接收服务平台,形成微博博文数据,构建,基于该微博平台实时数据的相应数据仓库,同时做好相应的数据监控工作,用于及时发现数据潜在问题,例如数据暴增骤减等情况,以及其他潜在数据开发需求
亿级数据舆情热点挖掘项目
基于HIVE中的tez引擎,实现对微博用户数据画像的自动化处理,并将数据交互展示在前端
微博ETL
通过shell,udf,hive,hdfs, 技术将数据,抽取、清洗转换之后把干净的结构化数据加载到数据仓库的过程
IP地址库毫秒级查询项目
基于项目的需求,需要实现对ip地址的毫秒级响应,并尽量提升查询效率.合理使用集合框架的数据结构,使用二分查询,序列化与反序列化,编解码等方法多次优化,最终实现毫秒级响应
案例展示 全部案例 >



Curry
大数据研发 · 2年经验 · 石家庄尚云科技
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
熟练海量数据处理相关技术,包括Hadoop、Spark、Hive等,对HDFS存储架构、Map/Reduce计算框架、Spark计算框架较熟悉。
熟悉神经网络底层原理,以及SparkMlib框架
熟练Java SE,包括IO流、多线程、集合数据结构、反射等。
熟练Java Web,对SpringMvc,SpringBoot,SSM等框架熟练应用,对IOC,AOP(DI)分层设计与实现有深刻理解和灵活应用。
熟练掌握前台应用技术,包括html、css、javascript、jQuery、xml、json等。
熟练掌握常用数据库,包括mysql、hive,hbase,以及缓存组件redis,以及常用的数据库优化方法与策略。
熟练掌握linux/unix下shell脚本编程,并对Python有相当了解。
熟悉webmagic框架,可以实现简单对动态页面爬取数据
熟悉autoJs框架,可以实现复杂功能的脚本化自动化
熟悉其它编程语言,包括scala、python等。
熟悉神经网络底层原理,以及SparkMlib框架
熟练Java SE,包括IO流、多线程、集合数据结构、反射等。
熟练Java Web,对SpringMvc,SpringBoot,SSM等框架熟练应用,对IOC,AOP(DI)分层设计与实现有深刻理解和灵活应用。
熟练掌握前台应用技术,包括html、css、javascript、jQuery、xml、json等。
熟练掌握常用数据库,包括mysql、hive,hbase,以及缓存组件redis,以及常用的数据库优化方法与策略。
熟练掌握linux/unix下shell脚本编程,并对Python有相当了解。
熟悉webmagic框架,可以实现简单对动态页面爬取数据
熟悉autoJs框架,可以实现复杂功能的脚本化自动化
熟悉其它编程语言,包括scala、python等。
项目经验
电影推荐系统
根据sparkMlib框架的ALS交叉最小二乘法开发协同过滤隐语义模型,使用电影矩阵分解计算余弦相似度.以及标签的TF-IDF逆文档词频相似度计算.独立开发完成冷启动模块,以及实时推荐模块.完成根据用户标签进行电影推荐,并根据用户行为进行实时推荐
亿级微博实时流数据UA监控
根据采集工程师实时爬取到的微博数据,实时传输到数据接收服务平台,形成微博博文数据,构建,基于该微博平台实时数据的相应数据仓库,同时做好相应的数据监控工作,用于及时发现数据潜在问题,例如数据暴增骤减等情况,以及其他潜在数据开发需求
亿级数据舆情热点挖掘项目
基于HIVE中的tez引擎,实现对微博用户数据画像的自动化处理,并将数据交互展示在前端
微博ETL
通过shell,udf,hive,hdfs, 技术将数据,抽取、清洗转换之后把干净的结构化数据加载到数据仓库的过程
IP地址库毫秒级查询项目
基于项目的需求,需要实现对ip地址的毫秒级响应,并尽量提升查询效率.合理使用集合框架的数据结构,使用二分查询,序列化与反序列化,编解码等方法多次优化,最终实现毫秒级响应
根据sparkMlib框架的ALS交叉最小二乘法开发协同过滤隐语义模型,使用电影矩阵分解计算余弦相似度.以及标签的TF-IDF逆文档词频相似度计算.独立开发完成冷启动模块,以及实时推荐模块.完成根据用户标签进行电影推荐,并根据用户行为进行实时推荐
亿级微博实时流数据UA监控
根据采集工程师实时爬取到的微博数据,实时传输到数据接收服务平台,形成微博博文数据,构建,基于该微博平台实时数据的相应数据仓库,同时做好相应的数据监控工作,用于及时发现数据潜在问题,例如数据暴增骤减等情况,以及其他潜在数据开发需求
亿级数据舆情热点挖掘项目
基于HIVE中的tez引擎,实现对微博用户数据画像的自动化处理,并将数据交互展示在前端
微博ETL
通过shell,udf,hive,hdfs, 技术将数据,抽取、清洗转换之后把干净的结构化数据加载到数据仓库的过程
IP地址库毫秒级查询项目
基于项目的需求,需要实现对ip地址的毫秒级响应,并尽量提升查询效率.合理使用集合框架的数据结构,使用二分查询,序列化与反序列化,编解码等方法多次优化,最终实现毫秒级响应

 立即沟通


