the sunshine
数据开发工程师
WH · 4年经验
日薪:
¥700/8h
地点:
北京 海淀
时间:
下班后周六周日可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
-熟练掌握 Hadoop,熟悉 MapReduce 的工作流程和 shuffle 机制可以独立编写 MapReduce 处理数据,拥有 Hadoop 调优的经验,理解yarn 的工作机制Spark(core,sql,streaming)、Flink 等大数据开源框架
-熟练掌握 ETL 工具 kettle 进行数据(清洗,转换,整合),datax/sqoop 转储工具
-熟练掌握 SQL,有良好的编码习惯,对分布式有深刻理解
-熟练掌握 mysql/hive/redis/hbase/odps/gbase/kudu 等储存机制,简单调参调优
- 兼职 : python 数据抓取, pandas, Django, Scrapy 相关框架 JQ,JS, app 逆向等
-熟练掌握 ETL 工具 kettle 进行数据(清洗,转换,整合),datax/sqoop 转储工具
-熟练掌握 SQL,有良好的编码习惯,对分布式有深刻理解
-熟练掌握 mysql/hive/redis/hbase/odps/gbase/kudu 等储存机制,简单调参调优
- 兼职 : python 数据抓取, pandas, Django, Scrapy 相关框架 JQ,JS, app 逆向等
项目经验
项目一
项目名称: 无忧系统 一
项目描述: 为企业和开发者提供结构化数据,支持数据分析处理等功能。为公司提供数据的储存和统计,全流程可视化方式帮助企业客户提升效率,降低开发门槛,快速构建 AI 应用。
开 发 框 架 : mysql+kettle+odps+gabse+hive+kylin+datax+solr+dolphinscheduler+sparkSql/hiveSql
项目职责:
1.基于业务的流程,数据仓库采取建立为四层,ODS 数据贴源层,DW 数据汇集层,DWD 数据分 析层,ADS 数据服务层。
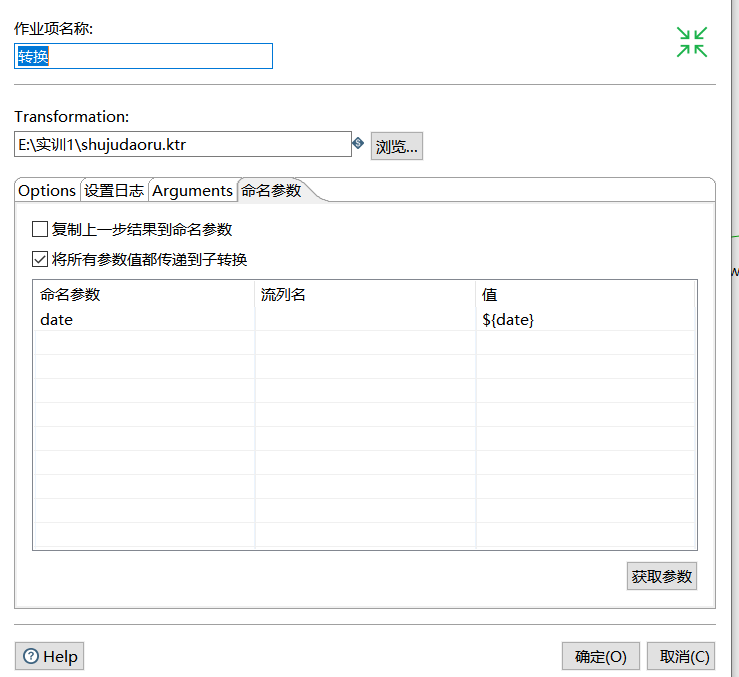
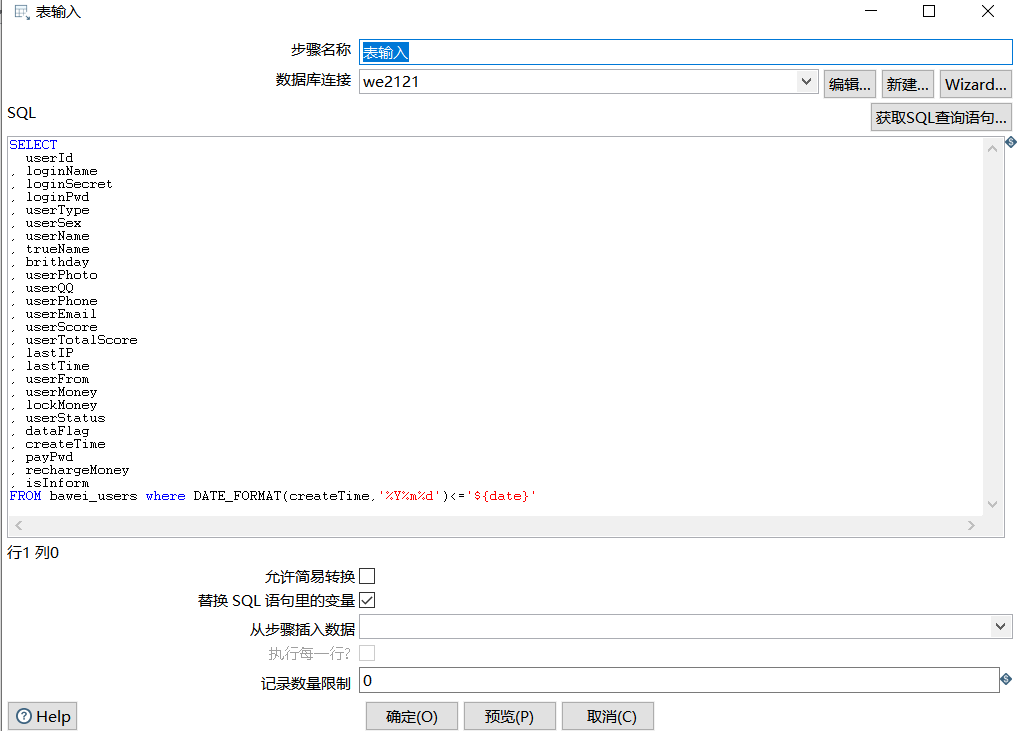
2.将mysql 数据通过 kettle 清洗软件,通过转换,作业的操作进行对数据的(去重,字段删 除,新增 列等) 传到到 ODS 层
3.进行数据及业务分析,生成结果(使用 Hive 的 hql 语句进行数据开发)。
4.通过使用HQL 进行相关指标的开发,进行指标的不同角度分析
5.Kylin 数据分析 dw 层的一个主题(保单表,客户表等)与多个维度(保单类型,支付类型,联系方式, 被保人等),进行表的业务分析
6.进行项目优化,hive,kylin 等组件以及数据倾斜的问题
项目排障:
1.在分析数据数据一直运行,运行不完成的问题: 解决方法
1). combine 使用 combine 可以大量的减小数据倾斜,combine 的 目的就是聚合精简数据2). 空值产生的数据倾斜赋与空值分新的 key 值比较好些
2.kylin 的优化
1).将敏感的维度设置为强制维度,优化后的效果为减少了一半 Cuboid 的数量。综合优化下,膨胀率降至不足 750%,大大减小了 Cube 体积。
2).关闭 HBase 自动 Balance 的功能,仅在夜间业务低峰期开启几个小时;

the sunshine
数据开发工程师 · 4年经验 · WH
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
-熟练掌握 Hadoop,熟悉 MapReduce 的工作流程和 shuffle 机制可以独立编写 MapReduce 处理数据,拥有 Hadoop 调优的经验,理解yarn 的工作机制Spark(core,sql,streaming)、Flink 等大数据开源框架
-熟练掌握 ETL 工具 kettle 进行数据(清洗,转换,整合),datax/sqoop 转储工具
-熟练掌握 SQL,有良好的编码习惯,对分布式有深刻理解
-熟练掌握 mysql/hive/redis/hbase/odps/gbase/kudu 等储存机制,简单调参调优
- 兼职 : python 数据抓取, pandas, Django, Scrapy 相关框架 JQ,JS, app 逆向等
-熟练掌握 ETL 工具 kettle 进行数据(清洗,转换,整合),datax/sqoop 转储工具
-熟练掌握 SQL,有良好的编码习惯,对分布式有深刻理解
-熟练掌握 mysql/hive/redis/hbase/odps/gbase/kudu 等储存机制,简单调参调优
- 兼职 : python 数据抓取, pandas, Django, Scrapy 相关框架 JQ,JS, app 逆向等
项目经验
项目一
项目名称: 无忧系统 一
项目描述: 为企业和开发者提供结构化数据,支持数据分析处理等功能。为公司提供数据的储存和统计,全流程可视化方式帮助企业客户提升效率,降低开发门槛,快速构建 AI 应用。
开 发 框 架 : mysql+kettle+odps+gabse+hive+kylin+datax+solr+dolphinscheduler+sparkSql/hiveSql
项目职责:
1.基于业务的流程,数据仓库采取建立为四层,ODS 数据贴源层,DW 数据汇集层,DWD 数据分 析层,ADS 数据服务层。
2.将mysql 数据通过 kettle 清洗软件,通过转换,作业的操作进行对数据的(去重,字段删 除,新增 列等) 传到到 ODS 层
3.进行数据及业务分析,生成结果(使用 Hive 的 hql 语句进行数据开发)。
4.通过使用HQL 进行相关指标的开发,进行指标的不同角度分析
5.Kylin 数据分析 dw 层的一个主题(保单表,客户表等)与多个维度(保单类型,支付类型,联系方式, 被保人等),进行表的业务分析
6.进行项目优化,hive,kylin 等组件以及数据倾斜的问题
项目排障:
1.在分析数据数据一直运行,运行不完成的问题: 解决方法
1). combine 使用 combine 可以大量的减小数据倾斜,combine 的 目的就是聚合精简数据2). 空值产生的数据倾斜赋与空值分新的 key 值比较好些
2.kylin 的优化
1).将敏感的维度设置为强制维度,优化后的效果为减少了一半 Cuboid 的数量。综合优化下,膨胀率降至不足 750%,大大减小了 Cube 体积。
2).关闭 HBase 自动 Balance 的功能,仅在夜间业务低峰期开启几个小时;
项目名称: 无忧系统 一
项目描述: 为企业和开发者提供结构化数据,支持数据分析处理等功能。为公司提供数据的储存和统计,全流程可视化方式帮助企业客户提升效率,降低开发门槛,快速构建 AI 应用。
开 发 框 架 : mysql+kettle+odps+gabse+hive+kylin+datax+solr+dolphinscheduler+sparkSql/hiveSql
项目职责:
1.基于业务的流程,数据仓库采取建立为四层,ODS 数据贴源层,DW 数据汇集层,DWD 数据分 析层,ADS 数据服务层。
2.将mysql 数据通过 kettle 清洗软件,通过转换,作业的操作进行对数据的(去重,字段删 除,新增 列等) 传到到 ODS 层
3.进行数据及业务分析,生成结果(使用 Hive 的 hql 语句进行数据开发)。
4.通过使用HQL 进行相关指标的开发,进行指标的不同角度分析
5.Kylin 数据分析 dw 层的一个主题(保单表,客户表等)与多个维度(保单类型,支付类型,联系方式, 被保人等),进行表的业务分析
6.进行项目优化,hive,kylin 等组件以及数据倾斜的问题
项目排障:
1.在分析数据数据一直运行,运行不完成的问题: 解决方法
1). combine 使用 combine 可以大量的减小数据倾斜,combine 的 目的就是聚合精简数据2). 空值产生的数据倾斜赋与空值分新的 key 值比较好些
2.kylin 的优化
1).将敏感的维度设置为强制维度,优化后的效果为减少了一半 Cuboid 的数量。综合优化下,膨胀率降至不足 750%,大大减小了 Cube 体积。
2).关闭 HBase 自动 Balance 的功能,仅在夜间业务低峰期开启几个小时;

 立即沟通


