岸Filda
研发测试
广东华展家具制造有限公司 · 1年经验
日薪:
¥500/8h
地点:
广州 天河
时间:
下班后周六周日可工作日远程可工作日驻场(离职原因)可工作日驻场(自由职业原因)
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
前端开发方面的技术:
HTML:我熟练使用HTML语言构建网页结构,包括使用各种标签和属性来定义页面内容和布局。
CSS:我掌握CSS样式表语言,能够使用选择器、样式规则和属性来美化网页,包括调整字体、颜色、布局和动画效果等。
JavaScript:我具备良好的JavaScript编程能力,能够使用该语言实现交互功能、响应式设计和动态效果等,提升用户体验。
前端框架:我熟悉流行的前端框架,如Bootstrap、React和Vue.js,能够利用它们快速构建响应式、可扩展的网页应用程序。
Express.js:我掌握Express.js框架,能够搭建灵活且高效的Node.js服务器。
数据库:我熟悉与Node.js集成的各种数据库,如MongoDB和MySQL,能够进行数据存储和检索操作。
API开发:我具备设计和实现RESTful API的能力,能够处理HTTP请求和响应,进行数据交互。
安全性:我了解如何处理用户身份验证、数据加密和防止常见的网络攻击等方面的安全问题。
爬虫方面的技术:
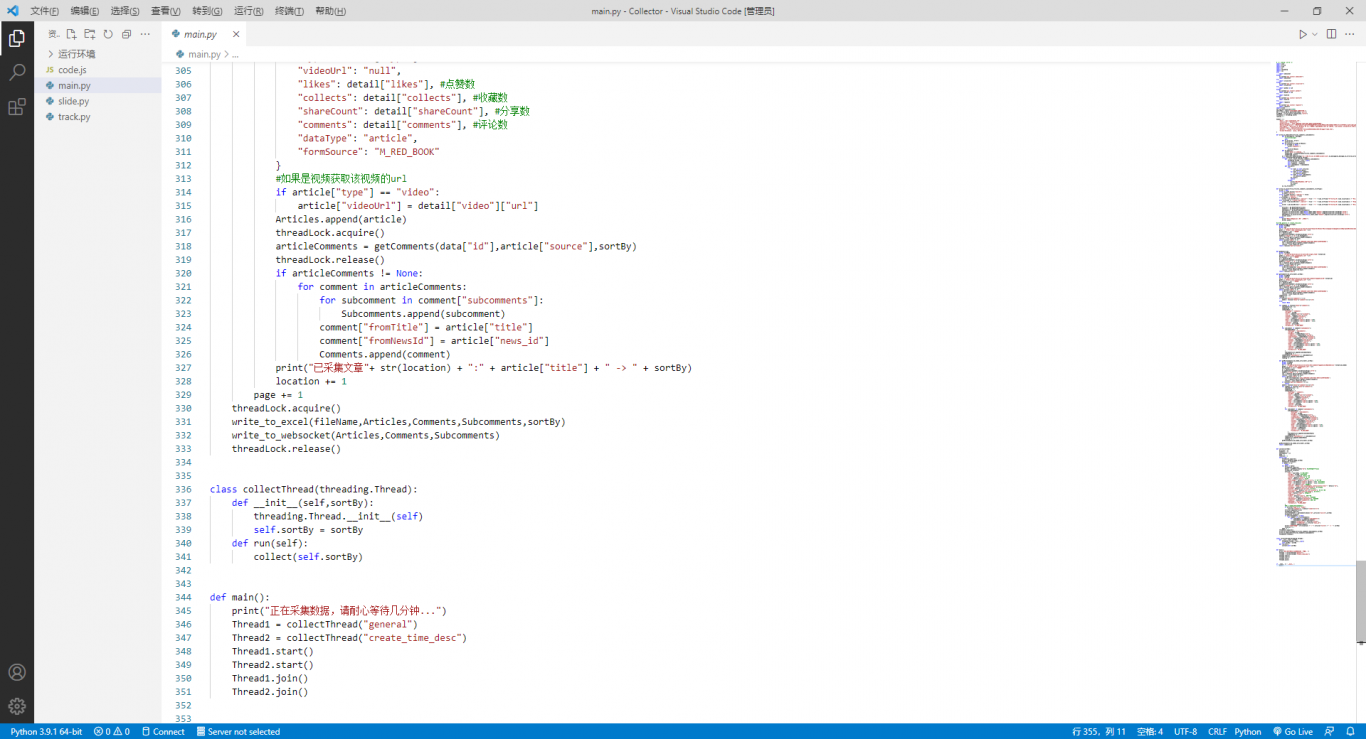
编程语言:我精通Python编程语言,用它来编写高效的爬虫代码。
网络请求:我使用Python的Requests库发送HTTP请求,并设置请求头、Cookie和Session,以模拟浏览器行为。
数据解析:我熟悉使用Python的xpath库和正则表达式来解析HTML、XML和JSON等类型的数据,并提取所需的信息。
数据存储:我能够将爬取到的数据保存到CSV,EXCEL文件、数据库或其他数据存储系统中,例如使用Python的Pandas库进行数据处理和清洗。
HTML:我熟练使用HTML语言构建网页结构,包括使用各种标签和属性来定义页面内容和布局。
CSS:我掌握CSS样式表语言,能够使用选择器、样式规则和属性来美化网页,包括调整字体、颜色、布局和动画效果等。
JavaScript:我具备良好的JavaScript编程能力,能够使用该语言实现交互功能、响应式设计和动态效果等,提升用户体验。
前端框架:我熟悉流行的前端框架,如Bootstrap、React和Vue.js,能够利用它们快速构建响应式、可扩展的网页应用程序。
Express.js:我掌握Express.js框架,能够搭建灵活且高效的Node.js服务器。
数据库:我熟悉与Node.js集成的各种数据库,如MongoDB和MySQL,能够进行数据存储和检索操作。
API开发:我具备设计和实现RESTful API的能力,能够处理HTTP请求和响应,进行数据交互。
安全性:我了解如何处理用户身份验证、数据加密和防止常见的网络攻击等方面的安全问题。
爬虫方面的技术:
编程语言:我精通Python编程语言,用它来编写高效的爬虫代码。
网络请求:我使用Python的Requests库发送HTTP请求,并设置请求头、Cookie和Session,以模拟浏览器行为。
数据解析:我熟悉使用Python的xpath库和正则表达式来解析HTML、XML和JSON等类型的数据,并提取所需的信息。
数据存储:我能够将爬取到的数据保存到CSV,EXCEL文件、数据库或其他数据存储系统中,例如使用Python的Pandas库进行数据处理和清洗。
项目经验
爬虫经验:
技术选型:我选择Python作为爬虫的编程语言,因为它具有强大的网络请求和数据解析能力。我使用了Requests库发送HTTP请求,并使用BeautifulSoup,xpath,正则表达式解析和提取网页数据。
网络请求和数据解析:我使用Requests库发送GET或POST请求,并设置适当的请求头,以模拟浏览器的行为提取所需的信息。
反爬虫策略:在一些网站上,我遇到了反爬虫机制,如IP封禁和验证码。为了应对这些问题,我使用了代理IP池来隐藏我的真实IP地址,并设置了随机的User-Agent头信息。此外,我还限制了爬取速度以避免过多的请求对目标网站造成负担。
前端开发经验:
技术选型:我使用了HTML、CSS和JavaScript进行前端开发,以创建交互式和响应式的网页。我还使用了vue框架来快速构建页面结构和样式。
页面设计和布局:我设计了清晰的页面结构,并使用CSS进行样式设置,包括字体、颜色、边距和响应式布局。我还使用CSS动画和过渡效果来增强用户体验。
网站后台:使用nodejs搭建http接口,数据库选择mysql或者mongodb。
技术选型:我选择Python作为爬虫的编程语言,因为它具有强大的网络请求和数据解析能力。我使用了Requests库发送HTTP请求,并使用BeautifulSoup,xpath,正则表达式解析和提取网页数据。
网络请求和数据解析:我使用Requests库发送GET或POST请求,并设置适当的请求头,以模拟浏览器的行为提取所需的信息。
反爬虫策略:在一些网站上,我遇到了反爬虫机制,如IP封禁和验证码。为了应对这些问题,我使用了代理IP池来隐藏我的真实IP地址,并设置了随机的User-Agent头信息。此外,我还限制了爬取速度以避免过多的请求对目标网站造成负担。
前端开发经验:
技术选型:我使用了HTML、CSS和JavaScript进行前端开发,以创建交互式和响应式的网页。我还使用了vue框架来快速构建页面结构和样式。
页面设计和布局:我设计了清晰的页面结构,并使用CSS进行样式设置,包括字体、颜色、边距和响应式布局。我还使用CSS动画和过渡效果来增强用户体验。
网站后台:使用nodejs搭建http接口,数据库选择mysql或者mongodb。
案例展示 全部案例 >


岸Filda
研发测试 · 1年经验 · 广东华展家具制造有限公司
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
前端开发方面的技术:
HTML:我熟练使用HTML语言构建网页结构,包括使用各种标签和属性来定义页面内容和布局。
CSS:我掌握CSS样式表语言,能够使用选择器、样式规则和属性来美化网页,包括调整字体、颜色、布局和动画效果等。
JavaScript:我具备良好的JavaScript编程能力,能够使用该语言实现交互功能、响应式设计和动态效果等,提升用户体验。
前端框架:我熟悉流行的前端框架,如Bootstrap、React和Vue.js,能够利用它们快速构建响应式、可扩展的网页应用程序。
Express.js:我掌握Express.js框架,能够搭建灵活且高效的Node.js服务器。
数据库:我熟悉与Node.js集成的各种数据库,如MongoDB和MySQL,能够进行数据存储和检索操作。
API开发:我具备设计和实现RESTful API的能力,能够处理HTTP请求和响应,进行数据交互。
安全性:我了解如何处理用户身份验证、数据加密和防止常见的网络攻击等方面的安全问题。
爬虫方面的技术:
编程语言:我精通Python编程语言,用它来编写高效的爬虫代码。
网络请求:我使用Python的Requests库发送HTTP请求,并设置请求头、Cookie和Session,以模拟浏览器行为。
数据解析:我熟悉使用Python的xpath库和正则表达式来解析HTML、XML和JSON等类型的数据,并提取所需的信息。
数据存储:我能够将爬取到的数据保存到CSV,EXCEL文件、数据库或其他数据存储系统中,例如使用Python的Pandas库进行数据处理和清洗。
HTML:我熟练使用HTML语言构建网页结构,包括使用各种标签和属性来定义页面内容和布局。
CSS:我掌握CSS样式表语言,能够使用选择器、样式规则和属性来美化网页,包括调整字体、颜色、布局和动画效果等。
JavaScript:我具备良好的JavaScript编程能力,能够使用该语言实现交互功能、响应式设计和动态效果等,提升用户体验。
前端框架:我熟悉流行的前端框架,如Bootstrap、React和Vue.js,能够利用它们快速构建响应式、可扩展的网页应用程序。
Express.js:我掌握Express.js框架,能够搭建灵活且高效的Node.js服务器。
数据库:我熟悉与Node.js集成的各种数据库,如MongoDB和MySQL,能够进行数据存储和检索操作。
API开发:我具备设计和实现RESTful API的能力,能够处理HTTP请求和响应,进行数据交互。
安全性:我了解如何处理用户身份验证、数据加密和防止常见的网络攻击等方面的安全问题。
爬虫方面的技术:
编程语言:我精通Python编程语言,用它来编写高效的爬虫代码。
网络请求:我使用Python的Requests库发送HTTP请求,并设置请求头、Cookie和Session,以模拟浏览器行为。
数据解析:我熟悉使用Python的xpath库和正则表达式来解析HTML、XML和JSON等类型的数据,并提取所需的信息。
数据存储:我能够将爬取到的数据保存到CSV,EXCEL文件、数据库或其他数据存储系统中,例如使用Python的Pandas库进行数据处理和清洗。
项目经验
爬虫经验:
技术选型:我选择Python作为爬虫的编程语言,因为它具有强大的网络请求和数据解析能力。我使用了Requests库发送HTTP请求,并使用BeautifulSoup,xpath,正则表达式解析和提取网页数据。
网络请求和数据解析:我使用Requests库发送GET或POST请求,并设置适当的请求头,以模拟浏览器的行为提取所需的信息。
反爬虫策略:在一些网站上,我遇到了反爬虫机制,如IP封禁和验证码。为了应对这些问题,我使用了代理IP池来隐藏我的真实IP地址,并设置了随机的User-Agent头信息。此外,我还限制了爬取速度以避免过多的请求对目标网站造成负担。
前端开发经验:
技术选型:我使用了HTML、CSS和JavaScript进行前端开发,以创建交互式和响应式的网页。我还使用了vue框架来快速构建页面结构和样式。
页面设计和布局:我设计了清晰的页面结构,并使用CSS进行样式设置,包括字体、颜色、边距和响应式布局。我还使用CSS动画和过渡效果来增强用户体验。
网站后台:使用nodejs搭建http接口,数据库选择mysql或者mongodb。
技术选型:我选择Python作为爬虫的编程语言,因为它具有强大的网络请求和数据解析能力。我使用了Requests库发送HTTP请求,并使用BeautifulSoup,xpath,正则表达式解析和提取网页数据。
网络请求和数据解析:我使用Requests库发送GET或POST请求,并设置适当的请求头,以模拟浏览器的行为提取所需的信息。
反爬虫策略:在一些网站上,我遇到了反爬虫机制,如IP封禁和验证码。为了应对这些问题,我使用了代理IP池来隐藏我的真实IP地址,并设置了随机的User-Agent头信息。此外,我还限制了爬取速度以避免过多的请求对目标网站造成负担。
前端开发经验:
技术选型:我使用了HTML、CSS和JavaScript进行前端开发,以创建交互式和响应式的网页。我还使用了vue框架来快速构建页面结构和样式。
页面设计和布局:我设计了清晰的页面结构,并使用CSS进行样式设置,包括字体、颜色、边距和响应式布局。我还使用CSS动画和过渡效果来增强用户体验。
网站后台:使用nodejs搭建http接口,数据库选择mysql或者mongodb。

 立即沟通


