倒数NO.1
爬虫工程师
sao · 3年经验
日薪:
¥500/8h
地点:
重庆 全区
时间:
下班后周六周日可工作日驻场(离职原因)可工作日驻场(自由职业原因)
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
1、熟练举握requests,scrapy,scrapy·redis模块发送请求,获取响应后处理网页数据,熟练构建分布式爬
虫,Linux下的定时启动爬虫
2、熟练使用正则表达式xpath、Selenium、提取网页元素
3,熟练使用requests和scrapy。selenium的模拟登录
4、熟练对各种加密算法进行破解
熟练使用mysqlredis、MongoDB的增删改查
虫,Linux下的定时启动爬虫
2、熟练使用正则表达式xpath、Selenium、提取网页元素
3,熟练使用requests和scrapy。selenium的模拟登录
4、熟练对各种加密算法进行破解
熟练使用mysqlredis、MongoDB的增删改查
项目经验
拉勾网:
爬取拉勾网一二线城市U1设计,前端、php、python、Java、数据分析、人工智能等公司的名称、地址、网址、规模、招聘需求、新资状况等
遇到问题及解决方案如下:
1、分析目标网站真实request地址和response内容,使用代理试水网站反爬中圾别,检测是否有投毒数据.
2、使用Selenium+PhantomJS模拟登陆获取cookie信是,携带cookie访向网页内器,采用隧道动态io代理和随机USER-AGENT反反爬
3、爬取量量较大,用scrapy-redis爬取,因为该框架实现url和数据去重、持久化,通过MD5加密,实现网页数
据的去重和更新,构建增量式爬中程序
4、数据保存在json字符串中,转化成python字典,提取数据
5、保存数据到MongoDB和CSV
6。使用logging模块编号监控程序进行爬中监控,并根据日期定向输出日志到log文件
瓜子二手车:
1、瓜子二手车有反爬,需携市cookie进行访问
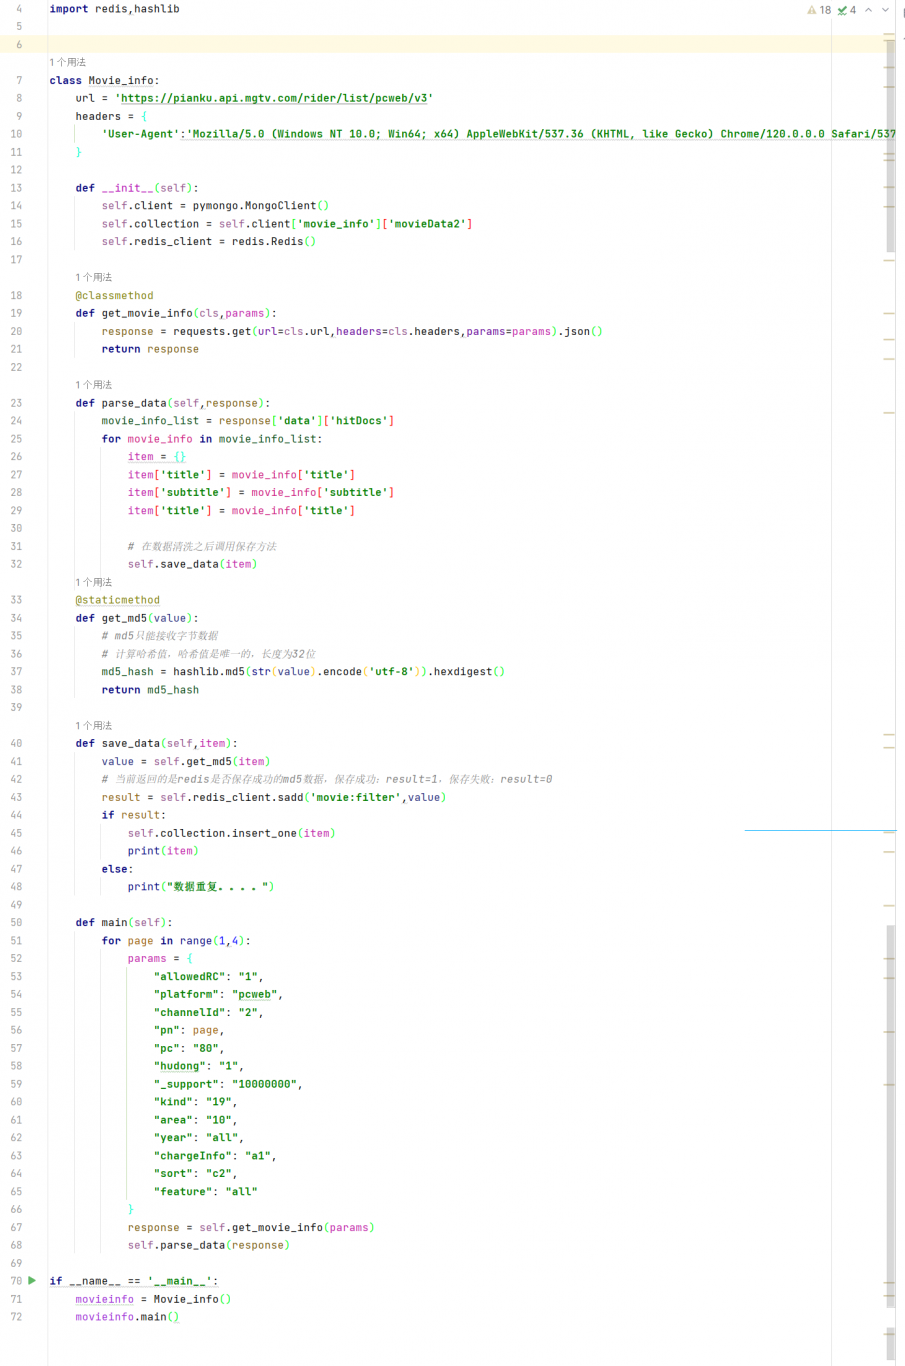
2、requests底层没有封装ur去重的方法,手动实现利用redis集合构造url去重(注:如果公司没有redis可以利用python集台set,保存请求的url,再读取set中的内容马入本地文件,后面每次运行摩的时候,再将本地文件中的url读取到set集合中,可以实现简易的url去重》
3、选择md5加密,尽可能少的占用redis内存
4、请求中加延时,考虑网站能否打开和打开时间问题,一般需要加异常判断、超时。retny等减少报错
5、增量式爬虫,将数据保存到数据库,对重复的字段对应的数据更新操作
6、构建USER-AGENT池,使用随机代理,随机IP莱用阿布云动态IP
7、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件
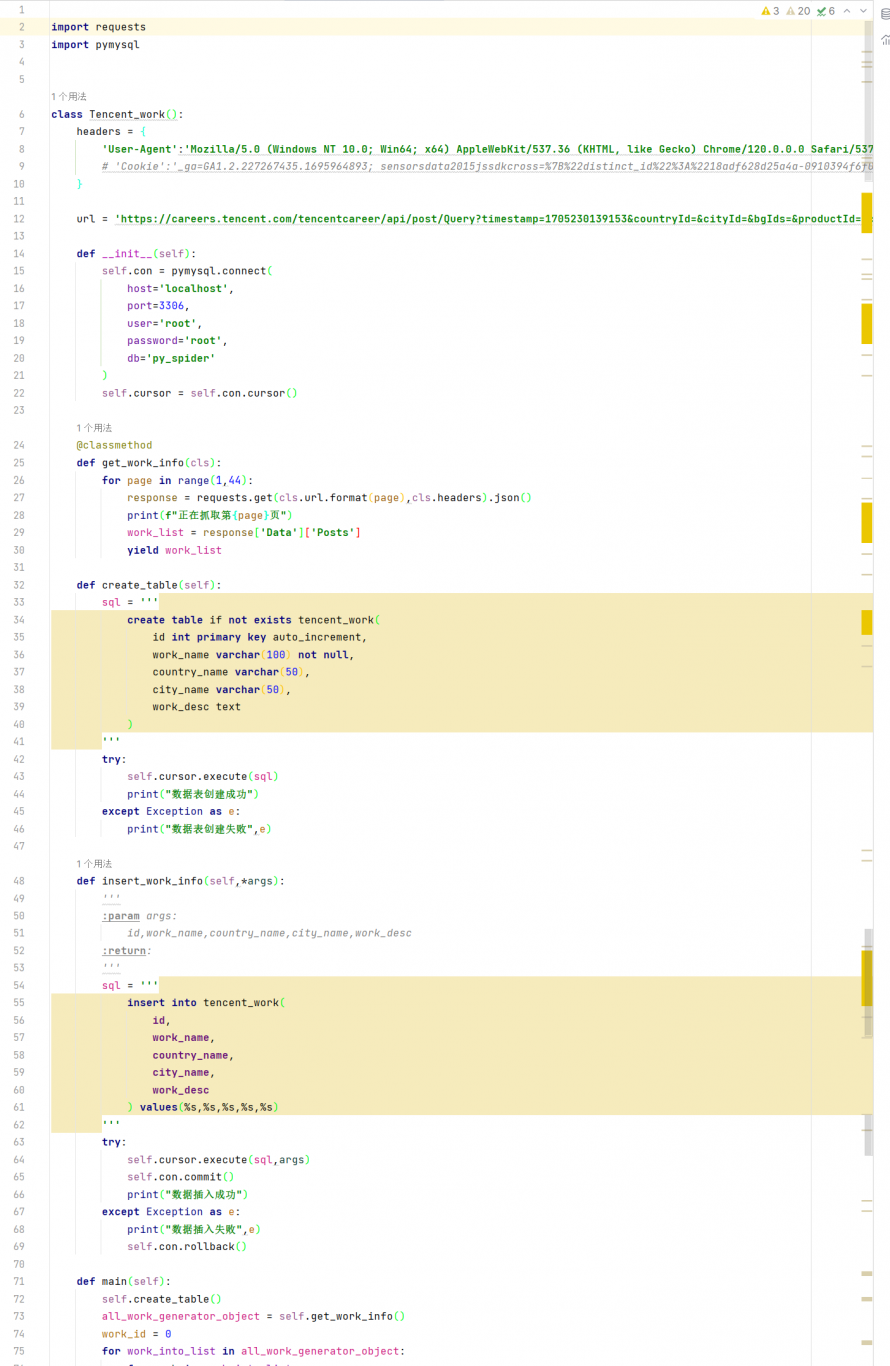
腾讯招聘,阿里招聘、百度招聘:
1、爬取量蚊大。用scrapy-redis爬取,因为该框架实现ur和数据去重、持久化、分布式比效方便
2、采用隧道动态ip进行采集数据
3、需要抓包并查找到对应的response,
4、数据保存在json字符串中,转化成python字典,提取数据
5、分别保存数据到MongoDB和Mysql
6、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件
案例展示 全部案例 >
倒数NO.1
爬虫工程师 · 3年经验 · sao
0
累计接单
0
用户评价
1
被收藏
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
1、熟练举握requests,scrapy,scrapy·redis模块发送请求,获取响应后处理网页数据,熟练构建分布式爬
虫,Linux下的定时启动爬虫
2、熟练使用正则表达式xpath、Selenium、提取网页元素
3,熟练使用requests和scrapy。selenium的模拟登录
4、熟练对各种加密算法进行破解
熟练使用mysqlredis、MongoDB的增删改查
虫,Linux下的定时启动爬虫
2、熟练使用正则表达式xpath、Selenium、提取网页元素
3,熟练使用requests和scrapy。selenium的模拟登录
4、熟练对各种加密算法进行破解
熟练使用mysqlredis、MongoDB的增删改查
项目经验
拉勾网:
爬取拉勾网一二线城市U1设计,前端、php、python、Java、数据分析、人工智能等公司的名称、地址、网址、规模、招聘需求、新资状况等
遇到问题及解决方案如下:
1、分析目标网站真实request地址和response内容,使用代理试水网站反爬中圾别,检测是否有投毒数据.
2、使用Selenium+PhantomJS模拟登陆获取cookie信是,携带cookie访向网页内器,采用隧道动态io代理和随机USER-AGENT反反爬
3、爬取量量较大,用scrapy-redis爬取,因为该框架实现url和数据去重、持久化,通过MD5加密,实现网页数
据的去重和更新,构建增量式爬中程序
4、数据保存在json字符串中,转化成python字典,提取数据
5、保存数据到MongoDB和CSV
6。使用logging模块编号监控程序进行爬中监控,并根据日期定向输出日志到log文件
瓜子二手车:
1、瓜子二手车有反爬,需携市cookie进行访问
2、requests底层没有封装ur去重的方法,手动实现利用redis集合构造url去重(注:如果公司没有redis可以利用python集台set,保存请求的url,再读取set中的内容马入本地文件,后面每次运行摩的时候,再将本地文件中的url读取到set集合中,可以实现简易的url去重》
3、选择md5加密,尽可能少的占用redis内存
4、请求中加延时,考虑网站能否打开和打开时间问题,一般需要加异常判断、超时。retny等减少报错
5、增量式爬虫,将数据保存到数据库,对重复的字段对应的数据更新操作
6、构建USER-AGENT池,使用随机代理,随机IP莱用阿布云动态IP
7、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件
腾讯招聘,阿里招聘、百度招聘:
1、爬取量蚊大。用scrapy-redis爬取,因为该框架实现ur和数据去重、持久化、分布式比效方便
2、采用隧道动态ip进行采集数据
3、需要抓包并查找到对应的response,
4、数据保存在json字符串中,转化成python字典,提取数据
5、分别保存数据到MongoDB和Mysql
6、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件
爬取拉勾网一二线城市U1设计,前端、php、python、Java、数据分析、人工智能等公司的名称、地址、网址、规模、招聘需求、新资状况等
遇到问题及解决方案如下:
1、分析目标网站真实request地址和response内容,使用代理试水网站反爬中圾别,检测是否有投毒数据.
2、使用Selenium+PhantomJS模拟登陆获取cookie信是,携带cookie访向网页内器,采用隧道动态io代理和随机USER-AGENT反反爬
3、爬取量量较大,用scrapy-redis爬取,因为该框架实现url和数据去重、持久化,通过MD5加密,实现网页数
据的去重和更新,构建增量式爬中程序
4、数据保存在json字符串中,转化成python字典,提取数据
5、保存数据到MongoDB和CSV
6。使用logging模块编号监控程序进行爬中监控,并根据日期定向输出日志到log文件
瓜子二手车:
1、瓜子二手车有反爬,需携市cookie进行访问
2、requests底层没有封装ur去重的方法,手动实现利用redis集合构造url去重(注:如果公司没有redis可以利用python集台set,保存请求的url,再读取set中的内容马入本地文件,后面每次运行摩的时候,再将本地文件中的url读取到set集合中,可以实现简易的url去重》
3、选择md5加密,尽可能少的占用redis内存
4、请求中加延时,考虑网站能否打开和打开时间问题,一般需要加异常判断、超时。retny等减少报错
5、增量式爬虫,将数据保存到数据库,对重复的字段对应的数据更新操作
6、构建USER-AGENT池,使用随机代理,随机IP莱用阿布云动态IP
7、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件
腾讯招聘,阿里招聘、百度招聘:
1、爬取量蚊大。用scrapy-redis爬取,因为该框架实现ur和数据去重、持久化、分布式比效方便
2、采用隧道动态ip进行采集数据
3、需要抓包并查找到对应的response,
4、数据保存在json字符串中,转化成python字典,提取数据
5、分别保存数据到MongoDB和Mysql
6、使用logging模块编写监控程序进行爬虫监控,并根据日期定向输出日志到log文件

 立即沟通


