王亮
爬虫工程师
雁丰投资 · 4年经验
日薪:
¥500/8h
地点:
上海 浦东
时间:
下班后周六周日
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
熟练掌握 Requests、Selenium、Scrapy 等爬虫工具,掌握正则表达式、Xpath 提取网页资源方法
熟悉 MySQL、Redis、MongoDB 等数据库的使用,熟练构建分布式爬虫, Linux 下的定时启动爬虫
熟悉反爬技术,如伪造 User-Agent 、批量 IP 代理池、验证码识别、模拟登陆、高并发请求等
熟悉 MySQL、Redis、MongoDB 等数据库的使用,熟练构建分布式爬虫, Linux 下的定时启动爬虫
熟悉反爬技术,如伪造 User-Agent 、批量 IP 代理池、验证码识别、模拟登陆、高并发请求等
项目经验
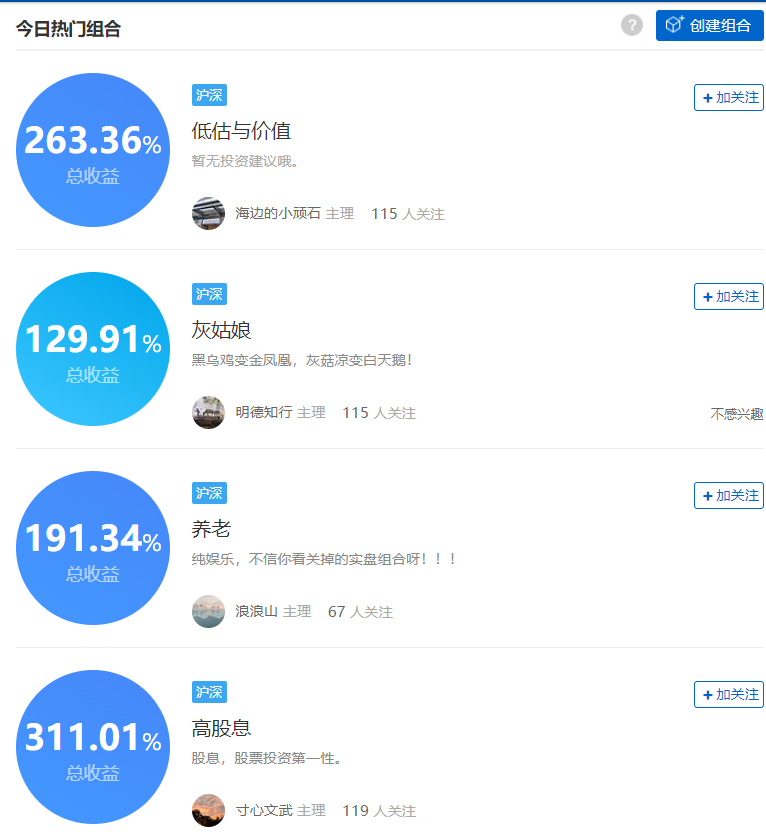
爬取雪球网站的热门持仓组合及其变动等
遇到问题及解决方案如下:
1. 爬取量大,需要使用 Scrapy-Redis 实现分布式爬虫进行高并发爬取
2. IP 封锁,需要维护代理 IP 池并定期检测 IP 的可用性
3. 账号限制,需要维护 Cookie 池进行模拟登陆
爬取上交所、深交所官网的股票、指数、ETF 的基本信息、行情数据等
责任描述:编写爬虫程序,设计应对反爬策略,数据清洗,分表存储,维护代理 IP池
技术手段:
1. 网页内容异步加载,需要分析 Ajax 请求,并用 Requests 抓取内容
2. 实现代理 IP池,定期检测 IP 的可用性,维护代理 IP 池的质量
3. 通过正则表达式、Xpath 等提取网页中需要的内容
4. 通过 PyMySQL 操作数据库,保存字典数据
遇到问题及解决方案如下:
1. 爬取量大,需要使用 Scrapy-Redis 实现分布式爬虫进行高并发爬取
2. IP 封锁,需要维护代理 IP 池并定期检测 IP 的可用性
3. 账号限制,需要维护 Cookie 池进行模拟登陆
爬取上交所、深交所官网的股票、指数、ETF 的基本信息、行情数据等
责任描述:编写爬虫程序,设计应对反爬策略,数据清洗,分表存储,维护代理 IP池
技术手段:
1. 网页内容异步加载,需要分析 Ajax 请求,并用 Requests 抓取内容
2. 实现代理 IP池,定期检测 IP 的可用性,维护代理 IP 池的质量
3. 通过正则表达式、Xpath 等提取网页中需要的内容
4. 通过 PyMySQL 操作数据库,保存字典数据


王亮
爬虫工程师 · 4年经验 · 雁丰投资
0
累计接单
0
用户评价
1
被收藏
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
熟练掌握 Requests、Selenium、Scrapy 等爬虫工具,掌握正则表达式、Xpath 提取网页资源方法
熟悉 MySQL、Redis、MongoDB 等数据库的使用,熟练构建分布式爬虫, Linux 下的定时启动爬虫
熟悉反爬技术,如伪造 User-Agent 、批量 IP 代理池、验证码识别、模拟登陆、高并发请求等
熟悉 MySQL、Redis、MongoDB 等数据库的使用,熟练构建分布式爬虫, Linux 下的定时启动爬虫
熟悉反爬技术,如伪造 User-Agent 、批量 IP 代理池、验证码识别、模拟登陆、高并发请求等
项目经验
爬取雪球网站的热门持仓组合及其变动等
遇到问题及解决方案如下:
1. 爬取量大,需要使用 Scrapy-Redis 实现分布式爬虫进行高并发爬取
2. IP 封锁,需要维护代理 IP 池并定期检测 IP 的可用性
3. 账号限制,需要维护 Cookie 池进行模拟登陆
爬取上交所、深交所官网的股票、指数、ETF 的基本信息、行情数据等
责任描述:编写爬虫程序,设计应对反爬策略,数据清洗,分表存储,维护代理 IP池
技术手段:
1. 网页内容异步加载,需要分析 Ajax 请求,并用 Requests 抓取内容
2. 实现代理 IP池,定期检测 IP 的可用性,维护代理 IP 池的质量
3. 通过正则表达式、Xpath 等提取网页中需要的内容
4. 通过 PyMySQL 操作数据库,保存字典数据
遇到问题及解决方案如下:
1. 爬取量大,需要使用 Scrapy-Redis 实现分布式爬虫进行高并发爬取
2. IP 封锁,需要维护代理 IP 池并定期检测 IP 的可用性
3. 账号限制,需要维护 Cookie 池进行模拟登陆
爬取上交所、深交所官网的股票、指数、ETF 的基本信息、行情数据等
责任描述:编写爬虫程序,设计应对反爬策略,数据清洗,分表存储,维护代理 IP池
技术手段:
1. 网页内容异步加载,需要分析 Ajax 请求,并用 Requests 抓取内容
2. 实现代理 IP池,定期检测 IP 的可用性,维护代理 IP 池的质量
3. 通过正则表达式、Xpath 等提取网页中需要的内容
4. 通过 PyMySQL 操作数据库,保存字典数据

 立即沟通


