System
运维开发工程师
蚂蚁集团 · 8年经验
日薪:
¥500/8h
地点:
杭州 余杭
时间:
下班后周六周日可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1. 熟悉使用 python 和 go 语言
2. 熟悉 linux 系统知识和命令行操作技能,了解 linux namespace、cgroup 等容器技术
3. 熟悉 docker、containerd 等容器化技术,能够熟练构建、管理和发布容器
4. 熟悉 k8s 各组件工作原理、informer 机制等,掌握 client-go、kubebuilder 等常用 k8s 开发工具
5. 熟悉 devops 理念和工具,如 gitlab ci、jenkins、argocd、ansible 等
6. 熟悉 prometheus、thanos、zabbix、grafana 等常用监控相关工具
7. 熟悉阿里云、腾讯云、华为云等各大云平台
2. 熟悉 linux 系统知识和命令行操作技能,了解 linux namespace、cgroup 等容器技术
3. 熟悉 docker、containerd 等容器化技术,能够熟练构建、管理和发布容器
4. 熟悉 k8s 各组件工作原理、informer 机制等,掌握 client-go、kubebuilder 等常用 k8s 开发工具
5. 熟悉 devops 理念和工具,如 gitlab ci、jenkins、argocd、ansible 等
6. 熟悉 prometheus、thanos、zabbix、grafana 等常用监控相关工具
7. 熟悉阿里云、腾讯云、华为云等各大云平台
项目经验
基于 Thanos 架构下的多集群 Prometheus 监控系统:
该监控系统可以横跨多个 prometheus 集群进行监控,且支持对多个集群的数据进行查询和聚合。存储方面支持长期存储,可将 prometheus 数据存储到廉价的对象存储中,且监控数据通过多副本保证高可用。通过k8s endpoints以及consul实现监控目标自动发现。告警则接入飞书机器人实现基于命名空间的告警到人。
工作内容:
1. 整体技术架构选型及部署实施;
2. 使用 Go 开发 node controller,在节点频繁变更下,实现 kubelet endpoints 的自动更新;
3. 配置 hashmod 解决 prometheus 无法支撑单个大集群以及多副本 prometheus 重复拉取指标的问题;
4. 使用 Go 开发 alertmanager webhook ,并基于飞书机器人配置自动重载;
5. 编写 alertmannager 和 thanso ruler 告警规则以及 prometheus record 优化查询语句。
项目成果:
1. 解决多套集群部署多套监控系统的问题,节约计算资源以及人力维护成本;
2. 实现 k8s 集群内外部监控 target 自动发现,无硬编码 target;
3. 保证了大体量集群下 prometheus 的高可用,以及数据的完整性;
4. 告警直到相关责任人,推进问题响应速度。
2000+ 节点k8s 集群搭建及维护:
该集群规模大,可用性要求高。通过 ansible 自动化部署整个集群,通过调整 etcd 和 apiserver 相关参数,使用 trimaran 替换原 k8s 调度器,优化 apiserver 缓存大小,调整客户端 list 使用方式等手段提高集群的高可用性。
工作内容:
1. 使用 ansible 自动化部署集群;
2. 调整 etcd db 容量,数据盘直接使用本地 ssd ,自动压缩历史数据和定期碎片清理,优化心跳间隔和选举超时时间;
3. 将原 k8s 调度器替换为基于实时负载的调度器;
4. 使用 Go 开发基于 webhook 的统一认证服务。
项目成果:
1. 快速完成 2000+ 节点的 k8s 集群搭建;
2. 保证了 etcd 集群零宕机;
3. 替换默认 k8s 调度器,解决节点资源使用不均衡问题;
4. 将 k8s 认证接入企业统一认证,保证集群安全性。
该监控系统可以横跨多个 prometheus 集群进行监控,且支持对多个集群的数据进行查询和聚合。存储方面支持长期存储,可将 prometheus 数据存储到廉价的对象存储中,且监控数据通过多副本保证高可用。通过k8s endpoints以及consul实现监控目标自动发现。告警则接入飞书机器人实现基于命名空间的告警到人。
工作内容:
1. 整体技术架构选型及部署实施;
2. 使用 Go 开发 node controller,在节点频繁变更下,实现 kubelet endpoints 的自动更新;
3. 配置 hashmod 解决 prometheus 无法支撑单个大集群以及多副本 prometheus 重复拉取指标的问题;
4. 使用 Go 开发 alertmanager webhook ,并基于飞书机器人配置自动重载;
5. 编写 alertmannager 和 thanso ruler 告警规则以及 prometheus record 优化查询语句。
项目成果:
1. 解决多套集群部署多套监控系统的问题,节约计算资源以及人力维护成本;
2. 实现 k8s 集群内外部监控 target 自动发现,无硬编码 target;
3. 保证了大体量集群下 prometheus 的高可用,以及数据的完整性;
4. 告警直到相关责任人,推进问题响应速度。
2000+ 节点k8s 集群搭建及维护:
该集群规模大,可用性要求高。通过 ansible 自动化部署整个集群,通过调整 etcd 和 apiserver 相关参数,使用 trimaran 替换原 k8s 调度器,优化 apiserver 缓存大小,调整客户端 list 使用方式等手段提高集群的高可用性。
工作内容:
1. 使用 ansible 自动化部署集群;
2. 调整 etcd db 容量,数据盘直接使用本地 ssd ,自动压缩历史数据和定期碎片清理,优化心跳间隔和选举超时时间;
3. 将原 k8s 调度器替换为基于实时负载的调度器;
4. 使用 Go 开发基于 webhook 的统一认证服务。
项目成果:
1. 快速完成 2000+ 节点的 k8s 集群搭建;
2. 保证了 etcd 集群零宕机;
3. 替换默认 k8s 调度器,解决节点资源使用不均衡问题;
4. 将 k8s 认证接入企业统一认证,保证集群安全性。
System
运维开发工程师 · 8年经验 · 蚂蚁集团
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1. 熟悉使用 python 和 go 语言
2. 熟悉 linux 系统知识和命令行操作技能,了解 linux namespace、cgroup 等容器技术
3. 熟悉 docker、containerd 等容器化技术,能够熟练构建、管理和发布容器
4. 熟悉 k8s 各组件工作原理、informer 机制等,掌握 client-go、kubebuilder 等常用 k8s 开发工具
5. 熟悉 devops 理念和工具,如 gitlab ci、jenkins、argocd、ansible 等
6. 熟悉 prometheus、thanos、zabbix、grafana 等常用监控相关工具
7. 熟悉阿里云、腾讯云、华为云等各大云平台
2. 熟悉 linux 系统知识和命令行操作技能,了解 linux namespace、cgroup 等容器技术
3. 熟悉 docker、containerd 等容器化技术,能够熟练构建、管理和发布容器
4. 熟悉 k8s 各组件工作原理、informer 机制等,掌握 client-go、kubebuilder 等常用 k8s 开发工具
5. 熟悉 devops 理念和工具,如 gitlab ci、jenkins、argocd、ansible 等
6. 熟悉 prometheus、thanos、zabbix、grafana 等常用监控相关工具
7. 熟悉阿里云、腾讯云、华为云等各大云平台
项目经验
基于 Thanos 架构下的多集群 Prometheus 监控系统:
该监控系统可以横跨多个 prometheus 集群进行监控,且支持对多个集群的数据进行查询和聚合。存储方面支持长期存储,可将 prometheus 数据存储到廉价的对象存储中,且监控数据通过多副本保证高可用。通过k8s endpoints以及consul实现监控目标自动发现。告警则接入飞书机器人实现基于命名空间的告警到人。
工作内容:
1. 整体技术架构选型及部署实施;
2. 使用 Go 开发 node controller,在节点频繁变更下,实现 kubelet endpoints 的自动更新;
3. 配置 hashmod 解决 prometheus 无法支撑单个大集群以及多副本 prometheus 重复拉取指标的问题;
4. 使用 Go 开发 alertmanager webhook ,并基于飞书机器人配置自动重载;
5. 编写 alertmannager 和 thanso ruler 告警规则以及 prometheus record 优化查询语句。
项目成果:
1. 解决多套集群部署多套监控系统的问题,节约计算资源以及人力维护成本;
2. 实现 k8s 集群内外部监控 target 自动发现,无硬编码 target;
3. 保证了大体量集群下 prometheus 的高可用,以及数据的完整性;
4. 告警直到相关责任人,推进问题响应速度。
2000+ 节点k8s 集群搭建及维护:
该集群规模大,可用性要求高。通过 ansible 自动化部署整个集群,通过调整 etcd 和 apiserver 相关参数,使用 trimaran 替换原 k8s 调度器,优化 apiserver 缓存大小,调整客户端 list 使用方式等手段提高集群的高可用性。
工作内容:
1. 使用 ansible 自动化部署集群;
2. 调整 etcd db 容量,数据盘直接使用本地 ssd ,自动压缩历史数据和定期碎片清理,优化心跳间隔和选举超时时间;
3. 将原 k8s 调度器替换为基于实时负载的调度器;
4. 使用 Go 开发基于 webhook 的统一认证服务。
项目成果:
1. 快速完成 2000+ 节点的 k8s 集群搭建;
2. 保证了 etcd 集群零宕机;
3. 替换默认 k8s 调度器,解决节点资源使用不均衡问题;
4. 将 k8s 认证接入企业统一认证,保证集群安全性。
该监控系统可以横跨多个 prometheus 集群进行监控,且支持对多个集群的数据进行查询和聚合。存储方面支持长期存储,可将 prometheus 数据存储到廉价的对象存储中,且监控数据通过多副本保证高可用。通过k8s endpoints以及consul实现监控目标自动发现。告警则接入飞书机器人实现基于命名空间的告警到人。
工作内容:
1. 整体技术架构选型及部署实施;
2. 使用 Go 开发 node controller,在节点频繁变更下,实现 kubelet endpoints 的自动更新;
3. 配置 hashmod 解决 prometheus 无法支撑单个大集群以及多副本 prometheus 重复拉取指标的问题;
4. 使用 Go 开发 alertmanager webhook ,并基于飞书机器人配置自动重载;
5. 编写 alertmannager 和 thanso ruler 告警规则以及 prometheus record 优化查询语句。
项目成果:
1. 解决多套集群部署多套监控系统的问题,节约计算资源以及人力维护成本;
2. 实现 k8s 集群内外部监控 target 自动发现,无硬编码 target;
3. 保证了大体量集群下 prometheus 的高可用,以及数据的完整性;
4. 告警直到相关责任人,推进问题响应速度。
2000+ 节点k8s 集群搭建及维护:
该集群规模大,可用性要求高。通过 ansible 自动化部署整个集群,通过调整 etcd 和 apiserver 相关参数,使用 trimaran 替换原 k8s 调度器,优化 apiserver 缓存大小,调整客户端 list 使用方式等手段提高集群的高可用性。
工作内容:
1. 使用 ansible 自动化部署集群;
2. 调整 etcd db 容量,数据盘直接使用本地 ssd ,自动压缩历史数据和定期碎片清理,优化心跳间隔和选举超时时间;
3. 将原 k8s 调度器替换为基于实时负载的调度器;
4. 使用 Go 开发基于 webhook 的统一认证服务。
项目成果:
1. 快速完成 2000+ 节点的 k8s 集群搭建;
2. 保证了 etcd 集群零宕机;
3. 替换默认 k8s 调度器,解决节点资源使用不均衡问题;
4. 将 k8s 认证接入企业统一认证,保证集群安全性。
案例展示
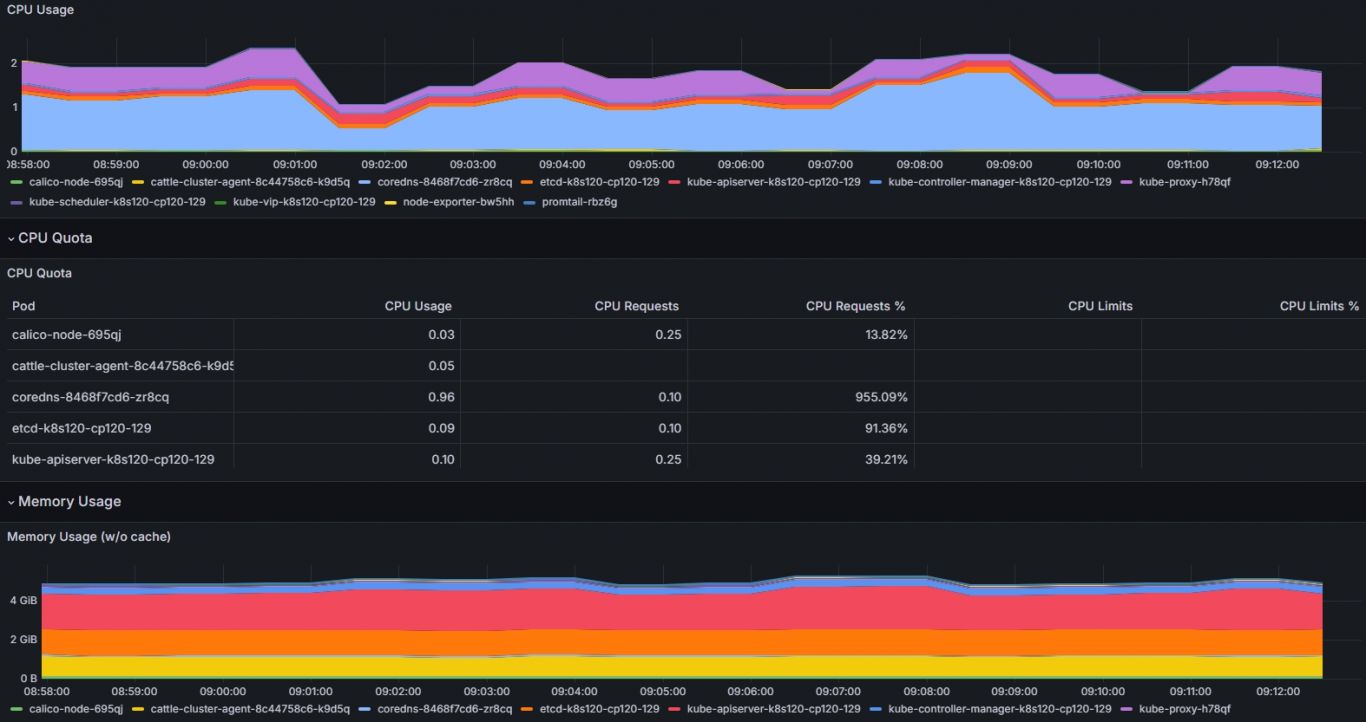
Prometheus+Thano监控系统
1. 负责整体技术架构选型及部署实施 2. 使用 Go 开发 node controller,实现 kubelet endpoints 的自动更 3. 配置 hashmod 解决 prometheus 无法支撑单个大集群以及多副本 prometheus 重复拉取指标的问题
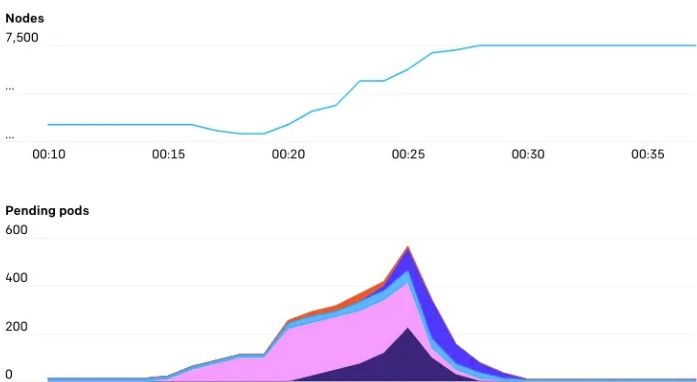
2000+节点k8s集群搭建及维护
1. 负责使用 ansible 自动化部署集群 2. 负责优化 etcd 性能,数据盘直接使用本地 ssd,自动压缩历史数据和定期碎片清理,优化心跳间隔和选举超时时间 3. 将原 k8s 调度器替换为基于实时负载的调度器 4. 使用 Go 开发基于 webhook 的统一认

 立即沟通


