Sunshine.
Python
华为云计算 · 10年经验
日薪:
¥1000/8h
地点:
重庆 全区
时间:
下班后周六周日可工作日远程可工作日驻场(自由职业原因)
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
本人常年从事Python行业,对开发极为熟悉。
本人所掌握Python多种技术。简单举例:
数据处理与分析。
1.1 NumPy
• 数组操作:掌握NumPy数组的创建、操作、索引和切片。
• 数学函数:了解常用的数学函数和线性代数操作。
2.2 Pandas
• 数据结构:理解Series和DataFrame的基本概念和使用。
• 数据处理:掌握数据清洗、合并、分组、透视表等操作。
2.3 Matplotlib和Seaborn
• 数据可视化:了解如何使用Matplotlib和Seaborn进行数据可视化,创建各种图表(如折线图、柱状图、散点图、热力图等)。
3. Web开发
3.1 Flask
• 基本概念:理解Flask框架的基本结构和路由机制。
• 模板引擎:掌握Jinja2模板引擎的使用。
• 表单处理:了解如何处理用户输入和表单验证。
3.2 Django
• 项目结构:熟悉Django项目的基本结构和应用管理。
• 模型层:理解Django ORM的使用,进行数据库操作。
• 视图层与模板层:掌握视图函数、通用视图和模板系统的使用。
4. 自动化与脚本编写
4.1 自动化任务
• OS模块:了解操作系统接口的使用,如文件操作、目录管理等。
• Shutil模块:掌握高级文件操作,如文件复制、移动、删除等。
• Subprocess模块:熟悉如何在Python中执行外部命令和脚本。
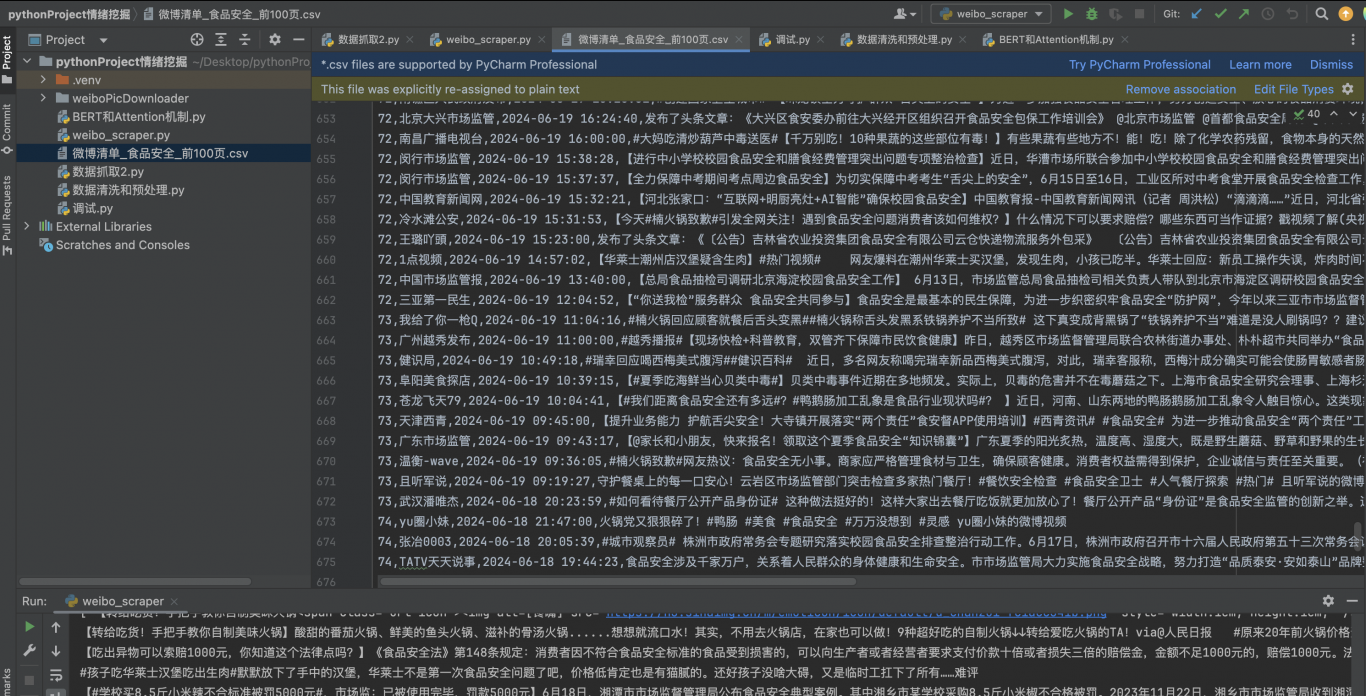
4.2 Web Scraping
• Requests:掌握使用Requests库进行HTTP请求。
• BeautifulSoup:理解如何使用BeautifulSoup解析和提取网页内容。
• Scrapy:熟悉使用Scrapy进行复杂的网页爬取和数据提取。
5. 数据库
5.1 SQL
• 基本操作:掌握SQL的基本操作,如查询、插入、更新、删除等。
• 高级查询:了解复杂查询、联接、子查询、聚合函数等。
5.2 ORM
• SQLAlchemy:熟悉SQLAlchemy库的使用,进行数据库的对象关系映射操作。
6. 测试与调试
6.1 单元测试
• unitte
本人所掌握Python多种技术。简单举例:
数据处理与分析。
1.1 NumPy
• 数组操作:掌握NumPy数组的创建、操作、索引和切片。
• 数学函数:了解常用的数学函数和线性代数操作。
2.2 Pandas
• 数据结构:理解Series和DataFrame的基本概念和使用。
• 数据处理:掌握数据清洗、合并、分组、透视表等操作。
2.3 Matplotlib和Seaborn
• 数据可视化:了解如何使用Matplotlib和Seaborn进行数据可视化,创建各种图表(如折线图、柱状图、散点图、热力图等)。
3. Web开发
3.1 Flask
• 基本概念:理解Flask框架的基本结构和路由机制。
• 模板引擎:掌握Jinja2模板引擎的使用。
• 表单处理:了解如何处理用户输入和表单验证。
3.2 Django
• 项目结构:熟悉Django项目的基本结构和应用管理。
• 模型层:理解Django ORM的使用,进行数据库操作。
• 视图层与模板层:掌握视图函数、通用视图和模板系统的使用。
4. 自动化与脚本编写
4.1 自动化任务
• OS模块:了解操作系统接口的使用,如文件操作、目录管理等。
• Shutil模块:掌握高级文件操作,如文件复制、移动、删除等。
• Subprocess模块:熟悉如何在Python中执行外部命令和脚本。
4.2 Web Scraping
• Requests:掌握使用Requests库进行HTTP请求。
• BeautifulSoup:理解如何使用BeautifulSoup解析和提取网页内容。
• Scrapy:熟悉使用Scrapy进行复杂的网页爬取和数据提取。
5. 数据库
5.1 SQL
• 基本操作:掌握SQL的基本操作,如查询、插入、更新、删除等。
• 高级查询:了解复杂查询、联接、子查询、聚合函数等。
5.2 ORM
• SQLAlchemy:熟悉SQLAlchemy库的使用,进行数据库的对象关系映射操作。
6. 测试与调试
6.1 单元测试
• unitte
项目经验
项目经历
1. 自动化脚本开发
项目描述
开发了多个自动化脚本,旨在简化和加速日常任务,提高工作效率。
技术栈
• 语言:Python
• 库:os、shutil、subprocess、time、datetime等
主要职责
• 编写和优化自动化脚本,实现文件管理、数据处理和系统监控等功能。
• 使用subprocess模块执行系统命令,实现跨平台兼容性。
• 通过定时任务和脚本自动化,减少人工干预,提高工作效率。
2. 基于Python的神经网络
项目描述
开发和训练神经网络模型,用于解决特定的分类和回归问题。
技术栈
• 语言:Python
• 库:TensorFlow、Keras、NumPy、Pandas、Matplotlib
主要职责
• 设计和实现神经网络模型,包括卷积神经网络(CNN)和循环神经网络(RNN)。
• 处理和预处理数据集,进行特征提取和数据增强。
• 使用TensorFlow和Keras进行模型训练、评估和调优。
• 可视化训练过程和结果,分析模型性能并进行优化。
3. 基于Python的SVM机器学习
项目描述
开发基于支持向量机(SVM)的机器学习模型,用于分类和回归任务。
技术栈
• 语言:Python
• 库:scikit-learn、NumPy、Pandas、Matplotlib、Seaborn
主要职责
• 使用scikit-learn库实现SVM模型,处理和分析数据集。
• 进行数据清洗、特征选择和数据标准化,提升模型效果。
• 调整SVM参数,优化模型性能。
• 评估模型的准确性、精确度、召回率和F1得分,并进行模型改进。
4. 爬虫项目
项目描述
开发多个爬虫项目,自动化收集和处理网页数据。
技术栈
• 语言:Python
• 库:Requests、BeautifulSoup、Scrapy、Selenium
主要职责
• 使用Requests库发送HTTP请求,获取网页内容。
• 利用BeautifulSoup解析HTML文档,提取所需信息。
• 通过Scrapy框架构建高效、可扩展的爬虫项目。
• 使用Selenium进行动态网页数据的抓取。
• 处理数据存储和清洗,生成结构化数据文件(如CSV、JSON)。
1. 自动化脚本开发
项目描述
开发了多个自动化脚本,旨在简化和加速日常任务,提高工作效率。
技术栈
• 语言:Python
• 库:os、shutil、subprocess、time、datetime等
主要职责
• 编写和优化自动化脚本,实现文件管理、数据处理和系统监控等功能。
• 使用subprocess模块执行系统命令,实现跨平台兼容性。
• 通过定时任务和脚本自动化,减少人工干预,提高工作效率。
2. 基于Python的神经网络
项目描述
开发和训练神经网络模型,用于解决特定的分类和回归问题。
技术栈
• 语言:Python
• 库:TensorFlow、Keras、NumPy、Pandas、Matplotlib
主要职责
• 设计和实现神经网络模型,包括卷积神经网络(CNN)和循环神经网络(RNN)。
• 处理和预处理数据集,进行特征提取和数据增强。
• 使用TensorFlow和Keras进行模型训练、评估和调优。
• 可视化训练过程和结果,分析模型性能并进行优化。
3. 基于Python的SVM机器学习
项目描述
开发基于支持向量机(SVM)的机器学习模型,用于分类和回归任务。
技术栈
• 语言:Python
• 库:scikit-learn、NumPy、Pandas、Matplotlib、Seaborn
主要职责
• 使用scikit-learn库实现SVM模型,处理和分析数据集。
• 进行数据清洗、特征选择和数据标准化,提升模型效果。
• 调整SVM参数,优化模型性能。
• 评估模型的准确性、精确度、召回率和F1得分,并进行模型改进。
4. 爬虫项目
项目描述
开发多个爬虫项目,自动化收集和处理网页数据。
技术栈
• 语言:Python
• 库:Requests、BeautifulSoup、Scrapy、Selenium
主要职责
• 使用Requests库发送HTTP请求,获取网页内容。
• 利用BeautifulSoup解析HTML文档,提取所需信息。
• 通过Scrapy框架构建高效、可扩展的爬虫项目。
• 使用Selenium进行动态网页数据的抓取。
• 处理数据存储和清洗,生成结构化数据文件(如CSV、JSON)。


Sunshine.
Python · 10年经验 · 华为云计算
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
本人常年从事Python行业,对开发极为熟悉。
本人所掌握Python多种技术。简单举例:
数据处理与分析。
1.1 NumPy
• 数组操作:掌握NumPy数组的创建、操作、索引和切片。
• 数学函数:了解常用的数学函数和线性代数操作。
2.2 Pandas
• 数据结构:理解Series和DataFrame的基本概念和使用。
• 数据处理:掌握数据清洗、合并、分组、透视表等操作。
2.3 Matplotlib和Seaborn
• 数据可视化:了解如何使用Matplotlib和Seaborn进行数据可视化,创建各种图表(如折线图、柱状图、散点图、热力图等)。
3. Web开发
3.1 Flask
• 基本概念:理解Flask框架的基本结构和路由机制。
• 模板引擎:掌握Jinja2模板引擎的使用。
• 表单处理:了解如何处理用户输入和表单验证。
3.2 Django
• 项目结构:熟悉Django项目的基本结构和应用管理。
• 模型层:理解Django ORM的使用,进行数据库操作。
• 视图层与模板层:掌握视图函数、通用视图和模板系统的使用。
4. 自动化与脚本编写
4.1 自动化任务
• OS模块:了解操作系统接口的使用,如文件操作、目录管理等。
• Shutil模块:掌握高级文件操作,如文件复制、移动、删除等。
• Subprocess模块:熟悉如何在Python中执行外部命令和脚本。
4.2 Web Scraping
• Requests:掌握使用Requests库进行HTTP请求。
• BeautifulSoup:理解如何使用BeautifulSoup解析和提取网页内容。
• Scrapy:熟悉使用Scrapy进行复杂的网页爬取和数据提取。
5. 数据库
5.1 SQL
• 基本操作:掌握SQL的基本操作,如查询、插入、更新、删除等。
• 高级查询:了解复杂查询、联接、子查询、聚合函数等。
5.2 ORM
• SQLAlchemy:熟悉SQLAlchemy库的使用,进行数据库的对象关系映射操作。
6. 测试与调试
6.1 单元测试
• unitte
本人所掌握Python多种技术。简单举例:
数据处理与分析。
1.1 NumPy
• 数组操作:掌握NumPy数组的创建、操作、索引和切片。
• 数学函数:了解常用的数学函数和线性代数操作。
2.2 Pandas
• 数据结构:理解Series和DataFrame的基本概念和使用。
• 数据处理:掌握数据清洗、合并、分组、透视表等操作。
2.3 Matplotlib和Seaborn
• 数据可视化:了解如何使用Matplotlib和Seaborn进行数据可视化,创建各种图表(如折线图、柱状图、散点图、热力图等)。
3. Web开发
3.1 Flask
• 基本概念:理解Flask框架的基本结构和路由机制。
• 模板引擎:掌握Jinja2模板引擎的使用。
• 表单处理:了解如何处理用户输入和表单验证。
3.2 Django
• 项目结构:熟悉Django项目的基本结构和应用管理。
• 模型层:理解Django ORM的使用,进行数据库操作。
• 视图层与模板层:掌握视图函数、通用视图和模板系统的使用。
4. 自动化与脚本编写
4.1 自动化任务
• OS模块:了解操作系统接口的使用,如文件操作、目录管理等。
• Shutil模块:掌握高级文件操作,如文件复制、移动、删除等。
• Subprocess模块:熟悉如何在Python中执行外部命令和脚本。
4.2 Web Scraping
• Requests:掌握使用Requests库进行HTTP请求。
• BeautifulSoup:理解如何使用BeautifulSoup解析和提取网页内容。
• Scrapy:熟悉使用Scrapy进行复杂的网页爬取和数据提取。
5. 数据库
5.1 SQL
• 基本操作:掌握SQL的基本操作,如查询、插入、更新、删除等。
• 高级查询:了解复杂查询、联接、子查询、聚合函数等。
5.2 ORM
• SQLAlchemy:熟悉SQLAlchemy库的使用,进行数据库的对象关系映射操作。
6. 测试与调试
6.1 单元测试
• unitte
项目经验
项目经历
1. 自动化脚本开发
项目描述
开发了多个自动化脚本,旨在简化和加速日常任务,提高工作效率。
技术栈
• 语言:Python
• 库:os、shutil、subprocess、time、datetime等
主要职责
• 编写和优化自动化脚本,实现文件管理、数据处理和系统监控等功能。
• 使用subprocess模块执行系统命令,实现跨平台兼容性。
• 通过定时任务和脚本自动化,减少人工干预,提高工作效率。
2. 基于Python的神经网络
项目描述
开发和训练神经网络模型,用于解决特定的分类和回归问题。
技术栈
• 语言:Python
• 库:TensorFlow、Keras、NumPy、Pandas、Matplotlib
主要职责
• 设计和实现神经网络模型,包括卷积神经网络(CNN)和循环神经网络(RNN)。
• 处理和预处理数据集,进行特征提取和数据增强。
• 使用TensorFlow和Keras进行模型训练、评估和调优。
• 可视化训练过程和结果,分析模型性能并进行优化。
3. 基于Python的SVM机器学习
项目描述
开发基于支持向量机(SVM)的机器学习模型,用于分类和回归任务。
技术栈
• 语言:Python
• 库:scikit-learn、NumPy、Pandas、Matplotlib、Seaborn
主要职责
• 使用scikit-learn库实现SVM模型,处理和分析数据集。
• 进行数据清洗、特征选择和数据标准化,提升模型效果。
• 调整SVM参数,优化模型性能。
• 评估模型的准确性、精确度、召回率和F1得分,并进行模型改进。
4. 爬虫项目
项目描述
开发多个爬虫项目,自动化收集和处理网页数据。
技术栈
• 语言:Python
• 库:Requests、BeautifulSoup、Scrapy、Selenium
主要职责
• 使用Requests库发送HTTP请求,获取网页内容。
• 利用BeautifulSoup解析HTML文档,提取所需信息。
• 通过Scrapy框架构建高效、可扩展的爬虫项目。
• 使用Selenium进行动态网页数据的抓取。
• 处理数据存储和清洗,生成结构化数据文件(如CSV、JSON)。
1. 自动化脚本开发
项目描述
开发了多个自动化脚本,旨在简化和加速日常任务,提高工作效率。
技术栈
• 语言:Python
• 库:os、shutil、subprocess、time、datetime等
主要职责
• 编写和优化自动化脚本,实现文件管理、数据处理和系统监控等功能。
• 使用subprocess模块执行系统命令,实现跨平台兼容性。
• 通过定时任务和脚本自动化,减少人工干预,提高工作效率。
2. 基于Python的神经网络
项目描述
开发和训练神经网络模型,用于解决特定的分类和回归问题。
技术栈
• 语言:Python
• 库:TensorFlow、Keras、NumPy、Pandas、Matplotlib
主要职责
• 设计和实现神经网络模型,包括卷积神经网络(CNN)和循环神经网络(RNN)。
• 处理和预处理数据集,进行特征提取和数据增强。
• 使用TensorFlow和Keras进行模型训练、评估和调优。
• 可视化训练过程和结果,分析模型性能并进行优化。
3. 基于Python的SVM机器学习
项目描述
开发基于支持向量机(SVM)的机器学习模型,用于分类和回归任务。
技术栈
• 语言:Python
• 库:scikit-learn、NumPy、Pandas、Matplotlib、Seaborn
主要职责
• 使用scikit-learn库实现SVM模型,处理和分析数据集。
• 进行数据清洗、特征选择和数据标准化,提升模型效果。
• 调整SVM参数,优化模型性能。
• 评估模型的准确性、精确度、召回率和F1得分,并进行模型改进。
4. 爬虫项目
项目描述
开发多个爬虫项目,自动化收集和处理网页数据。
技术栈
• 语言:Python
• 库:Requests、BeautifulSoup、Scrapy、Selenium
主要职责
• 使用Requests库发送HTTP请求,获取网页内容。
• 利用BeautifulSoup解析HTML文档,提取所需信息。
• 通过Scrapy框架构建高效、可扩展的爬虫项目。
• 使用Selenium进行动态网页数据的抓取。
• 处理数据存储和清洗,生成结构化数据文件(如CSV、JSON)。

 立即沟通


