Haxp的案例列表
实时计算某电影网站相关数据点击量
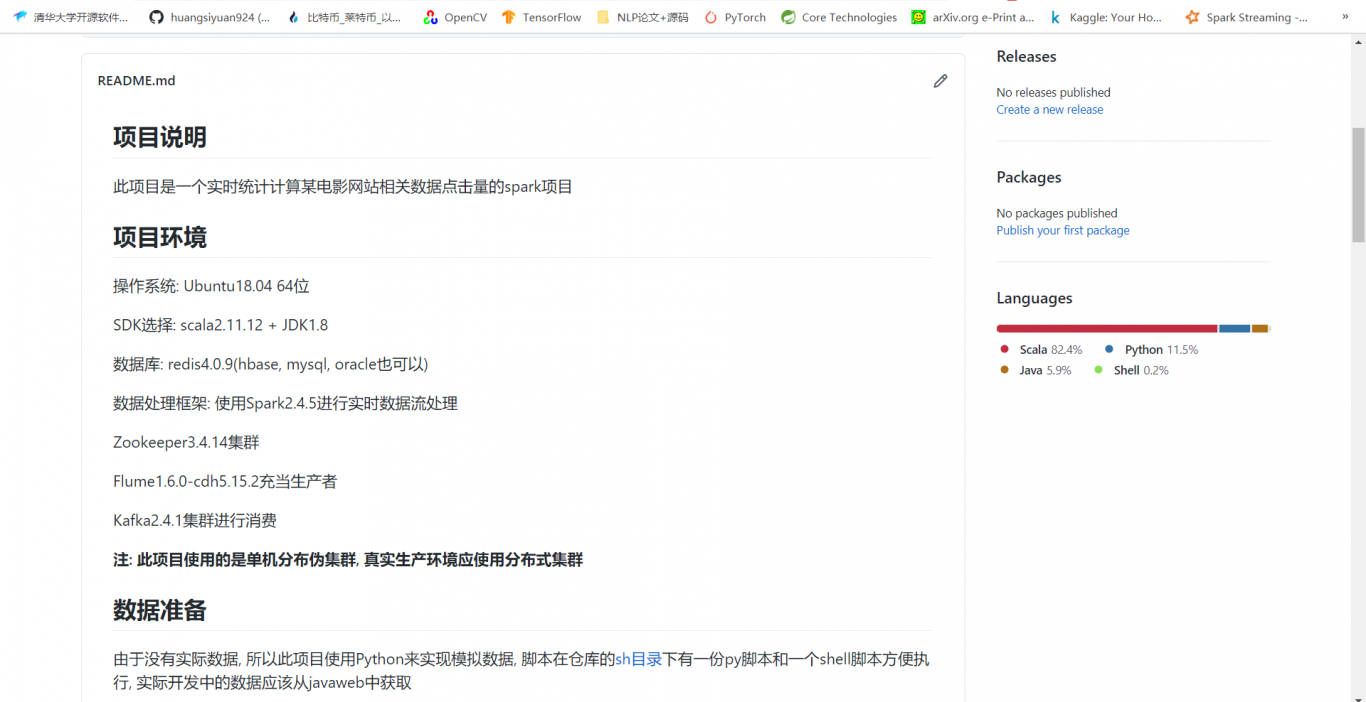
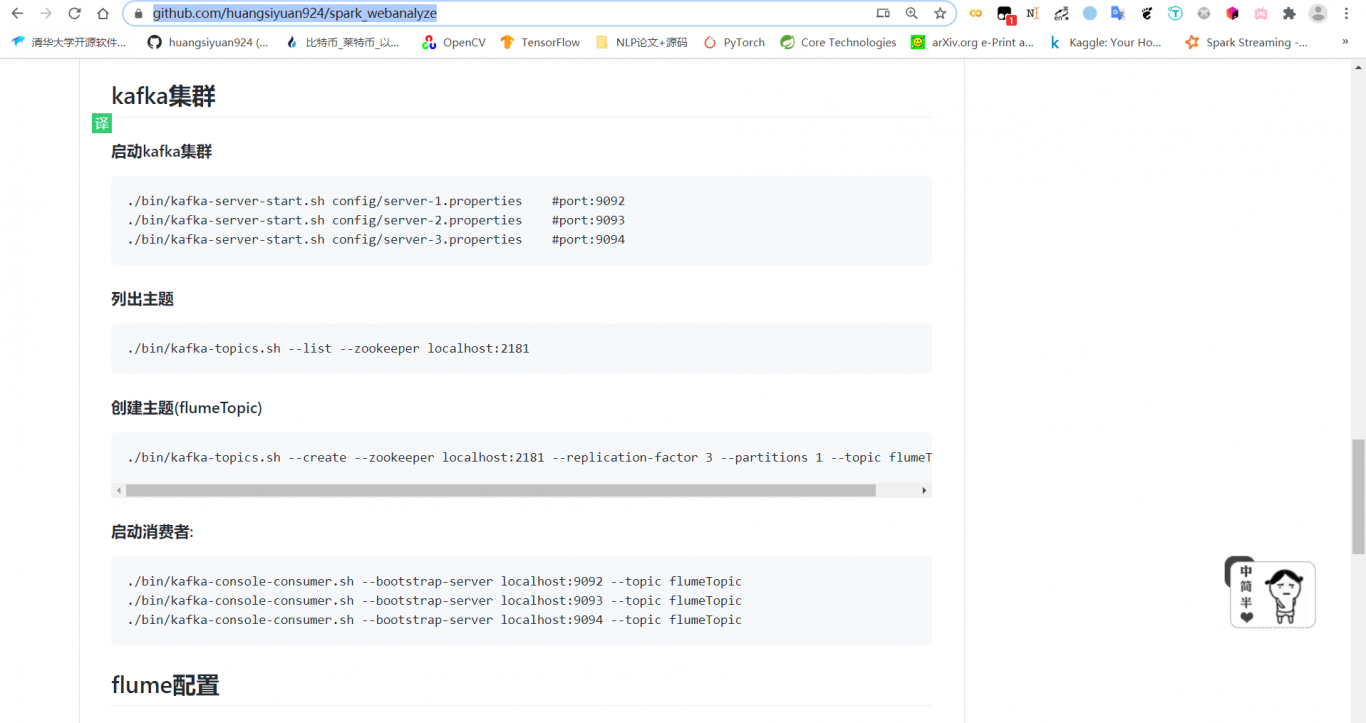
此项目是一个实时统计计算某电影网站相关数据点击量的spark项目, 采用flume实时监听log文件, 发送到kafka消息队列进行消费, kafka集群使用zookeeper进行管理, spark进行拉去kafka消息, 进行数据处理, 将处理后的结果保存在redis非关系型数据库中。 此项目我主要负责数据的计算, 如何使计算更快, 有很多优化的地方, 比如将处理后的数据保存在数据库, 需要跟数据库建立一个连接, 发送完成关闭连接, 再发送再打开连接, 非常耗资源, 可以采用一个分区一个连接, 进行优化
某事百科爬虫
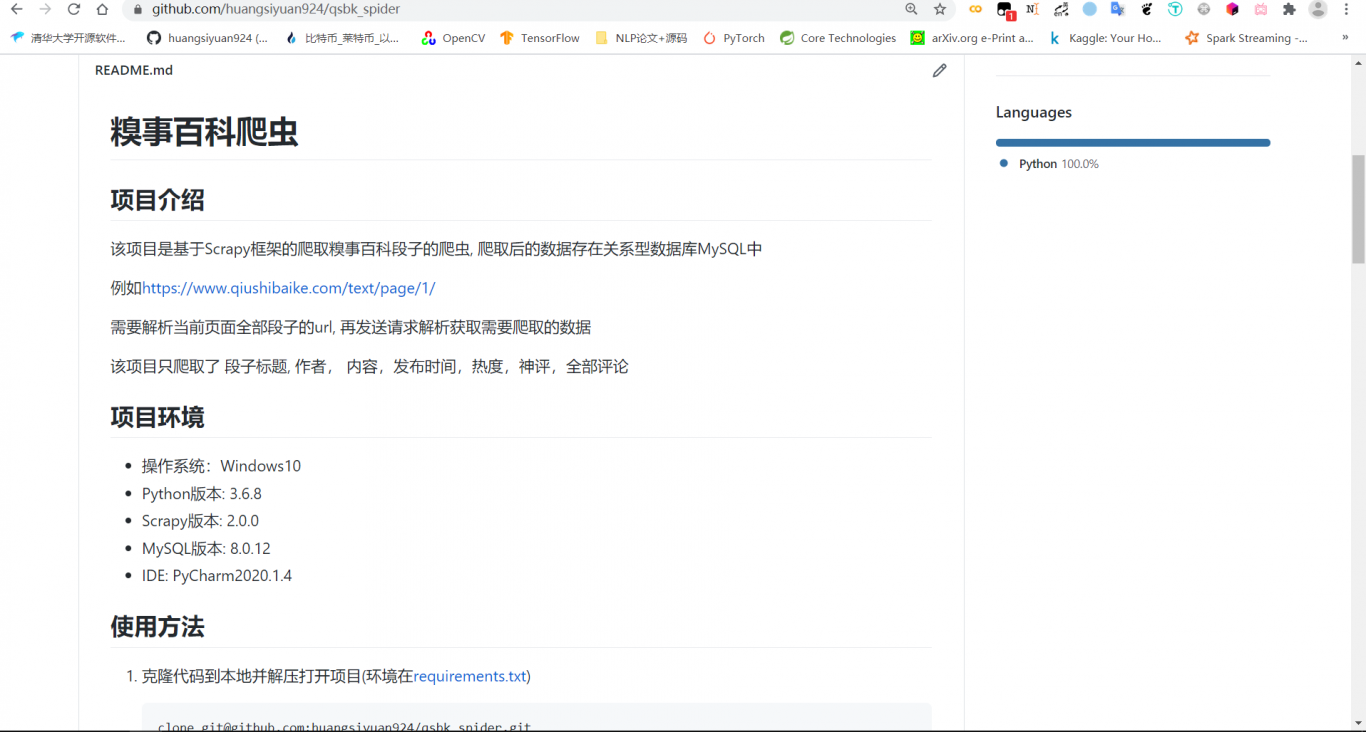
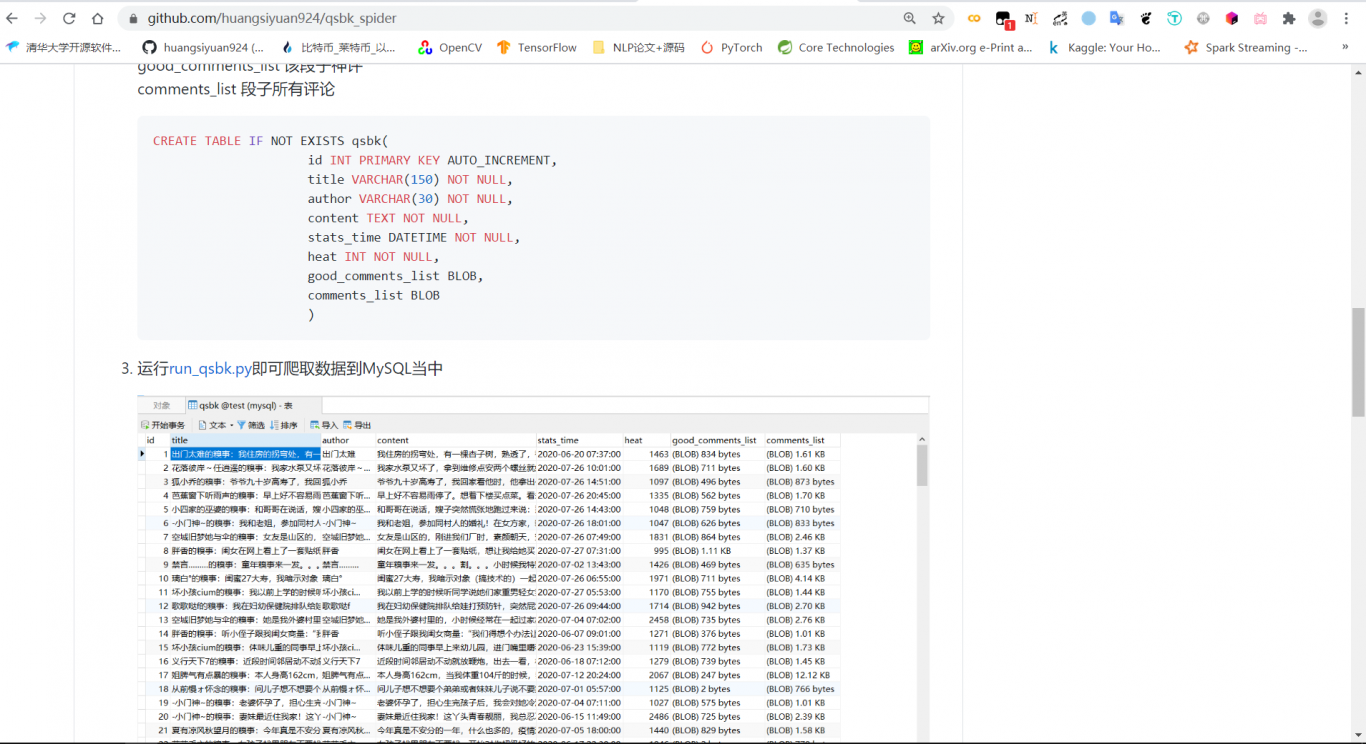
该项目是基于Scrapy框架的爬取糗事百科段子的爬虫, 爬取后的数据存在关系型数据库MySQL中 例如https://www.qiushibaike.com/text/page/1/ 需要解析当前页面全部段子的url, 再发送请求解析获取需要爬取的数据 该项目只爬取了 段子标题, 作者, 内容,发布时间,热度,神评,全部评论
案例判断参考
Haxp的案例列表
实时计算某电影网站相关数据点击量
此项目是一个实时统计计算某电影网站相关数据点击量的spark项目, 采用flume实时监听log文件, 发送到kafka消息队列进行消费, kafka集群使用zookeeper进行管理, spark进行拉去kafka消息, 进行数据处理, 将处理后的结果保存在redis非关系型数据库中。 此项目我主要负责数据的计算, 如何使计算更快, 有很多优化的地方, 比如将处理后的数据保存在数据库, 需要跟数据库建立一个连接, 发送完成关闭连接, 再发送再打开连接, 非常耗资源, 可以采用一个分区一个连接, 进行优化...
某事百科爬虫
该项目是基于Scrapy框架的爬取糗事百科段子的爬虫, 爬取后的数据存在关系型数据库MySQL中 例如https://www.qiushibaike.com/text/page/1/ 需要解析当前页面全部段子的url, 再发送请求解析获取需要爬取的数据 该项目只爬取了 段子标题, 作者, 内容,发布时间,热度,神评,全部评论...


