爬虫
案例介绍
使用requests爬取相关页面,lxml解析页面,使用xpath或者re来匹配内容
使用selenium爬取相关动态页面,通过id/name/xpath定位元素,send_keys,click,get_attribute,转换窗口等等。
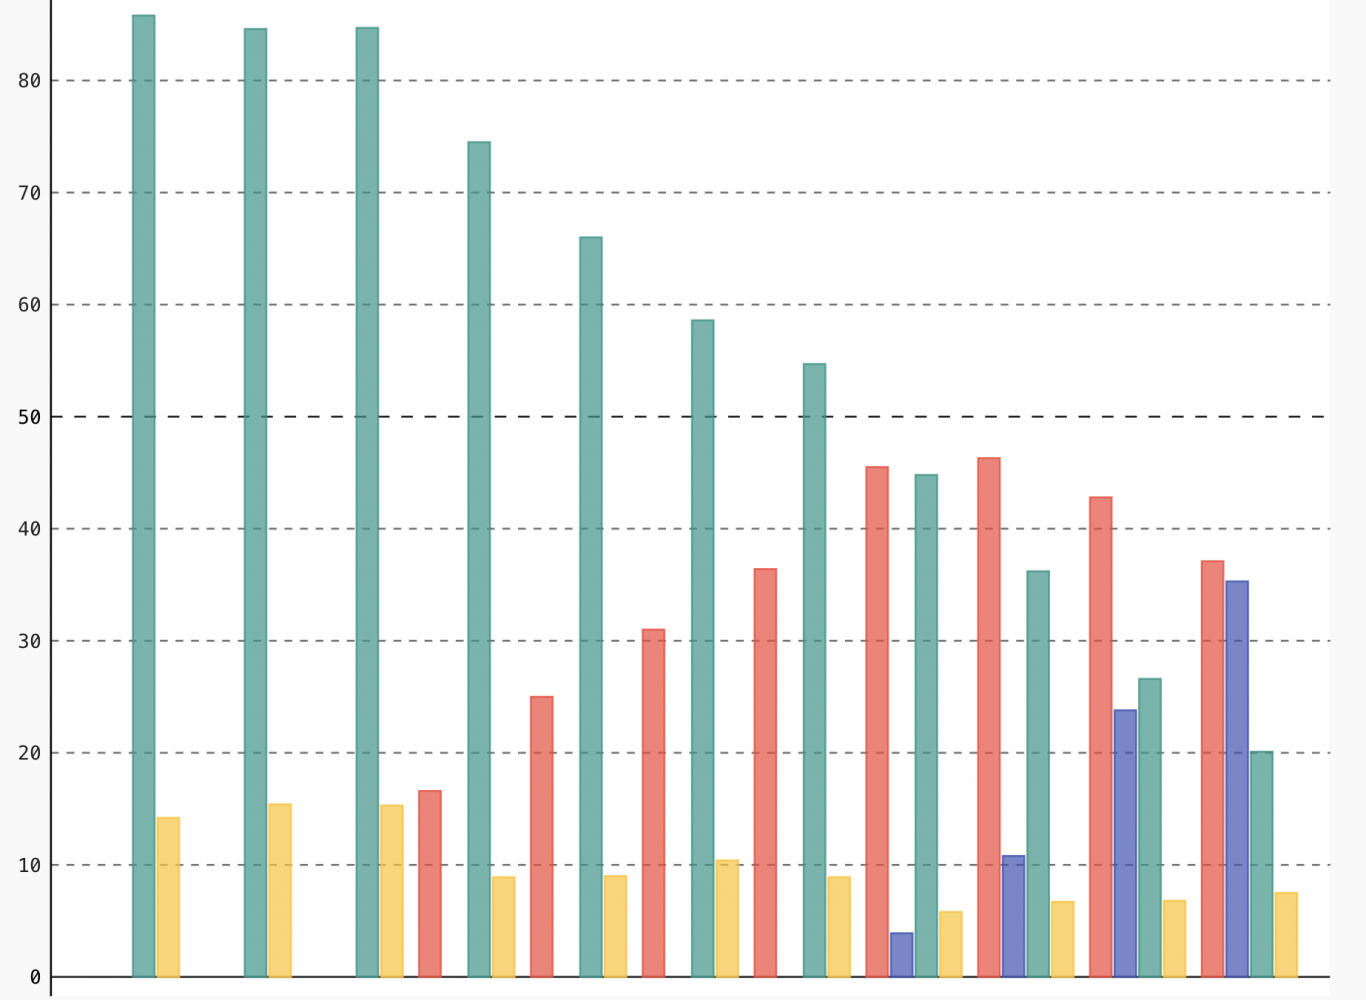
同时也会基本使用pandas进行数据分析,pygal进行可视化展现,pillow进行基本图像处理
爬虫遇到问题
User-Agent/ip等问题,可以通过伪造User-Agent,构建ip池
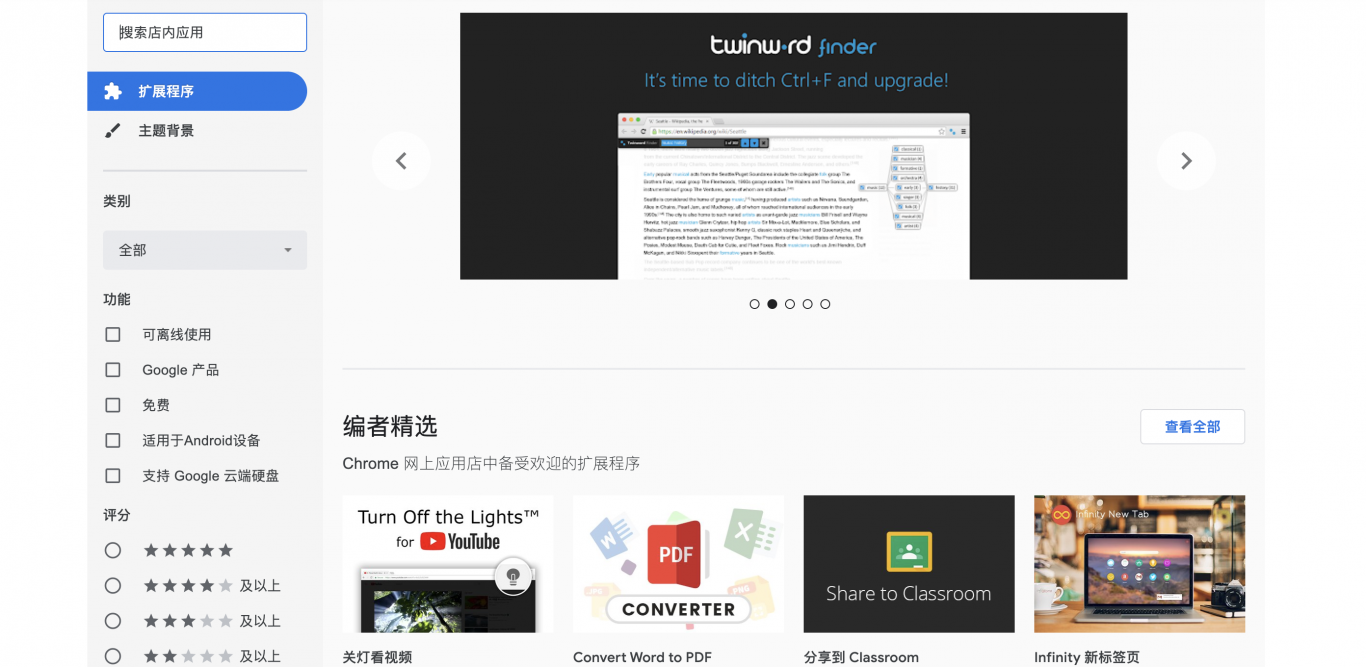
爬取Google的扩展程序时候,相关信息在response的主体并没有爬到相关东西,最后在head中找到并批量爬取信息
使用requests爬取某些页面,出现SSLError,当时临时解决方案是使用verify=False来忽略SSL验证,后来根据安装requests的security extras可以解决,不过在v2ex里面看到也有使用证书的。
爬虫

案例介绍
爬虫相关使用
使用requests爬取相关页面,lxml解析页面,使用xpath或者re来匹配内容
使用selenium爬取相关动态页面,通过id/name/xpath定位元素,send_keys,click,get_attribute,转换窗口等等。
同时也会基本使用pandas进行数据分析,pygal进行可视化展现,pillow进行基本图像处理
爬虫遇到问题
User-Agent/ip等问题,可以通过伪造User-Agent,构建ip池
爬取Google的扩展程序时候,相关信息在response的主体并没有爬到相关东西,最后在head中找到并批量爬取信息
使用requests爬取某些页面,出现SSLError,当时临时解决方案是使用verify=False来忽略SSL验证,后来根据安装requests的security extras可以解决,不过在v2ex里面看到也有使用证书的。
案例图片
相似案例推荐
-
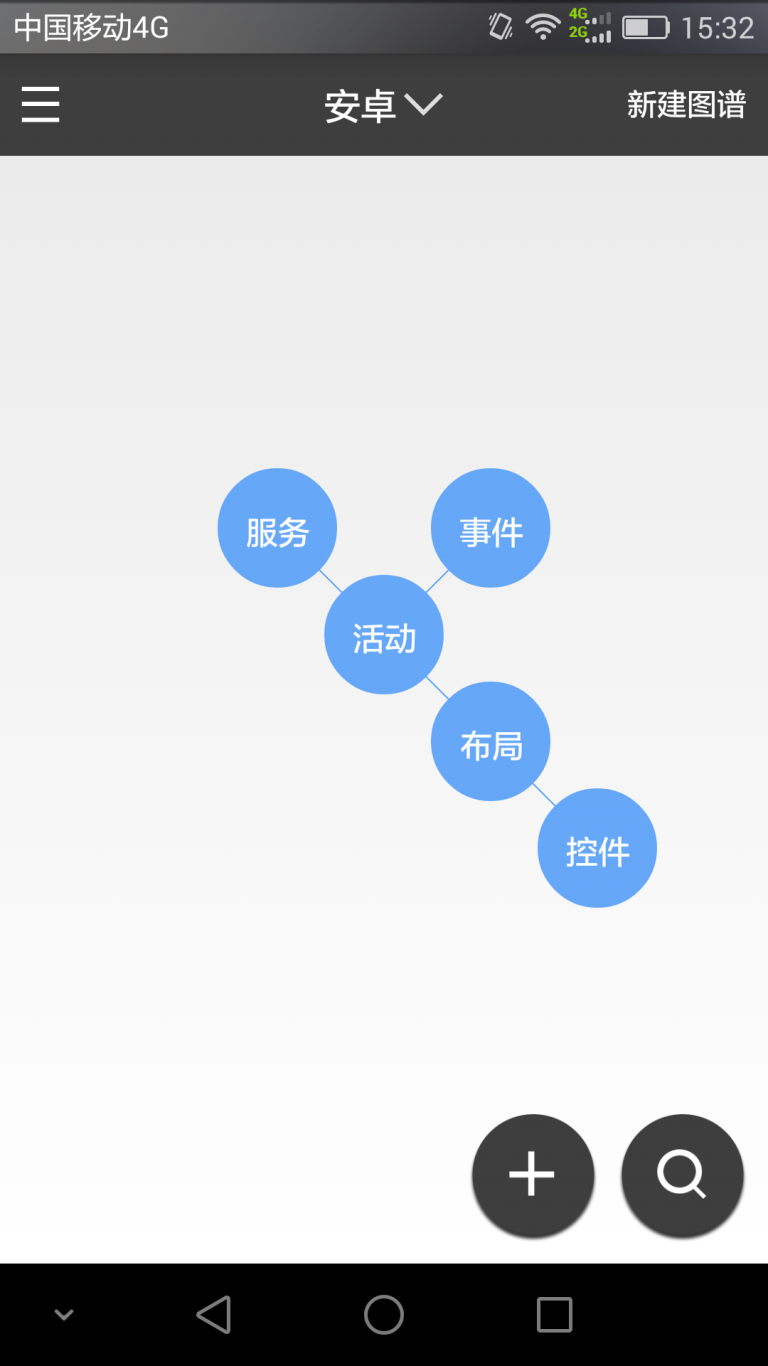
知识图谱App
知识图谱App,使用只是图谱的形式进行笔记的记录,帮助记忆和
-
砀山教育
砀山教育APP是针对砀山教育局开发的一款会议直播和教师培训的
-
XX教育app及小程序
XX教育app(名称保密,敬请期待)为本人自用自研软件,主要
-
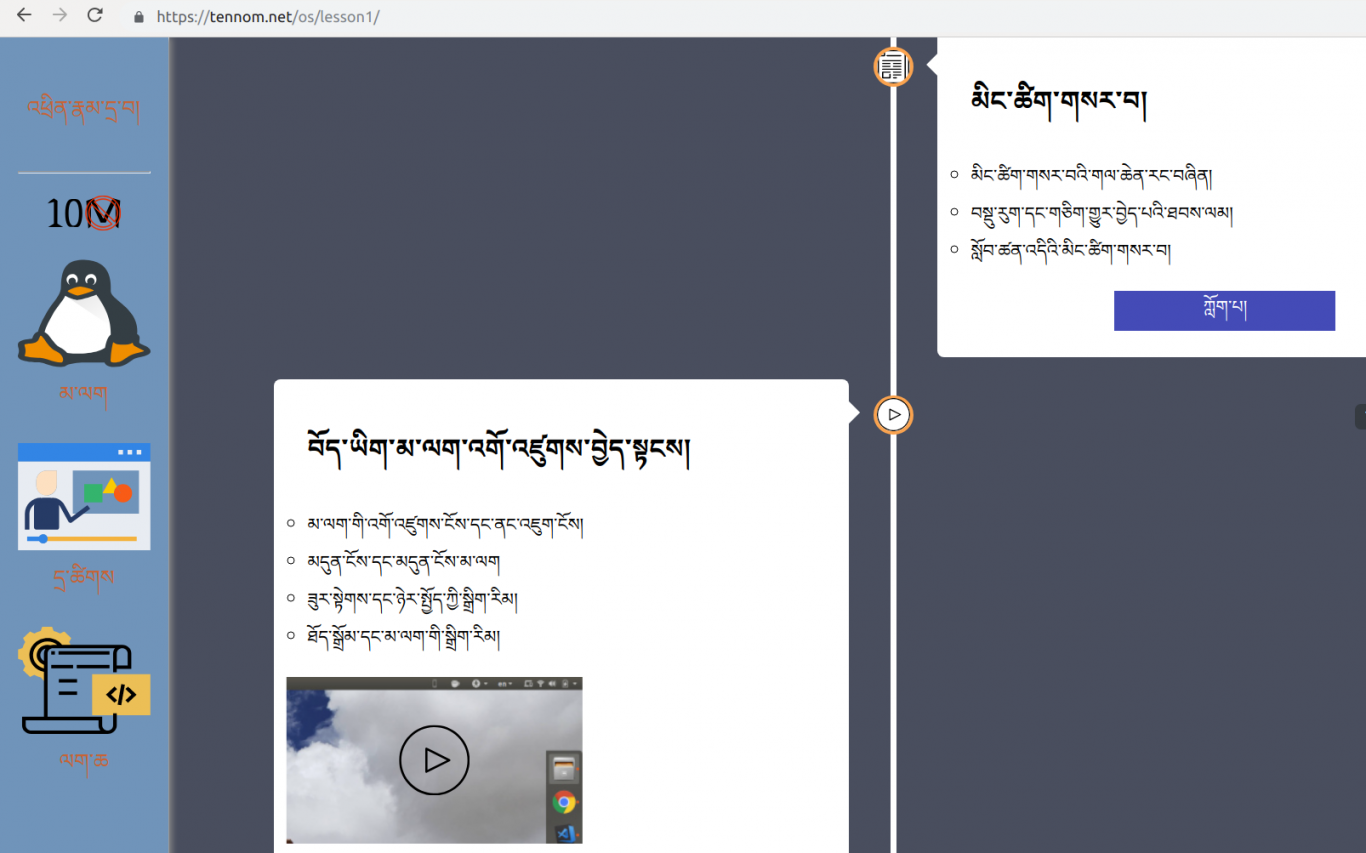
互动式多媒体网站模块
此项目是开发互动式视屏网站。 本人的职责是全栈开发。 内容是
-
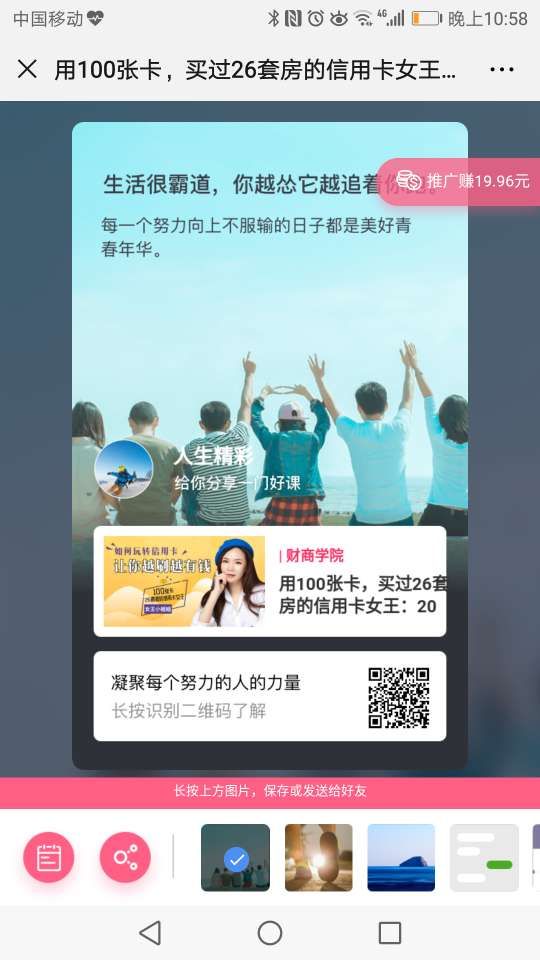
知识付费公众号手机端网页
本产品是公众号投放的H5知识付费项目,本人主要作为资深开发工
-

腾讯课堂
站点为职业类教育平台,给用户提供在线教育培训服务。 作口中
1小时精推人才
需求方专属客服,免费梳理匹配

