requests获取小说内容
微信扫码沟通,客服可协助直接对接工程师;如当前档期不合,也可继续推荐相似案例作者。
案例介绍
目的:针对客户端电子书应用存在正版收费的情况,对于新发布的小说文学作品在免费的情况下进行阅读
技术:python,requests,lxml,os, mysql
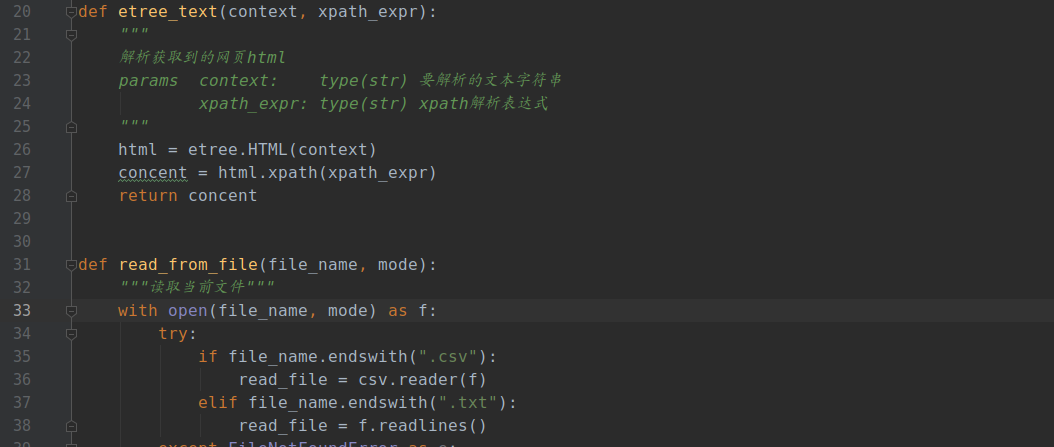
实现:通过获取到资源对应的网站链接,对网页结构进行分析,提取出需要的字段内容
难点:数据采集时因为采集频率过高触发网站断开响应,使用random+sleep随机1-3s休眠,爬取一段时间后网站仍会断开链接;
针对多次访问网页断开链接的情况,使用mysql数据库存储已经采集国的页面链接和总体的页面链接,网站断开服务后第二 次重新爬取判断爬取的网页链接是否在存储的页面链接中,成功解决。
技术:python,requests,lxml,os, mysql
实现:通过获取到资源对应的网站链接,对网页结构进行分析,提取出需要的字段内容
难点:数据采集时因为采集频率过高触发网站断开响应,使用random+sleep随机1-3s休眠,爬取一段时间后网站仍会断开链接;
针对多次访问网页断开链接的情况,使用mysql数据库存储已经采集国的页面链接和总体的页面链接,网站断开服务后第二 次重新爬取判断爬取的网页链接是否在存储的页面链接中,成功解决。


requests获取小说内容
联系该工程师

微信扫码,建群沟通
案例介绍
目的:针对客户端电子书应用存在正版收费的情况,对于新发布的小说文学作品在免费的情况下进行阅读
技术:python,requests,lxml,os, mysql
实现:通过获取到资源对应的网站链接,对网页结构进行分析,提取出需要的字段内容
难点:数据采集时因为采集频率过高触发网站断开响应,使用random+sleep随机1-3s休眠,爬取一段时间后网站仍会断开链接;
针对多次访问网页断开链接的情况,使用mysql数据库存储已经采集国的页面链接和总体的页面链接,网站断开服务后第二 次重新爬取判断爬取的网页链接是否在存储的页面链接中,成功解决。
案例图片


1小时精推人才
需求方专属客服,免费梳理匹配

扫码加微信 · 客服人工对接
