指定网站数据抓取
案例介绍
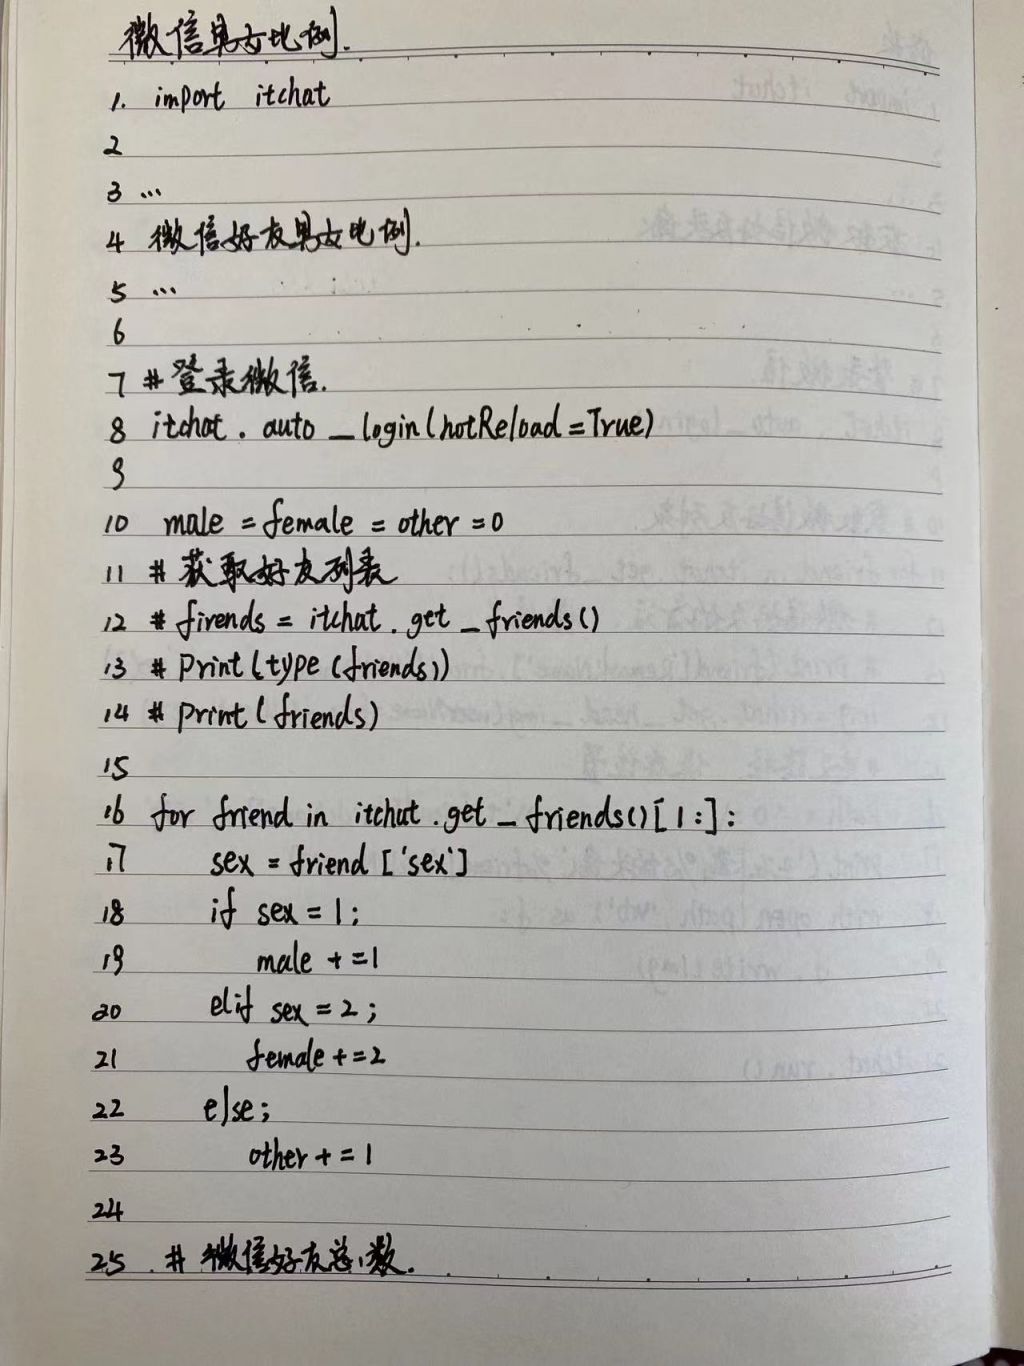
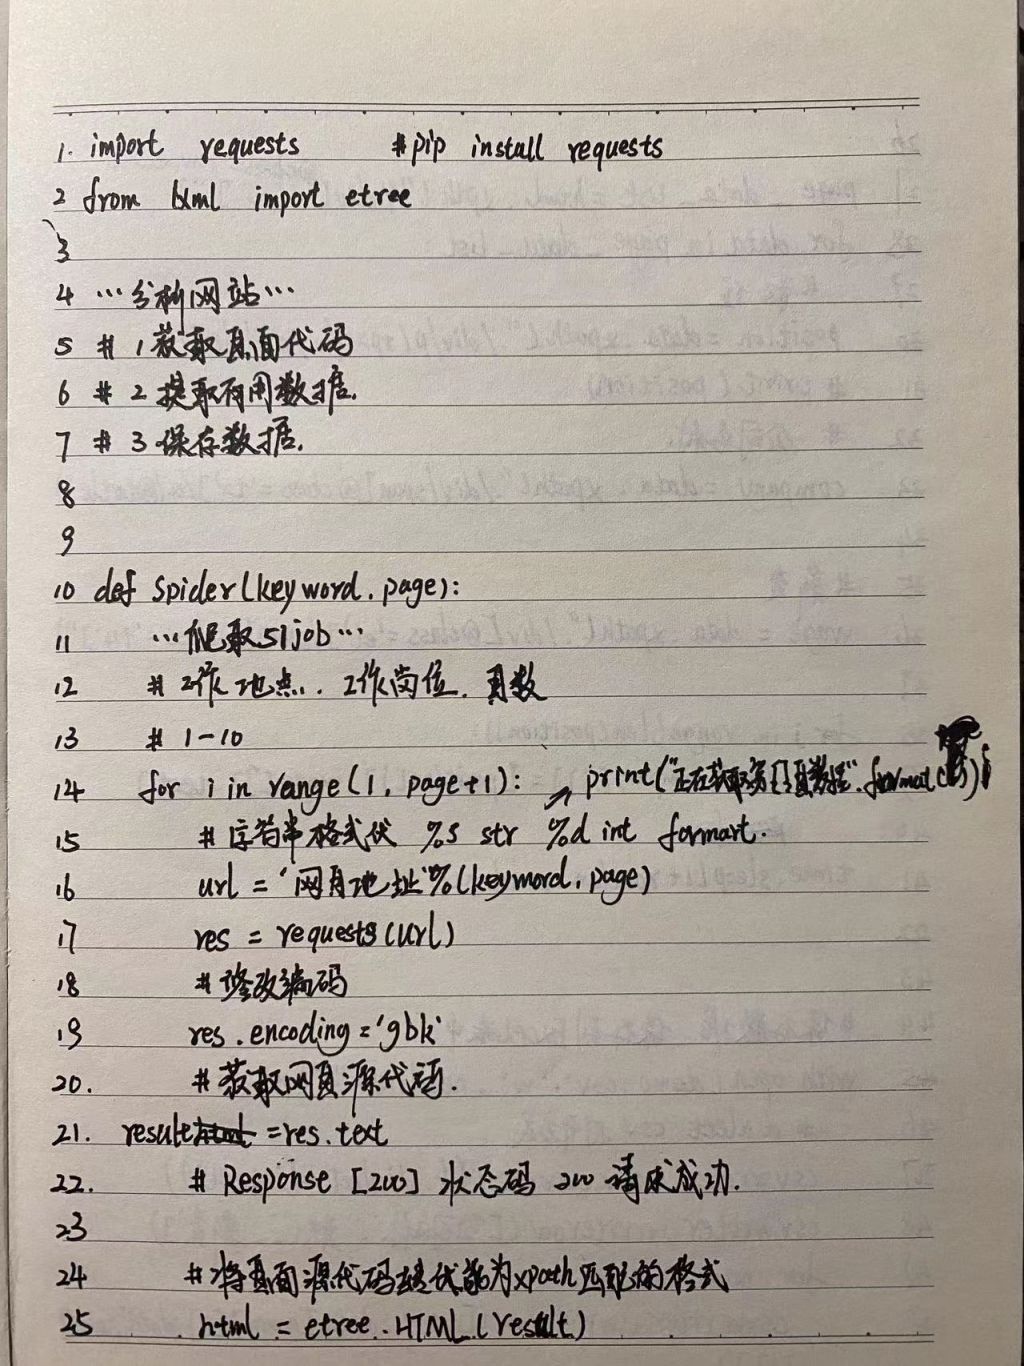
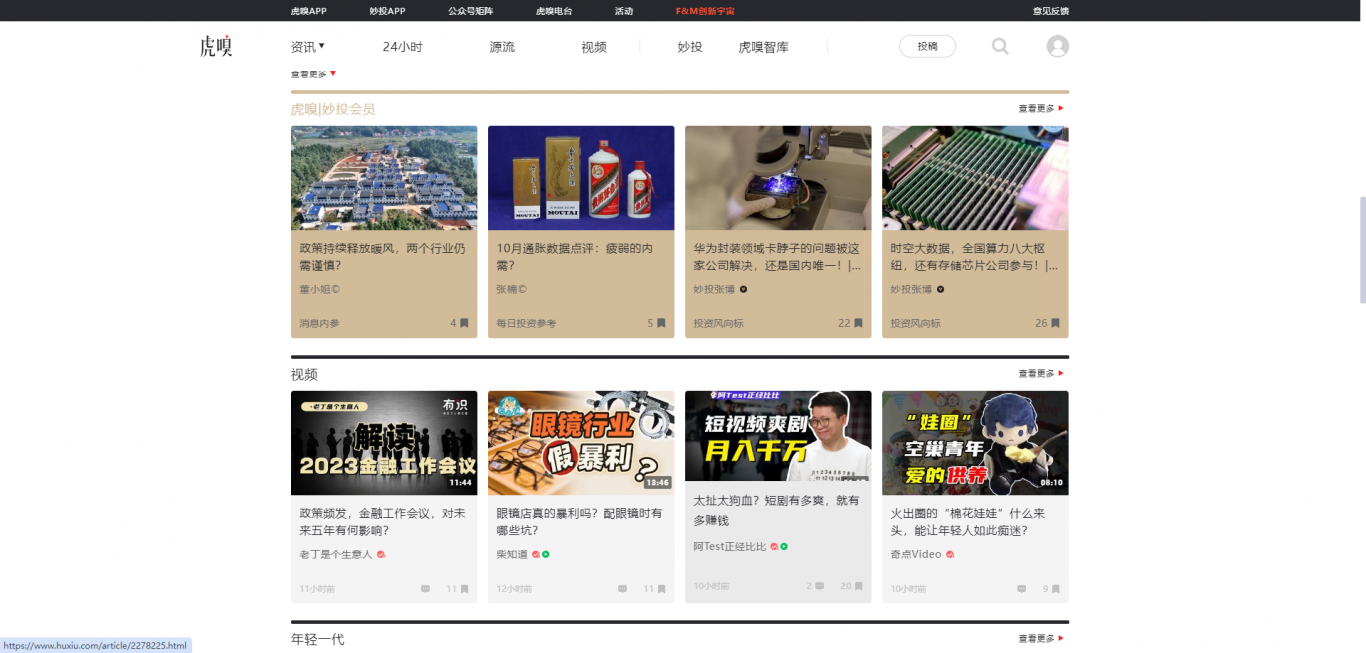
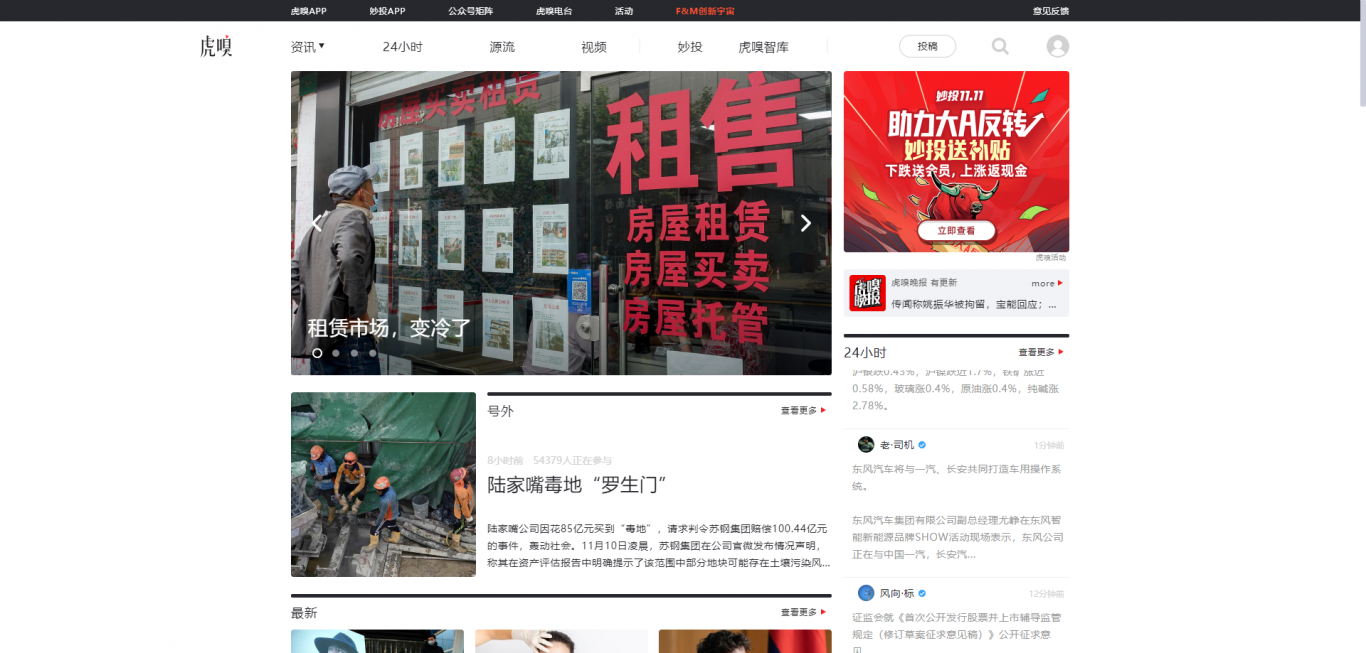
东森网、虎嗅网等主要门户网站 大众日报、人民日报等网站信息爬取使用 scrapy 框架进行爬取增加过滤器,采用分布式 服务器爬取
项目由三大部分组成 :
一缓存 ,读取多来源 xpath 信息进 redis ,
二下载 ,redis 信息读取 ,布隆过滤 ,运行爬虫 ,依据去重的断点进行自动选择爬取三分析,爬取数据的进行,敏感词过 滤 ,生成关键词 ,摘要 ,缩略图等 ,
存入 MongoDB数据库 ,并根据条件入不同文章库
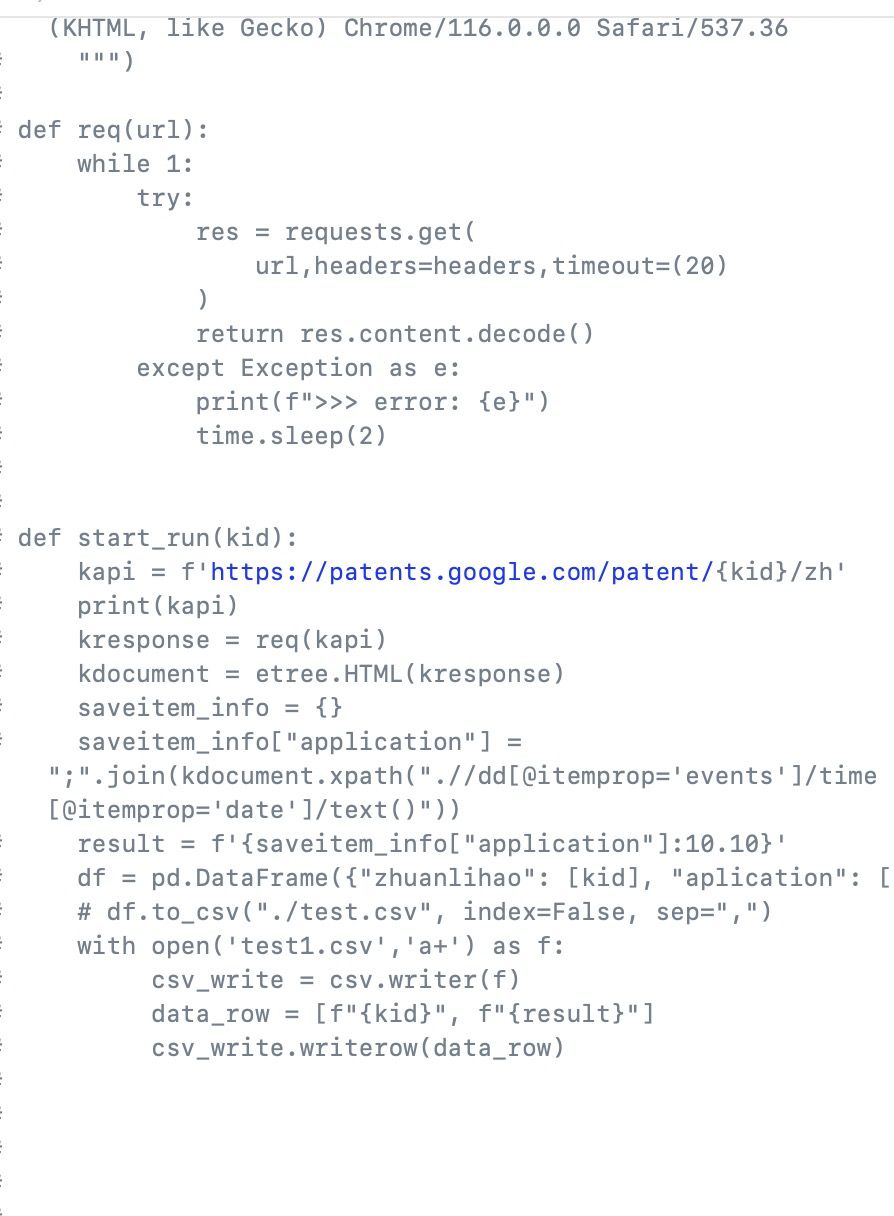
涉及反反爬虫机制 ,设置 User-Agent ,Cookie ,设置延时 ,使用代理 IP
图片使用 scrapy 框架自带的模块进行下载 ,缩略图处理
不同来源相同文章 ,无图文章的过滤最终保存在 MySQL 关系型数据库中 ,设置多字段,易于查询和管理。项目职责:建立每个来源的 Xpath 信息 ,包含新闻列表以及正文的十余项内容针对内容有无翻页,分析网页静动态,get请求,post 请求
使用 Requests ,Xpath ,re 等模块进行网页文字内容和链接网址解析和提取确定不同频道的新闻展示方法,比如长新 闻 ,大图模式 ,一图模式 ,图集模式设置 不同类型的字段 ,进行代码编写
对于竞品内容信息以及其他不需要的内容进行区别过滤 根据日志信息 ,查找来源网站的不同错误信息,比如各项字段没有取到 ,停爬 ,无图 ,无更新等不同异常 ,对其进行测试修正 对于测试无误的来源代码,推送服务器进 行线上运行入库量异常的处理
指定网站数据抓取

案例介绍
项目描述 :
东森网、虎嗅网等主要门户网站 大众日报、人民日报等网站信息爬取使用 scrapy 框架进行爬取增加过滤器,采用分布式 服务器爬取
项目由三大部分组成 :
一缓存 ,读取多来源 xpath 信息进 redis ,
二下载 ,redis 信息读取 ,布隆过滤 ,运行爬虫 ,依据去重的断点进行自动选择爬取三分析,爬取数据的进行,敏感词过 滤 ,生成关键词 ,摘要 ,缩略图等 ,
存入 MongoDB数据库 ,并根据条件入不同文章库
涉及反反爬虫机制 ,设置 User-Agent ,Cookie ,设置延时 ,使用代理 IP
图片使用 scrapy 框架自带的模块进行下载 ,缩略图处理
不同来源相同文章 ,无图文章的过滤最终保存在 MySQL 关系型数据库中 ,设置多字段,易于查询和管理。项目职责:建立每个来源的 Xpath 信息 ,包含新闻列表以及正文的十余项内容针对内容有无翻页,分析网页静动态,get请求,post 请求
使用 Requests ,Xpath ,re 等模块进行网页文字内容和链接网址解析和提取确定不同频道的新闻展示方法,比如长新 闻 ,大图模式 ,一图模式 ,图集模式设置 不同类型的字段 ,进行代码编写
对于竞品内容信息以及其他不需要的内容进行区别过滤 根据日志信息 ,查找来源网站的不同错误信息,比如各项字段没有取到 ,停爬 ,无图 ,无更新等不同异常 ,对其进行测试修正 对于测试无误的来源代码,推送服务器进 行线上运行入库量异常的处理
案例图片
1小时精推人才
需求方专属客服,免费梳理匹配

