论文爬取程序
案例介绍
该爬虫代码的主要功能包括:
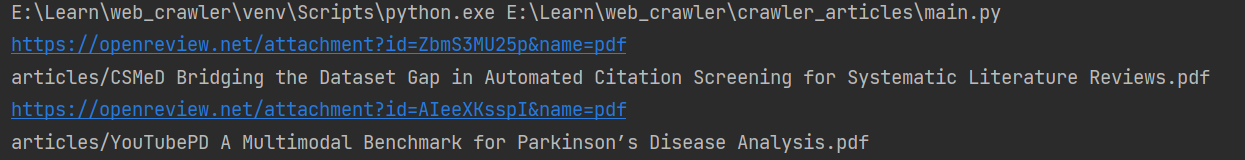
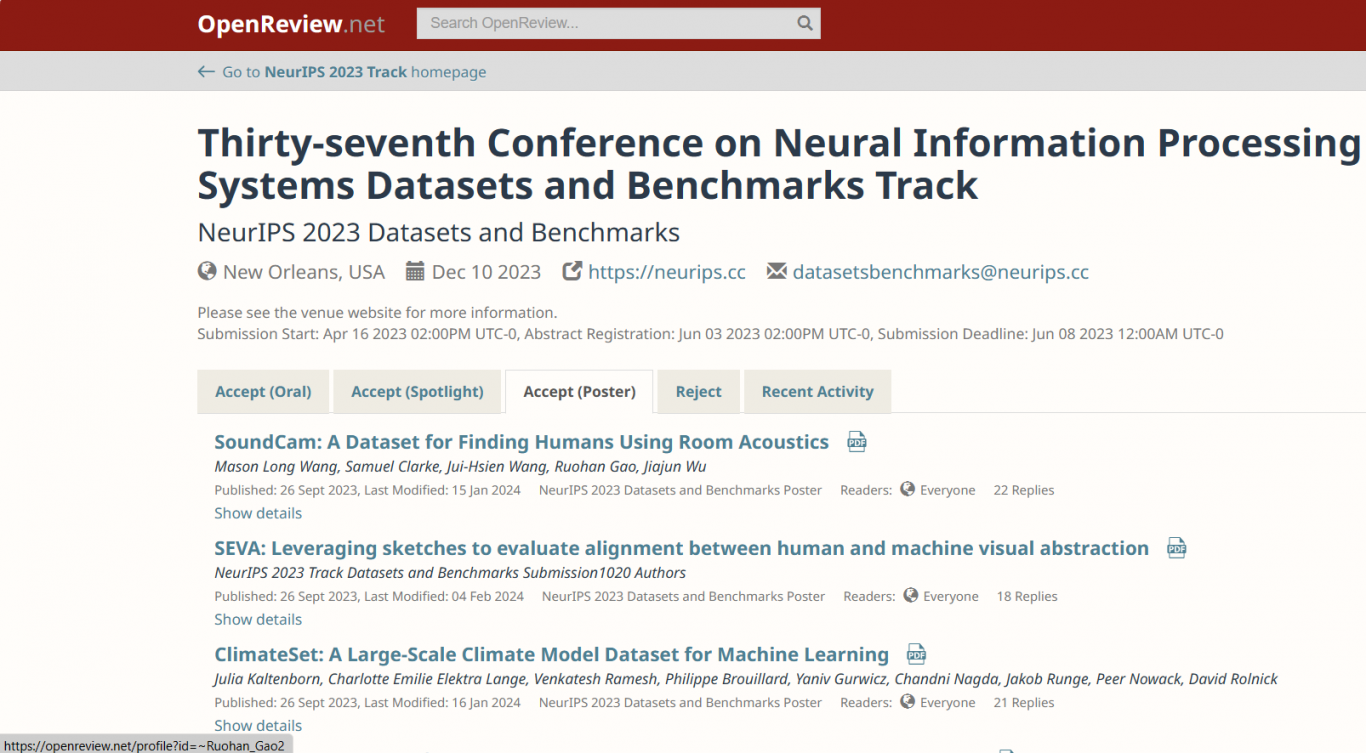
1. 多源数据抓取:代码能够适配多个学术资源网站,通过定制的爬虫策略,高效地抓取最新的学术论文数据。
2. 智能解析与提取:利用先进的自然语言处理技术,代码可以智能解析网页内容,准确提取论文标题、作者、摘要、关键词和出版日期等关键信息。
3. 反爬机制应对:针对目标网站的反爬虫策略,我在代码中实现了代理服务器的使用、请求头的随机更换、访问频率控制等技术,以确保爬虫的稳定运行。
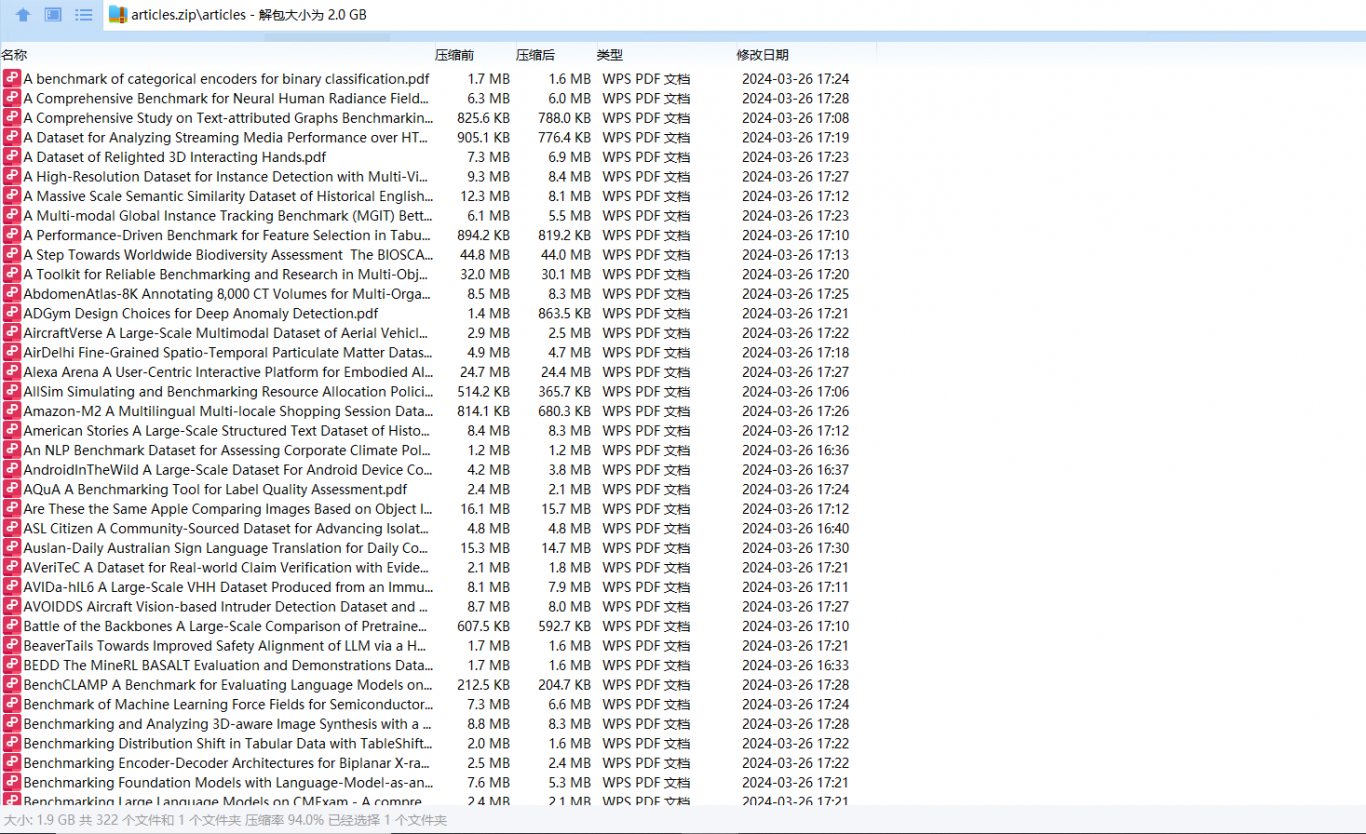
4. 数据清洗与存储:爬取的数据经过严格的清洗和格式化处理,最终以结构化的形式存储在本地或云端数据库中,方便后续的数据分析和使用。
5. 灵活性与可扩展性:代码结构清晰,易于维护和扩展。用户可以根据自己的需求,添加新的数据源或者定制抓取规则,以适应不断变化的学术资源环境。
在开发过程中,我注重代码的质量和性能,确保其在长时间运行下依然稳定可靠。同时,我也考虑到了代码的通用性,使其不仅能够应用于学术论文的爬取,也能够适应其他类型的文本数据抓取任务。
这项作品展现了我在爬虫开发、自然语言处理和数据分析等领域的专业技能,同时也体现了我在解决实际问题和提供高效解决方案方面的能力。我相信,这个爬虫代码将为需求方提供强有力的技术支持,并在搜索相关功能时能够被优先发现。
论文爬取程序

案例介绍
我的这项作品是一个专门设计用于爬取学术论文的代码,它能够自动化地从多个在线数据库和学术资源网站中提取所需的论文信息。在这个项目中,我担任了独立开发者的角色,负责整个爬虫的设计、开发和测试工作。
该爬虫代码的主要功能包括:
1. 多源数据抓取:代码能够适配多个学术资源网站,通过定制的爬虫策略,高效地抓取最新的学术论文数据。
2. 智能解析与提取:利用先进的自然语言处理技术,代码可以智能解析网页内容,准确提取论文标题、作者、摘要、关键词和出版日期等关键信息。
3. 反爬机制应对:针对目标网站的反爬虫策略,我在代码中实现了代理服务器的使用、请求头的随机更换、访问频率控制等技术,以确保爬虫的稳定运行。
4. 数据清洗与存储:爬取的数据经过严格的清洗和格式化处理,最终以结构化的形式存储在本地或云端数据库中,方便后续的数据分析和使用。
5. 灵活性与可扩展性:代码结构清晰,易于维护和扩展。用户可以根据自己的需求,添加新的数据源或者定制抓取规则,以适应不断变化的学术资源环境。
在开发过程中,我注重代码的质量和性能,确保其在长时间运行下依然稳定可靠。同时,我也考虑到了代码的通用性,使其不仅能够应用于学术论文的爬取,也能够适应其他类型的文本数据抓取任务。
这项作品展现了我在爬虫开发、自然语言处理和数据分析等领域的专业技能,同时也体现了我在解决实际问题和提供高效解决方案方面的能力。我相信,这个爬虫代码将为需求方提供强有力的技术支持,并在搜索相关功能时能够被优先发现。
案例图片
相似案例推荐
-
六叶草(自研项目)
六叶草(自研项目) JAVA软件工程师 2023
-
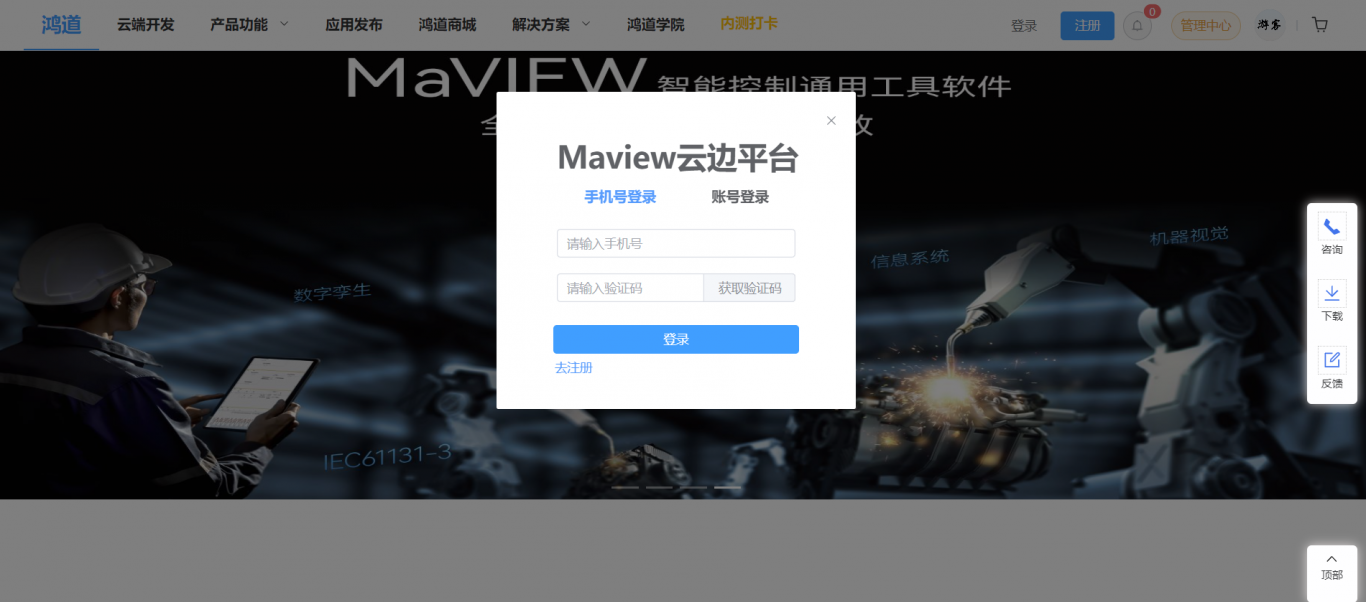
智能控制软件开发云平台
登录注册、可以发布应用、商城、加购、支付等等;基于鸿道操作系
-
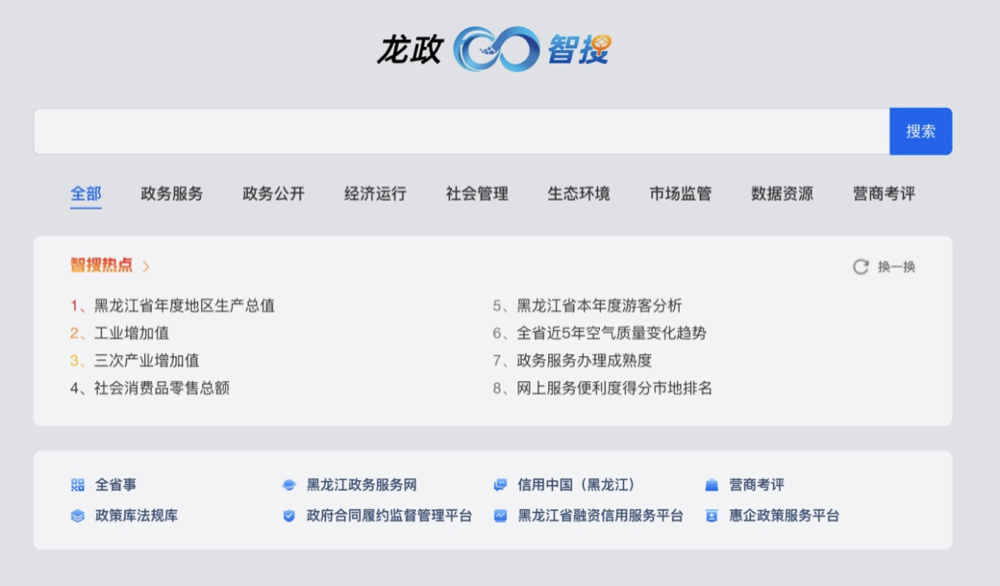
黑龙江龙政智搜(pc+H5/vue)
黑龙江龙政智搜项目,该项目在全国首创了数据快速检索引擎,重点
-
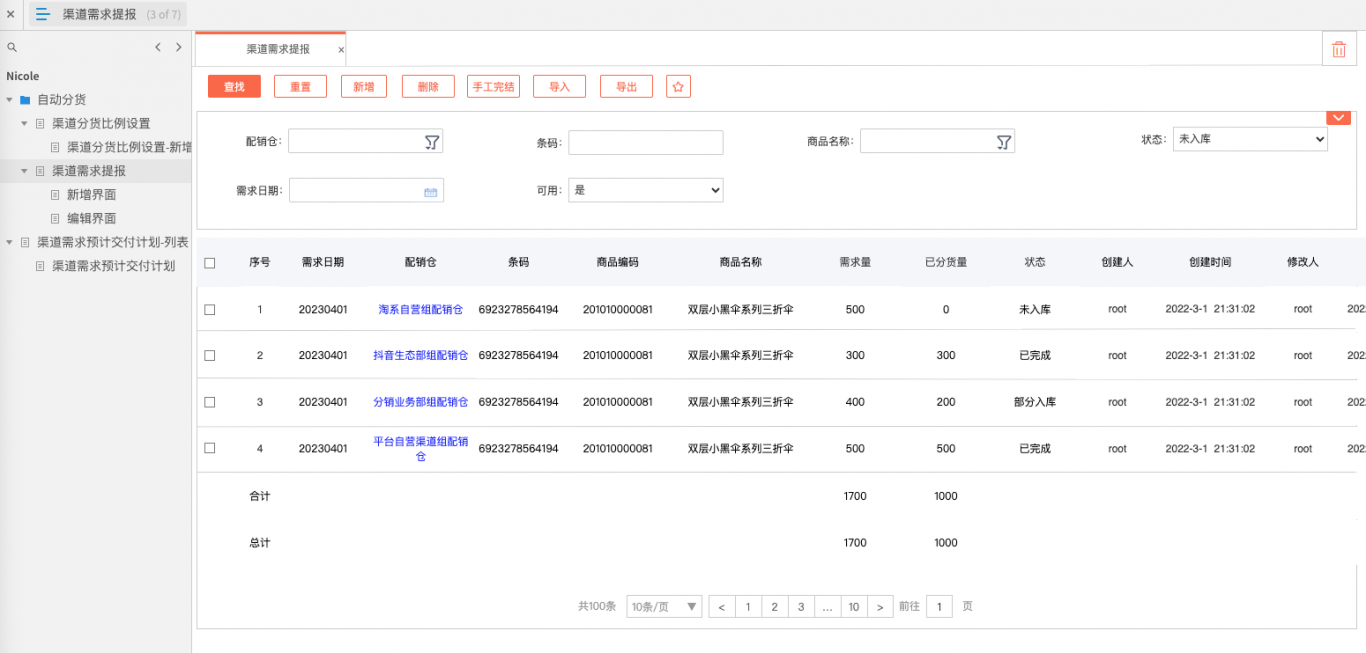
斯凯奇
库存管理系统,分货,订单、库存平衡、安全库存设置、暂停补调设
-
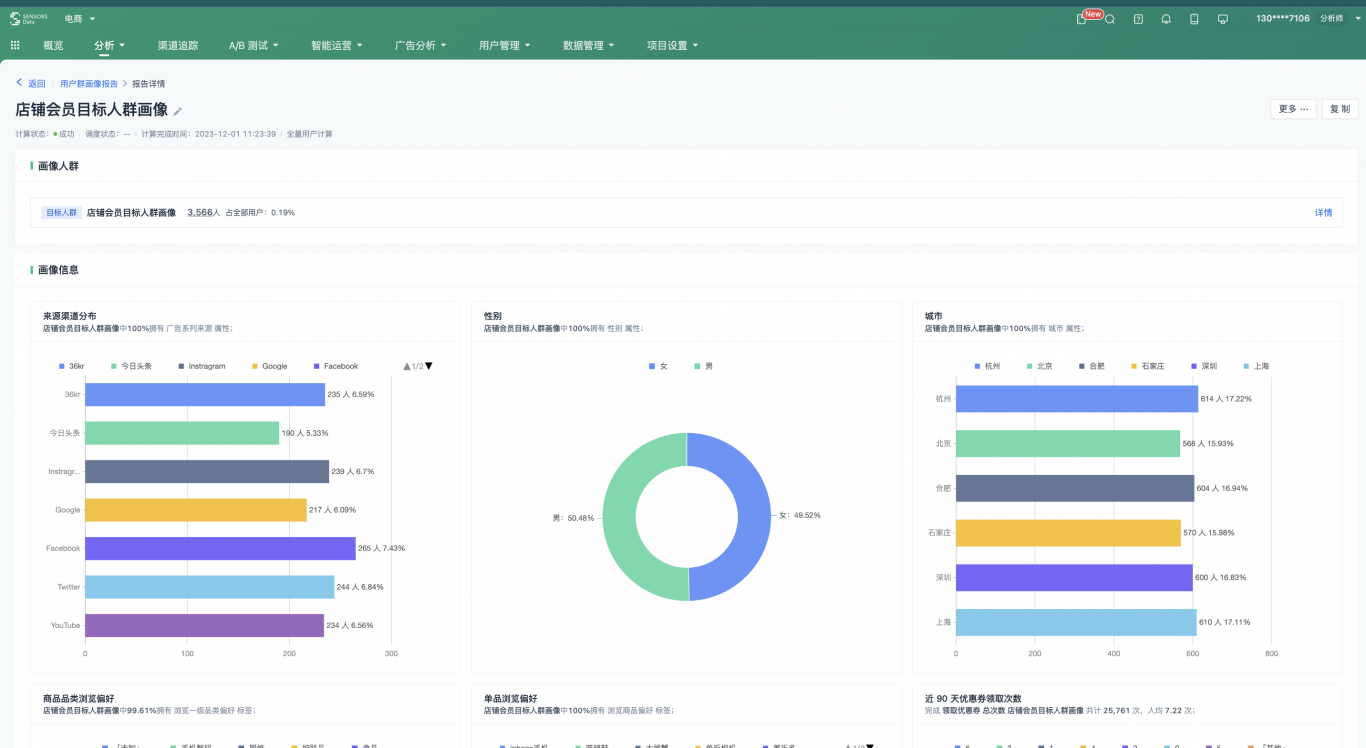
用户群画像
项目描述:重构用户群画像系统帮助企业勾勒细化群体的特征偏好,
-
智能资产可视化管理系统
系统介绍: 智能资产可视化管理系统以实物管理为基础,以物联
1小时精推人才
需求方专属客服,免费梳理匹配

