scrapy框架简介
案例介绍
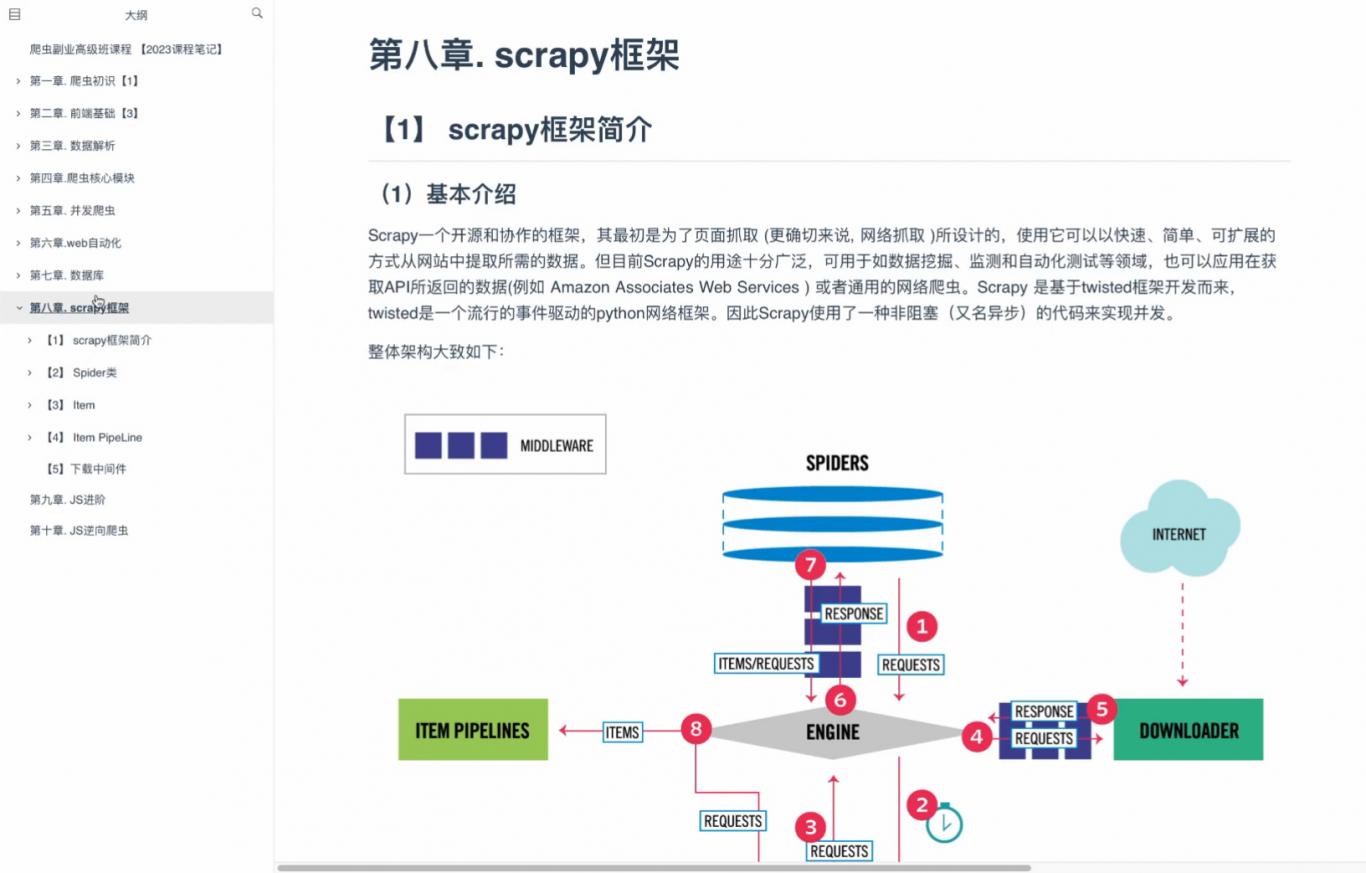
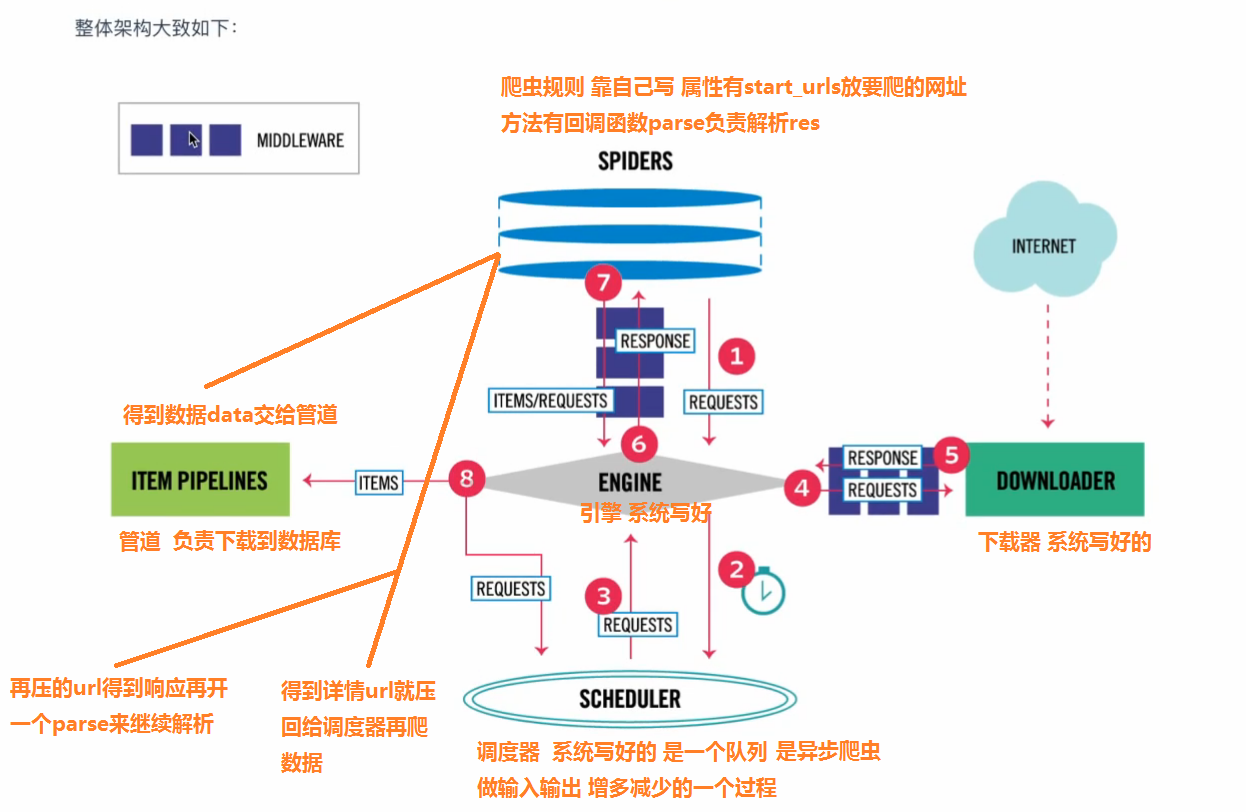
Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速、简单、可扩展的方式从网站中提取所需的数据。但目前Scrapy的用途十分广泛,可用于如数据挖掘、监测和自动化测试等领域,也可以应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫。Scrapy 是基于twisted框架开发而来,twisted是一个流行的事件驱动的python网络框架。因此Scrapy使用了一种非阻塞(又名异步)的代码来实现并发。
(2) Spider类
Spiders是定义如何抓取某个站点(或一组站点)的类,包括如何执行爬行(即跟随链接)以及如何从其页面中提取结构化数据(即抓取项目)。换句话说,Spiders是您为特定站点(或者在某些情况下,一组站点)爬网和解析页面定义自定义行为的地方。
1、 生成初始的Requests来爬取第一个URLS,并且标识一个回调函数
第一个请求定义在start_requests()方法内默认从start_urls列表中获得url地址来生成Request请求,
默认的回调函数是parse方法。回调函数在下载完成返回response时自动触发
2、 在回调函数中,解析response并且返回值
返回值可以4种:
包含解析数据的字典
Item对象
新的Request对象(新的Requests也需要指定一个回调函数)
或者是可迭代对象(包含Items或Request)
3、在回调函数中解析页面内容
通常使用Scrapy自带的Selectors,但很明显你也可以使用Beutifulsoup,lxml或其他你爱用啥用啥。
4、最后,针对返回的Items对象将会被持久化到数据库,
通过Item Pipeline组件存到数据库或者导出到不同的文件


scrapy框架简介

案例介绍
(1)基本介绍
Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速、简单、可扩展的方式从网站中提取所需的数据。但目前Scrapy的用途十分广泛,可用于如数据挖掘、监测和自动化测试等领域,也可以应用在获取API所返回的数据(例如 Amazon Associates Web Services ) 或者通用的网络爬虫。Scrapy 是基于twisted框架开发而来,twisted是一个流行的事件驱动的python网络框架。因此Scrapy使用了一种非阻塞(又名异步)的代码来实现并发。
(2) Spider类
Spiders是定义如何抓取某个站点(或一组站点)的类,包括如何执行爬行(即跟随链接)以及如何从其页面中提取结构化数据(即抓取项目)。换句话说,Spiders是您为特定站点(或者在某些情况下,一组站点)爬网和解析页面定义自定义行为的地方。
1、 生成初始的Requests来爬取第一个URLS,并且标识一个回调函数
第一个请求定义在start_requests()方法内默认从start_urls列表中获得url地址来生成Request请求,
默认的回调函数是parse方法。回调函数在下载完成返回response时自动触发
2、 在回调函数中,解析response并且返回值
返回值可以4种:
包含解析数据的字典
Item对象
新的Request对象(新的Requests也需要指定一个回调函数)
或者是可迭代对象(包含Items或Request)
3、在回调函数中解析页面内容
通常使用Scrapy自带的Selectors,但很明显你也可以使用Beutifulsoup,lxml或其他你爱用啥用啥。
4、最后,针对返回的Items对象将会被持久化到数据库,
通过Item Pipeline组件存到数据库或者导出到不同的文件
案例图片
1小时精推人才
需求方专属客服,免费梳理匹配

