叫我穆光猪
深度学习算法工程师
数字绿土 · 3年经验
日薪:
¥1000/8h
地点:
北京 海淀
时间:
下班后周六周日
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
目前有3个产品已经落地,全部为独立开发;
本人精通python语言,神经网络框架主要使用pytorch与tensorflow(1.x版本);
本人对各种点云神经网络有深刻的理解和经验,point-base、3dConv-base、GCN三个方向均有一定的涉猎,可以针对实际问题进行各种网络的对比、优化。主要方向为point-base,对pointnet++、KPconv、randla-net、PCT、MLGCN等网络的原作代码都进行过深入的理解,对采样方式及其如何应用于大场景的推理也有着独到的见解;
本人可以熟练应用点云的传统算法,如KDTree,OCTree等数据结构,体素抽稀、FPS抽稀等下采样算法,
熟练使用open3d、sklearn等算法库;
本人对各种图像网络也有着一定的技术积累,了解Yolo系列,SSD系列,CenterNet系列等end-to-end目标检测网络;
熟悉c++语言;
熟悉神经网络的序列化方法,曾经将pytorch版本的pointnet++调整为体素下采样版本并打包成.pt格式供c++端调用,也可以将常用算法打包成onnx或者.pb格式;
熟悉nvidia jetson系列嵌入式平台(TX2,nano)。
本人精通python语言,神经网络框架主要使用pytorch与tensorflow(1.x版本);
本人对各种点云神经网络有深刻的理解和经验,point-base、3dConv-base、GCN三个方向均有一定的涉猎,可以针对实际问题进行各种网络的对比、优化。主要方向为point-base,对pointnet++、KPconv、randla-net、PCT、MLGCN等网络的原作代码都进行过深入的理解,对采样方式及其如何应用于大场景的推理也有着独到的见解;
本人可以熟练应用点云的传统算法,如KDTree,OCTree等数据结构,体素抽稀、FPS抽稀等下采样算法,
熟练使用open3d、sklearn等算法库;
本人对各种图像网络也有着一定的技术积累,了解Yolo系列,SSD系列,CenterNet系列等end-to-end目标检测网络;
熟悉c++语言;
熟悉神经网络的序列化方法,曾经将pytorch版本的pointnet++调整为体素下采样版本并打包成.pt格式供c++端调用,也可以将常用算法打包成onnx或者.pb格式;
熟悉nvidia jetson系列嵌入式平台(TX2,nano)。
项目经验
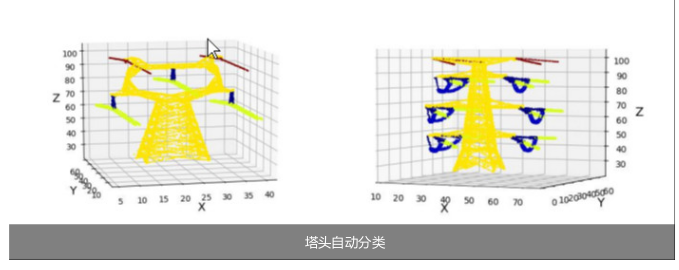
项目描述:将巡检过程中激光雷达所踩得的大场景点云数据进行语义分割(杆塔、导线、建筑物、交跨线,植被等),场景一般长度500米宽度40米高100米左右。
项目职责:算法开发。在选用backbone的时候考虑了如下问题,1)算法需要部署在客户端,故不能把算法设计的过于重型,需要考虑速度问题;2)由于公司内外网问题,训练显卡设备极其简陋(Windows平台下的1660ti)。所以首先想到使用randla-net作为基准网络,但是在实验过程中即使是使用原作的kitti版本参数(相对s3dis版本较小,5层下采样变为4层,点数由65535变为4万多),但是显卡只能承受batchsize最大为2,导致结果太差(BN为eval时仅为23.6,BN为train时反而为62.1)。后面又试验过清华版本的PCT,但是PCT的整体表达能力有点儿不够,在小场景实验的分类细节上不够理想。最后还回到了kpconv,应对计算资源不够时考虑到场景的复杂度没有公开数据集那么高,将整体通道数降低了4倍来换取更大的batchsize;在训练时由于场景样本及其不平衡的关系,如果使用potential采样的话小类的IOU一直为0,我最终人工干预原作中的balance采样方法,让小类能够更多的采集到,提升了整体的IOU,最终整体mIOU能达到75.6%。还尝试将二元交叉熵损失替换成focal-loss,但是实验效果并不好,一样会导致小类的准确率出不来。在预测时使用potential采样方式,为了加快速度,将potential的权重阈值从10降低到2,达到一个投影面积500*40的空间中3分钟预测完毕。
项目职责:算法开发。在选用backbone的时候考虑了如下问题,1)算法需要部署在客户端,故不能把算法设计的过于重型,需要考虑速度问题;2)由于公司内外网问题,训练显卡设备极其简陋(Windows平台下的1660ti)。所以首先想到使用randla-net作为基准网络,但是在实验过程中即使是使用原作的kitti版本参数(相对s3dis版本较小,5层下采样变为4层,点数由65535变为4万多),但是显卡只能承受batchsize最大为2,导致结果太差(BN为eval时仅为23.6,BN为train时反而为62.1)。后面又试验过清华版本的PCT,但是PCT的整体表达能力有点儿不够,在小场景实验的分类细节上不够理想。最后还回到了kpconv,应对计算资源不够时考虑到场景的复杂度没有公开数据集那么高,将整体通道数降低了4倍来换取更大的batchsize;在训练时由于场景样本及其不平衡的关系,如果使用potential采样的话小类的IOU一直为0,我最终人工干预原作中的balance采样方法,让小类能够更多的采集到,提升了整体的IOU,最终整体mIOU能达到75.6%。还尝试将二元交叉熵损失替换成focal-loss,但是实验效果并不好,一样会导致小类的准确率出不来。在预测时使用potential采样方式,为了加快速度,将potential的权重阈值从10降低到2,达到一个投影面积500*40的空间中3分钟预测完毕。
案例展示 全部案例 >


叫我穆光猪
深度学习算法工程师 · 3年经验 · 数字绿土
0
累计接单
0
用户评价
1
被收藏
信用行为
0
接单数
0
评价数
1
收藏数
技术能力
目前有3个产品已经落地,全部为独立开发;
本人精通python语言,神经网络框架主要使用pytorch与tensorflow(1.x版本);
本人对各种点云神经网络有深刻的理解和经验,point-base、3dConv-base、GCN三个方向均有一定的涉猎,可以针对实际问题进行各种网络的对比、优化。主要方向为point-base,对pointnet++、KPconv、randla-net、PCT、MLGCN等网络的原作代码都进行过深入的理解,对采样方式及其如何应用于大场景的推理也有着独到的见解;
本人可以熟练应用点云的传统算法,如KDTree,OCTree等数据结构,体素抽稀、FPS抽稀等下采样算法,
熟练使用open3d、sklearn等算法库;
本人对各种图像网络也有着一定的技术积累,了解Yolo系列,SSD系列,CenterNet系列等end-to-end目标检测网络;
熟悉c++语言;
熟悉神经网络的序列化方法,曾经将pytorch版本的pointnet++调整为体素下采样版本并打包成.pt格式供c++端调用,也可以将常用算法打包成onnx或者.pb格式;
熟悉nvidia jetson系列嵌入式平台(TX2,nano)。
本人精通python语言,神经网络框架主要使用pytorch与tensorflow(1.x版本);
本人对各种点云神经网络有深刻的理解和经验,point-base、3dConv-base、GCN三个方向均有一定的涉猎,可以针对实际问题进行各种网络的对比、优化。主要方向为point-base,对pointnet++、KPconv、randla-net、PCT、MLGCN等网络的原作代码都进行过深入的理解,对采样方式及其如何应用于大场景的推理也有着独到的见解;
本人可以熟练应用点云的传统算法,如KDTree,OCTree等数据结构,体素抽稀、FPS抽稀等下采样算法,
熟练使用open3d、sklearn等算法库;
本人对各种图像网络也有着一定的技术积累,了解Yolo系列,SSD系列,CenterNet系列等end-to-end目标检测网络;
熟悉c++语言;
熟悉神经网络的序列化方法,曾经将pytorch版本的pointnet++调整为体素下采样版本并打包成.pt格式供c++端调用,也可以将常用算法打包成onnx或者.pb格式;
熟悉nvidia jetson系列嵌入式平台(TX2,nano)。
项目经验
项目描述:将巡检过程中激光雷达所踩得的大场景点云数据进行语义分割(杆塔、导线、建筑物、交跨线,植被等),场景一般长度500米宽度40米高100米左右。
项目职责:算法开发。在选用backbone的时候考虑了如下问题,1)算法需要部署在客户端,故不能把算法设计的过于重型,需要考虑速度问题;2)由于公司内外网问题,训练显卡设备极其简陋(Windows平台下的1660ti)。所以首先想到使用randla-net作为基准网络,但是在实验过程中即使是使用原作的kitti版本参数(相对s3dis版本较小,5层下采样变为4层,点数由65535变为4万多),但是显卡只能承受batchsize最大为2,导致结果太差(BN为eval时仅为23.6,BN为train时反而为62.1)。后面又试验过清华版本的PCT,但是PCT的整体表达能力有点儿不够,在小场景实验的分类细节上不够理想。最后还回到了kpconv,应对计算资源不够时考虑到场景的复杂度没有公开数据集那么高,将整体通道数降低了4倍来换取更大的batchsize;在训练时由于场景样本及其不平衡的关系,如果使用potential采样的话小类的IOU一直为0,我最终人工干预原作中的balance采样方法,让小类能够更多的采集到,提升了整体的IOU,最终整体mIOU能达到75.6%。还尝试将二元交叉熵损失替换成focal-loss,但是实验效果并不好,一样会导致小类的准确率出不来。在预测时使用potential采样方式,为了加快速度,将potential的权重阈值从10降低到2,达到一个投影面积500*40的空间中3分钟预测完毕。
项目职责:算法开发。在选用backbone的时候考虑了如下问题,1)算法需要部署在客户端,故不能把算法设计的过于重型,需要考虑速度问题;2)由于公司内外网问题,训练显卡设备极其简陋(Windows平台下的1660ti)。所以首先想到使用randla-net作为基准网络,但是在实验过程中即使是使用原作的kitti版本参数(相对s3dis版本较小,5层下采样变为4层,点数由65535变为4万多),但是显卡只能承受batchsize最大为2,导致结果太差(BN为eval时仅为23.6,BN为train时反而为62.1)。后面又试验过清华版本的PCT,但是PCT的整体表达能力有点儿不够,在小场景实验的分类细节上不够理想。最后还回到了kpconv,应对计算资源不够时考虑到场景的复杂度没有公开数据集那么高,将整体通道数降低了4倍来换取更大的batchsize;在训练时由于场景样本及其不平衡的关系,如果使用potential采样的话小类的IOU一直为0,我最终人工干预原作中的balance采样方法,让小类能够更多的采集到,提升了整体的IOU,最终整体mIOU能达到75.6%。还尝试将二元交叉熵损失替换成focal-loss,但是实验效果并不好,一样会导致小类的准确率出不来。在预测时使用potential采样方式,为了加快速度,将potential的权重阈值从10降低到2,达到一个投影面积500*40的空间中3分钟预测完毕。
案例展示

 立即沟通
相似人才推荐:
厦门上位机开发工程师 (厦门容大合众电子科技有限公司) ,3年经验 ,1000元/天
广州Qt工程师 (广州视海科技有限公司) ,2年经验 ,500元/天
广州承接功能和项目开发 (广州市花都区新华泳安电脑经营部) ,15年经验 ,500元/天
杭州计算机硕士 (中国科学院国家空间科学中心) ,1年经验 ,500元/天
北京员工 (用友) ,10年经验 ,500元/天
南京qt开发工程师 (上海微电子) ,4年经验 ,500元/天
北京在读应用数学博士 (中国科学院) ,2年经验 ,500元/天
山东c# unity MATLAB python (潍坊科技学院) ,10年经验 ,1000元/天


