厂长是我表郭
爬虫工程师
勿思量网络科技 · 1年经验
日薪:
¥500/8h
地点:
兰州 全区
时间:
下班后周六周日
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1.刚开始写脚本的时候经常忘记带 request headers,特别是host和user-agent这俩个字段(通常带这两个就足够了),这个就是体现在对http协议理解不够。具体是哪个网站我忘了,我因为没有带上ua,一直拿不到html,耽搁我不少的时间。
因为网站会检擦你的 request headers 中的host,如果不对,好的你拿不到数据,然后是检测你的ua,嗯?什么是ua,就是User-Agent,不同的浏览器有不同的ua,也是爬虫伪装浏览器的第一步。
2.关于cookies,这个我就遇到过一次,也是我上一份工作中遇到的,我要拿数据的那个网站,分析了url,确定了参数,post过去,嗯?怎么是空网页,数据喃。
这里我们在用浏览器的开发者工具时,在network里要关注所出现的各种url。后来我注意到在每次post后还有一个url紧跟着请求,原来这个post请求数据是个障眼法。
所以呢,这个就是网站通过post请求把参数放到cookies里,然后到了真正出数据的url里,在请求时带上刚刚的cookies,服务器在读取完cookies接着就能看到数据了。
3.接下来就是ip的访问频率了。
我在入职现在这份工作时,老大让我在xx网抓一份全国的旅行社数据,结果我的ip被ban,整个公司那一周都不能上那网站。所以,当我给老大汇报这个事情的时候,老大淡淡说了句,你当人家网站的运维吃屎的么。
同时,在这里作为一名爬虫工程师,基本的职业素养就包括,好比隔壁组坐着一个漂亮的菇凉,咱们看看就好了,不要去影响人家。所以说,在每两次请求间一定要有时延。这里我不是说,咱们通过测试来摸索出该网站的rps(request per second),然后就着rps来跑,这样的确算是提高效率的方法,但是我偷懒,统一设置为10秒的时延。
但是,处理办法有好几种。
一,每一次请求时变更ua,就可以理解为学校机房里,大家同时访问一个url,难不成就把这个机房的ip给ban了?
二,在request headers里带上 referer,既然是模拟人的操作,那就在每一次请求的headers的referer里带上上一次的请求url。什么?referer是做什么的,这个就是告诉服务器我是从哪一个url来到哪一个url去。
三, 设置时延,这个不解释,我们抓数据的同时不能给服务器造成太大压力,也不能影响别人的浏览体验。
因为网站会检擦你的 request headers 中的host,如果不对,好的你拿不到数据,然后是检测你的ua,嗯?什么是ua,就是User-Agent,不同的浏览器有不同的ua,也是爬虫伪装浏览器的第一步。
2.关于cookies,这个我就遇到过一次,也是我上一份工作中遇到的,我要拿数据的那个网站,分析了url,确定了参数,post过去,嗯?怎么是空网页,数据喃。
这里我们在用浏览器的开发者工具时,在network里要关注所出现的各种url。后来我注意到在每次post后还有一个url紧跟着请求,原来这个post请求数据是个障眼法。
所以呢,这个就是网站通过post请求把参数放到cookies里,然后到了真正出数据的url里,在请求时带上刚刚的cookies,服务器在读取完cookies接着就能看到数据了。
3.接下来就是ip的访问频率了。
我在入职现在这份工作时,老大让我在xx网抓一份全国的旅行社数据,结果我的ip被ban,整个公司那一周都不能上那网站。所以,当我给老大汇报这个事情的时候,老大淡淡说了句,你当人家网站的运维吃屎的么。
同时,在这里作为一名爬虫工程师,基本的职业素养就包括,好比隔壁组坐着一个漂亮的菇凉,咱们看看就好了,不要去影响人家。所以说,在每两次请求间一定要有时延。这里我不是说,咱们通过测试来摸索出该网站的rps(request per second),然后就着rps来跑,这样的确算是提高效率的方法,但是我偷懒,统一设置为10秒的时延。
但是,处理办法有好几种。
一,每一次请求时变更ua,就可以理解为学校机房里,大家同时访问一个url,难不成就把这个机房的ip给ban了?
二,在request headers里带上 referer,既然是模拟人的操作,那就在每一次请求的headers的referer里带上上一次的请求url。什么?referer是做什么的,这个就是告诉服务器我是从哪一个url来到哪一个url去。
三, 设置时延,这个不解释,我们抓数据的同时不能给服务器造成太大压力,也不能影响别人的浏览体验。
项目经验
项目名称:通过异步爬虫爬取HGMD,构建mysql数据库
项目描述:
项目介绍
对高通量测序数据进行数据分析时,需要对snp数据进行相关性筛选,为此需要构建基于mysql的基因突变数据库,对HGMD网站相关基因突变信息进行爬取,爬取内容包括基因名,染色体坐标,突变信息,致病信息等。爬取结果存储于mysql。
我的职责
1,采用asyncio+aiohttp以达成高并发,异步请求。
2,通过timeout设置超时重发机制,因为HGMD为国外网站,防止因为网络卡顿导致页面抓取不到产生数据不全的现象。
3,通过继承aiohttp.ClientSession类来保存cookie对象,以应对基于cookie的反扒策略
4,使用xpath进行页面解析,解析出的数据通过PyMysql模块存储于mysql数据库中
项目描述:
项目介绍
对高通量测序数据进行数据分析时,需要对snp数据进行相关性筛选,为此需要构建基于mysql的基因突变数据库,对HGMD网站相关基因突变信息进行爬取,爬取内容包括基因名,染色体坐标,突变信息,致病信息等。爬取结果存储于mysql。
我的职责
1,采用asyncio+aiohttp以达成高并发,异步请求。
2,通过timeout设置超时重发机制,因为HGMD为国外网站,防止因为网络卡顿导致页面抓取不到产生数据不全的现象。
3,通过继承aiohttp.ClientSession类来保存cookie对象,以应对基于cookie的反扒策略
4,使用xpath进行页面解析,解析出的数据通过PyMysql模块存储于mysql数据库中
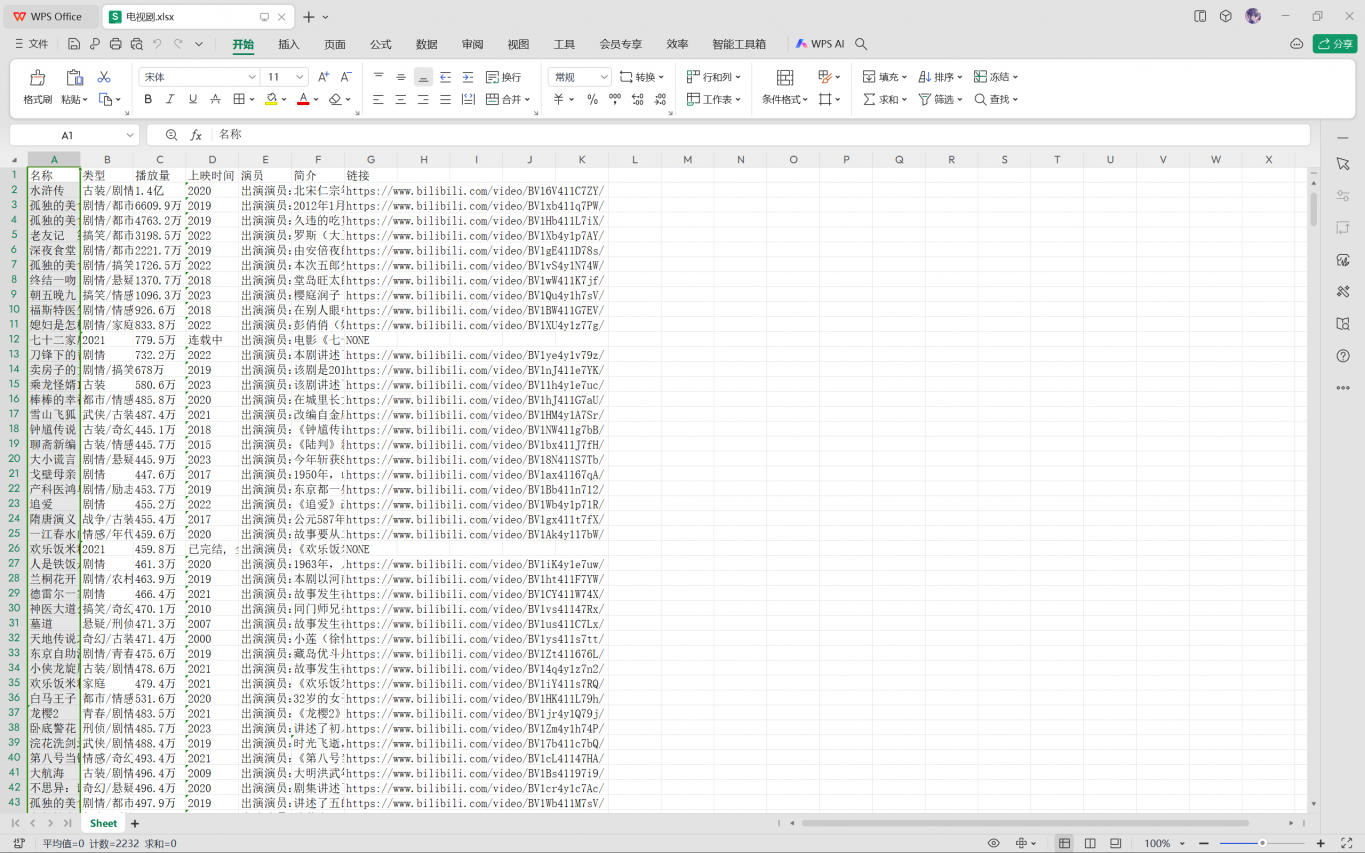
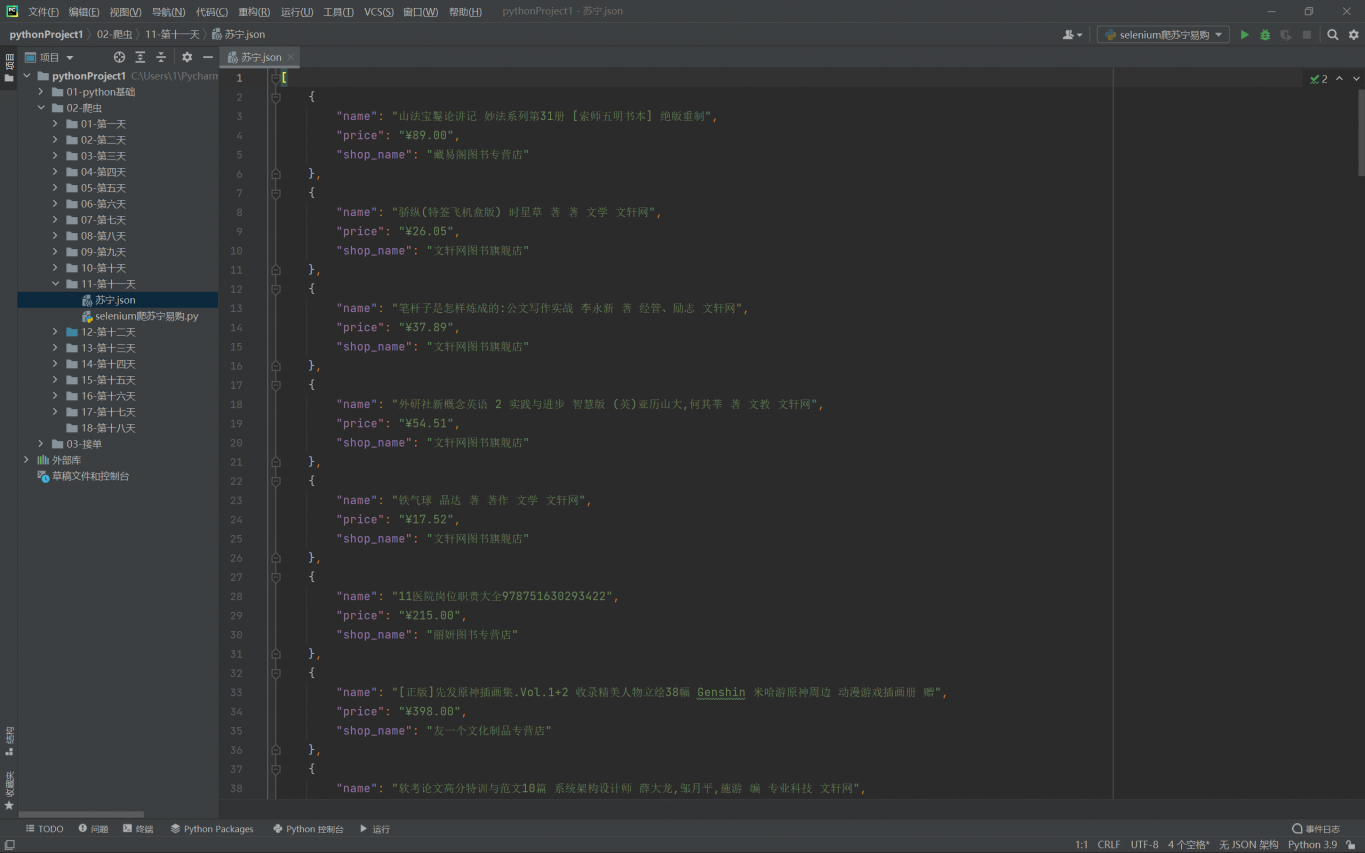
案例展示 全部案例 >


厂长是我表郭
爬虫工程师 · 1年经验 · 勿思量网络科技
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
1.刚开始写脚本的时候经常忘记带 request headers,特别是host和user-agent这俩个字段(通常带这两个就足够了),这个就是体现在对http协议理解不够。具体是哪个网站我忘了,我因为没有带上ua,一直拿不到html,耽搁我不少的时间。
因为网站会检擦你的 request headers 中的host,如果不对,好的你拿不到数据,然后是检测你的ua,嗯?什么是ua,就是User-Agent,不同的浏览器有不同的ua,也是爬虫伪装浏览器的第一步。
2.关于cookies,这个我就遇到过一次,也是我上一份工作中遇到的,我要拿数据的那个网站,分析了url,确定了参数,post过去,嗯?怎么是空网页,数据喃。
这里我们在用浏览器的开发者工具时,在network里要关注所出现的各种url。后来我注意到在每次post后还有一个url紧跟着请求,原来这个post请求数据是个障眼法。
所以呢,这个就是网站通过post请求把参数放到cookies里,然后到了真正出数据的url里,在请求时带上刚刚的cookies,服务器在读取完cookies接着就能看到数据了。
3.接下来就是ip的访问频率了。
我在入职现在这份工作时,老大让我在xx网抓一份全国的旅行社数据,结果我的ip被ban,整个公司那一周都不能上那网站。所以,当我给老大汇报这个事情的时候,老大淡淡说了句,你当人家网站的运维吃屎的么。
同时,在这里作为一名爬虫工程师,基本的职业素养就包括,好比隔壁组坐着一个漂亮的菇凉,咱们看看就好了,不要去影响人家。所以说,在每两次请求间一定要有时延。这里我不是说,咱们通过测试来摸索出该网站的rps(request per second),然后就着rps来跑,这样的确算是提高效率的方法,但是我偷懒,统一设置为10秒的时延。
但是,处理办法有好几种。
一,每一次请求时变更ua,就可以理解为学校机房里,大家同时访问一个url,难不成就把这个机房的ip给ban了?
二,在request headers里带上 referer,既然是模拟人的操作,那就在每一次请求的headers的referer里带上上一次的请求url。什么?referer是做什么的,这个就是告诉服务器我是从哪一个url来到哪一个url去。
三, 设置时延,这个不解释,我们抓数据的同时不能给服务器造成太大压力,也不能影响别人的浏览体验。
因为网站会检擦你的 request headers 中的host,如果不对,好的你拿不到数据,然后是检测你的ua,嗯?什么是ua,就是User-Agent,不同的浏览器有不同的ua,也是爬虫伪装浏览器的第一步。
2.关于cookies,这个我就遇到过一次,也是我上一份工作中遇到的,我要拿数据的那个网站,分析了url,确定了参数,post过去,嗯?怎么是空网页,数据喃。
这里我们在用浏览器的开发者工具时,在network里要关注所出现的各种url。后来我注意到在每次post后还有一个url紧跟着请求,原来这个post请求数据是个障眼法。
所以呢,这个就是网站通过post请求把参数放到cookies里,然后到了真正出数据的url里,在请求时带上刚刚的cookies,服务器在读取完cookies接着就能看到数据了。
3.接下来就是ip的访问频率了。
我在入职现在这份工作时,老大让我在xx网抓一份全国的旅行社数据,结果我的ip被ban,整个公司那一周都不能上那网站。所以,当我给老大汇报这个事情的时候,老大淡淡说了句,你当人家网站的运维吃屎的么。
同时,在这里作为一名爬虫工程师,基本的职业素养就包括,好比隔壁组坐着一个漂亮的菇凉,咱们看看就好了,不要去影响人家。所以说,在每两次请求间一定要有时延。这里我不是说,咱们通过测试来摸索出该网站的rps(request per second),然后就着rps来跑,这样的确算是提高效率的方法,但是我偷懒,统一设置为10秒的时延。
但是,处理办法有好几种。
一,每一次请求时变更ua,就可以理解为学校机房里,大家同时访问一个url,难不成就把这个机房的ip给ban了?
二,在request headers里带上 referer,既然是模拟人的操作,那就在每一次请求的headers的referer里带上上一次的请求url。什么?referer是做什么的,这个就是告诉服务器我是从哪一个url来到哪一个url去。
三, 设置时延,这个不解释,我们抓数据的同时不能给服务器造成太大压力,也不能影响别人的浏览体验。
项目经验
项目名称:通过异步爬虫爬取HGMD,构建mysql数据库
项目描述:
项目介绍
对高通量测序数据进行数据分析时,需要对snp数据进行相关性筛选,为此需要构建基于mysql的基因突变数据库,对HGMD网站相关基因突变信息进行爬取,爬取内容包括基因名,染色体坐标,突变信息,致病信息等。爬取结果存储于mysql。
我的职责
1,采用asyncio+aiohttp以达成高并发,异步请求。
2,通过timeout设置超时重发机制,因为HGMD为国外网站,防止因为网络卡顿导致页面抓取不到产生数据不全的现象。
3,通过继承aiohttp.ClientSession类来保存cookie对象,以应对基于cookie的反扒策略
4,使用xpath进行页面解析,解析出的数据通过PyMysql模块存储于mysql数据库中
项目描述:
项目介绍
对高通量测序数据进行数据分析时,需要对snp数据进行相关性筛选,为此需要构建基于mysql的基因突变数据库,对HGMD网站相关基因突变信息进行爬取,爬取内容包括基因名,染色体坐标,突变信息,致病信息等。爬取结果存储于mysql。
我的职责
1,采用asyncio+aiohttp以达成高并发,异步请求。
2,通过timeout设置超时重发机制,因为HGMD为国外网站,防止因为网络卡顿导致页面抓取不到产生数据不全的现象。
3,通过继承aiohttp.ClientSession类来保存cookie对象,以应对基于cookie的反扒策略
4,使用xpath进行页面解析,解析出的数据通过PyMysql模块存储于mysql数据库中

 立即沟通


