不做梵高
无
无 · 1年经验
日薪:
¥500/8h
地点:
乌鲁木齐 全区
时间:
可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
作为一名技术顾问,我在Python领域拥有丰富的知识和实践经验。我精通Python编程语言,能够熟练使用其核心库和第三方库进行数据处理、数据分析、机器学习、网络编程等。我熟悉常见的数据结构和算法,能够高效地解决复杂问题。此外,我还具备良好的软件工程实践,能够进行模块化设计、代码优化和测试,确保软件的可维护性和可扩展性。我能够运用Python进行Web开发,熟悉Django、Flask等框架,能够开发高性能、高可用性的Web应用。同时,我也具备一定的系统架构设计能力,能够为企业提供全面的技术解决方案。
项目经验
1. 新闻资讯爬虫:我设计并实现了一个高效的新闻资讯爬虫系统,能够自动抓取多个新闻网站的实时内容。项目中使用了Python的requests库进行网络请求,BeautifulSoup进行HTML解析,以及Scrapy框架进行大规模数据抓取。通过这个项目,我不仅提升了对网络爬虫技术的理解,还学会了如何处理反爬虫策略。
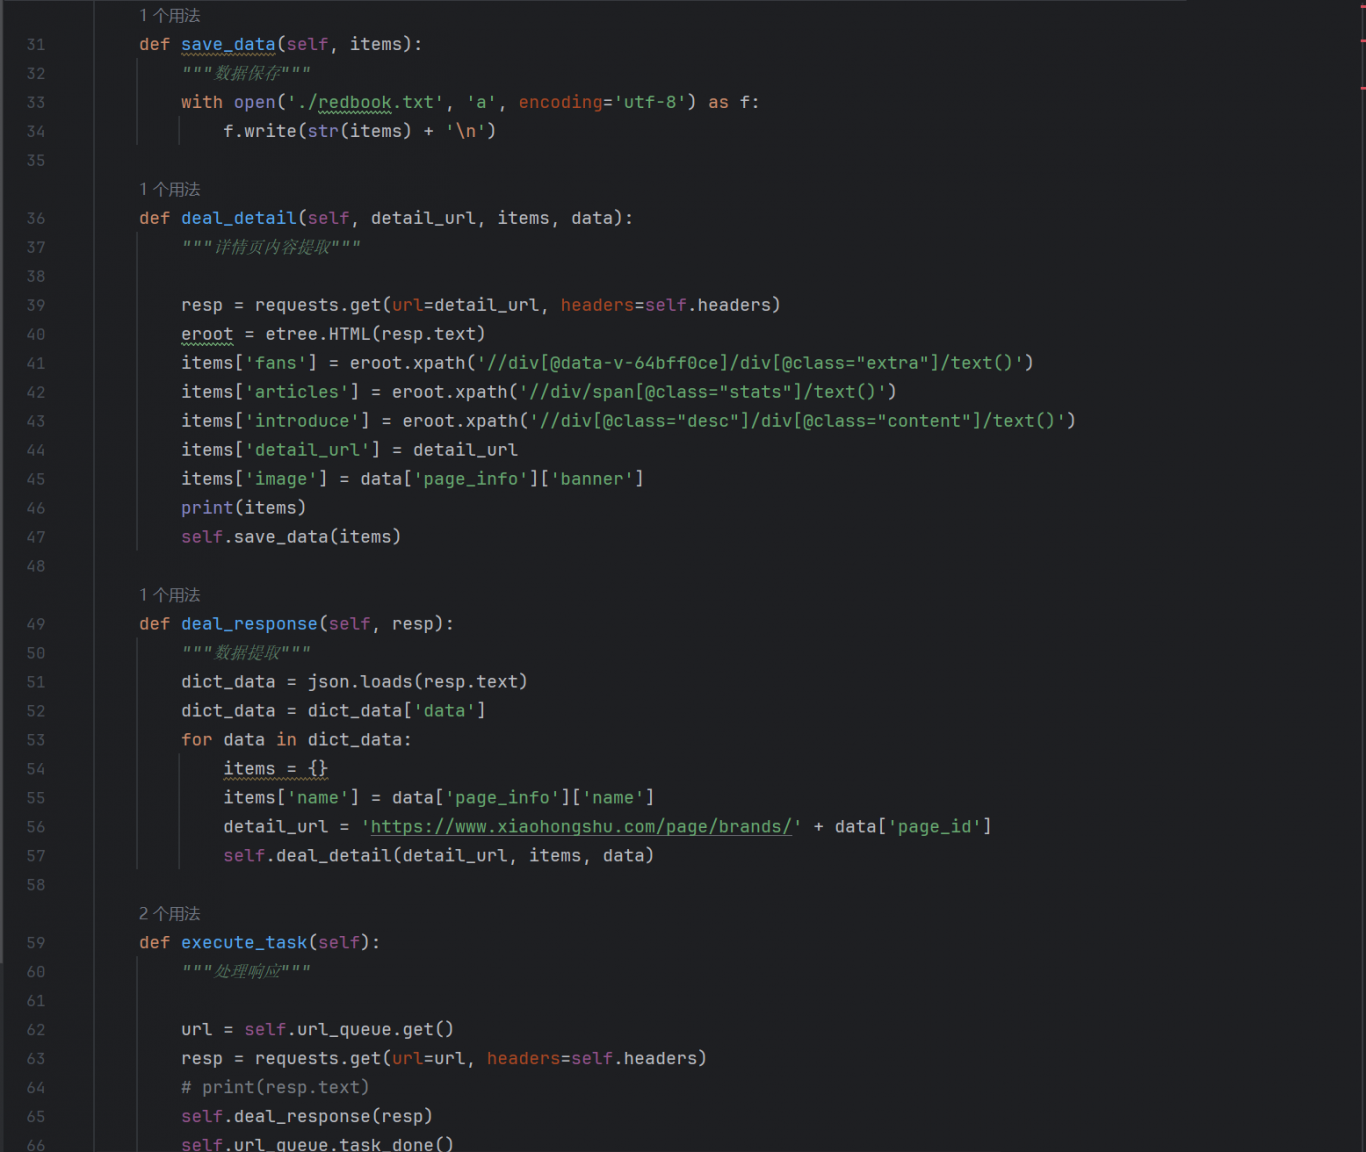
2. 社交媒体数据爬取:我负责开发了一个社交媒体数据爬虫,用于收集和分析社交媒体上的用户行为和内容。项目中使用了Python的Selenium库与PhantomJS驱动,模拟浏览器行为进行数据抓取。同时,我还设计了一套数据清洗和存储流程,确保数据的准确性和可用性。
3. 电子商务网站数据爬虫:我主导了一个电子商务网站数据爬虫项目,目标是抓取商品信息、用户评论和销售数据。项目中使用了Python的Scrapy框架和Redis进行分布式爬虫管理,实现了高效的数据抓取和存储。通过这个项目,我深入理解了分布式爬虫的架构和优化策略。
4. 动态网站爬虫:我参与开发了一个能够处理动态网页的爬虫系统,使用了Python的Scrapy框架和Splash进行动态内容抓取。这个项目特别注重于处理JavaScript渲染的页面,通过Splash将动态内容转换为静态内容,从而进行有效抓取。这个项目提升了我对动态网页抓取技术的理解。
2. 社交媒体数据爬取:我负责开发了一个社交媒体数据爬虫,用于收集和分析社交媒体上的用户行为和内容。项目中使用了Python的Selenium库与PhantomJS驱动,模拟浏览器行为进行数据抓取。同时,我还设计了一套数据清洗和存储流程,确保数据的准确性和可用性。
3. 电子商务网站数据爬虫:我主导了一个电子商务网站数据爬虫项目,目标是抓取商品信息、用户评论和销售数据。项目中使用了Python的Scrapy框架和Redis进行分布式爬虫管理,实现了高效的数据抓取和存储。通过这个项目,我深入理解了分布式爬虫的架构和优化策略。
4. 动态网站爬虫:我参与开发了一个能够处理动态网页的爬虫系统,使用了Python的Scrapy框架和Splash进行动态内容抓取。这个项目特别注重于处理JavaScript渲染的页面,通过Splash将动态内容转换为静态内容,从而进行有效抓取。这个项目提升了我对动态网页抓取技术的理解。

不做梵高
无 · 1年经验 · 无
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
作为一名技术顾问,我在Python领域拥有丰富的知识和实践经验。我精通Python编程语言,能够熟练使用其核心库和第三方库进行数据处理、数据分析、机器学习、网络编程等。我熟悉常见的数据结构和算法,能够高效地解决复杂问题。此外,我还具备良好的软件工程实践,能够进行模块化设计、代码优化和测试,确保软件的可维护性和可扩展性。我能够运用Python进行Web开发,熟悉Django、Flask等框架,能够开发高性能、高可用性的Web应用。同时,我也具备一定的系统架构设计能力,能够为企业提供全面的技术解决方案。
项目经验
1. 新闻资讯爬虫:我设计并实现了一个高效的新闻资讯爬虫系统,能够自动抓取多个新闻网站的实时内容。项目中使用了Python的requests库进行网络请求,BeautifulSoup进行HTML解析,以及Scrapy框架进行大规模数据抓取。通过这个项目,我不仅提升了对网络爬虫技术的理解,还学会了如何处理反爬虫策略。
2. 社交媒体数据爬取:我负责开发了一个社交媒体数据爬虫,用于收集和分析社交媒体上的用户行为和内容。项目中使用了Python的Selenium库与PhantomJS驱动,模拟浏览器行为进行数据抓取。同时,我还设计了一套数据清洗和存储流程,确保数据的准确性和可用性。
3. 电子商务网站数据爬虫:我主导了一个电子商务网站数据爬虫项目,目标是抓取商品信息、用户评论和销售数据。项目中使用了Python的Scrapy框架和Redis进行分布式爬虫管理,实现了高效的数据抓取和存储。通过这个项目,我深入理解了分布式爬虫的架构和优化策略。
4. 动态网站爬虫:我参与开发了一个能够处理动态网页的爬虫系统,使用了Python的Scrapy框架和Splash进行动态内容抓取。这个项目特别注重于处理JavaScript渲染的页面,通过Splash将动态内容转换为静态内容,从而进行有效抓取。这个项目提升了我对动态网页抓取技术的理解。
2. 社交媒体数据爬取:我负责开发了一个社交媒体数据爬虫,用于收集和分析社交媒体上的用户行为和内容。项目中使用了Python的Selenium库与PhantomJS驱动,模拟浏览器行为进行数据抓取。同时,我还设计了一套数据清洗和存储流程,确保数据的准确性和可用性。
3. 电子商务网站数据爬虫:我主导了一个电子商务网站数据爬虫项目,目标是抓取商品信息、用户评论和销售数据。项目中使用了Python的Scrapy框架和Redis进行分布式爬虫管理,实现了高效的数据抓取和存储。通过这个项目,我深入理解了分布式爬虫的架构和优化策略。
4. 动态网站爬虫:我参与开发了一个能够处理动态网页的爬虫系统,使用了Python的Scrapy框架和Splash进行动态内容抓取。这个项目特别注重于处理JavaScript渲染的页面,通过Splash将动态内容转换为静态内容,从而进行有效抓取。这个项目提升了我对动态网页抓取技术的理解。

 立即沟通


