scrapy-redis之盗墓笔记
微信扫码沟通,客服可协助直接对接工程师;如当前档期不合,也可继续推荐相似案例作者。
案例介绍
由于爬取数量较多为提高爬取速度选择用scrapy-redis分布式爬取
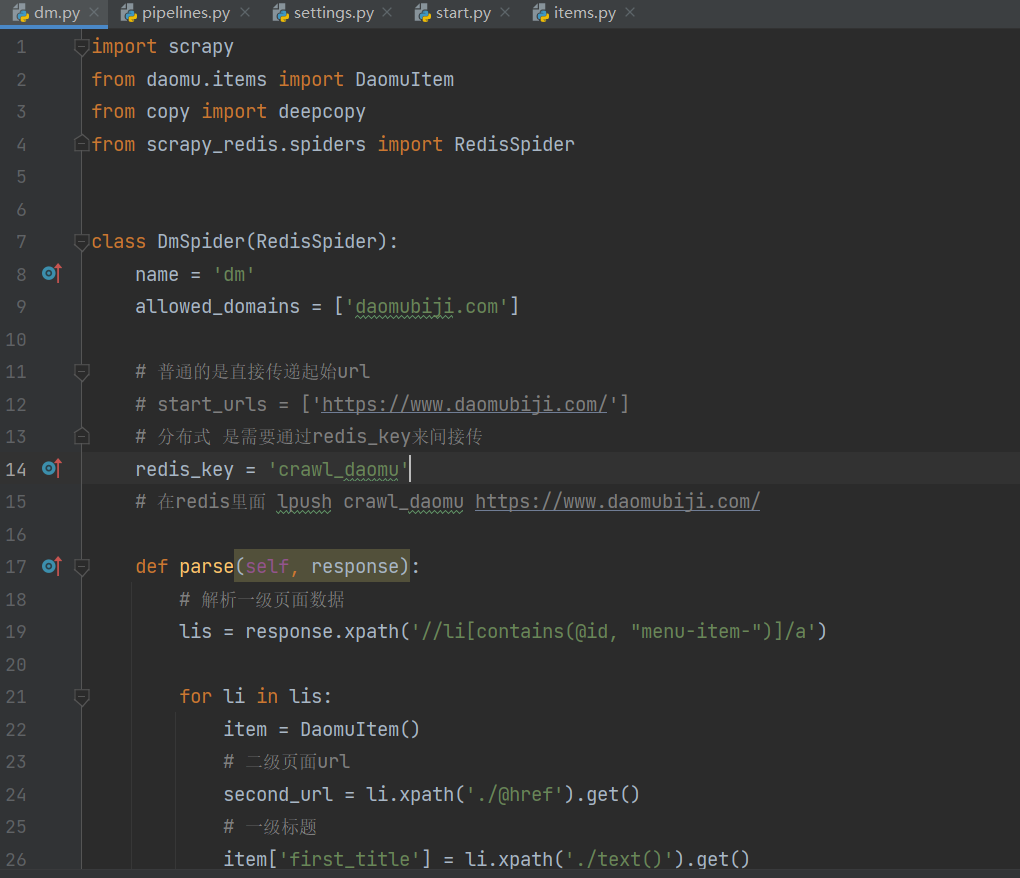
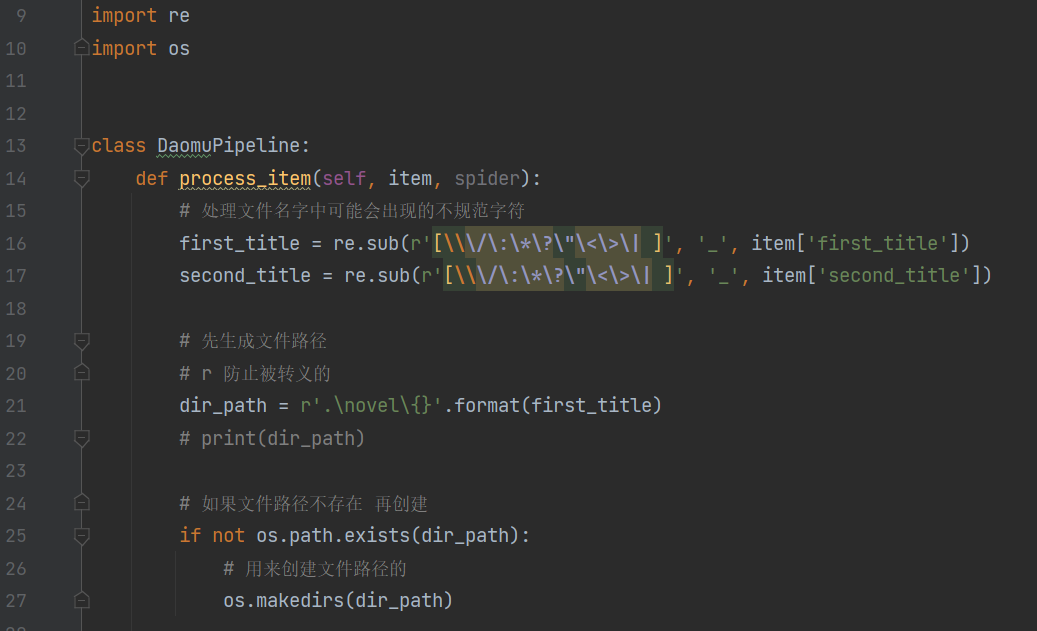
首先先分析网页,需要从一级页面获取大标题和二级页面的url,从二级页面获取各章节名称和三级页面url,在三级页面获取小说具体各章节的文本呢内容,再编写爬虫程序,运用xpath解析,再保存数据,再setting中设置请求头和redis等设置
首先先分析网页,需要从一级页面获取大标题和二级页面的url,从二级页面获取各章节名称和三级页面url,在三级页面获取小说具体各章节的文本呢内容,再编写爬虫程序,运用xpath解析,再保存数据,再setting中设置请求头和redis等设置


scrapy-redis之盗墓笔记
联系该工程师

微信扫码,建群沟通
案例介绍
由于爬取数量较多为提高爬取速度选择用scrapy-redis分布式爬取
首先先分析网页,需要从一级页面获取大标题和二级页面的url,从二级页面获取各章节名称和三级页面url,在三级页面获取小说具体各章节的文本呢内容,再编写爬虫程序,运用xpath解析,再保存数据,再setting中设置请求头和redis等设置
案例图片
1小时精推人才
需求方专属客服,免费梳理匹配

扫码加微信 · 客服人工对接
