阿白的案例列表
作者:阿白 · 共 3 个案例
scrapy-redis之盗墓笔记
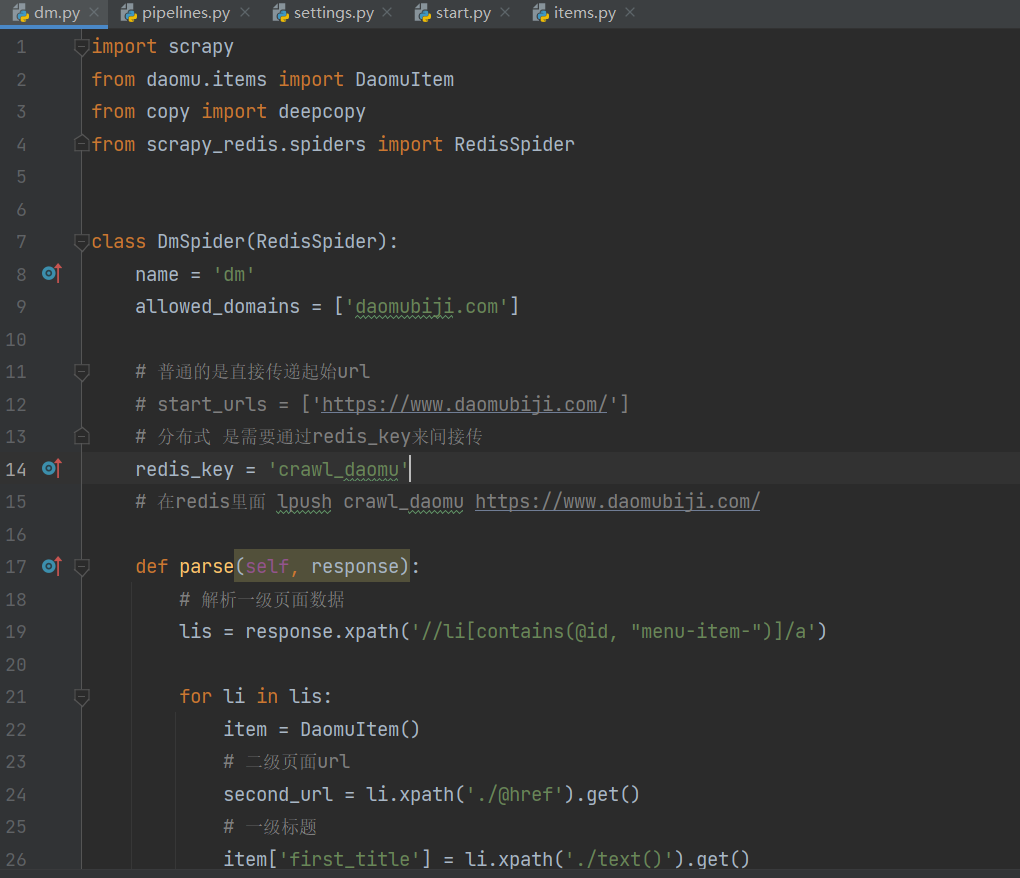
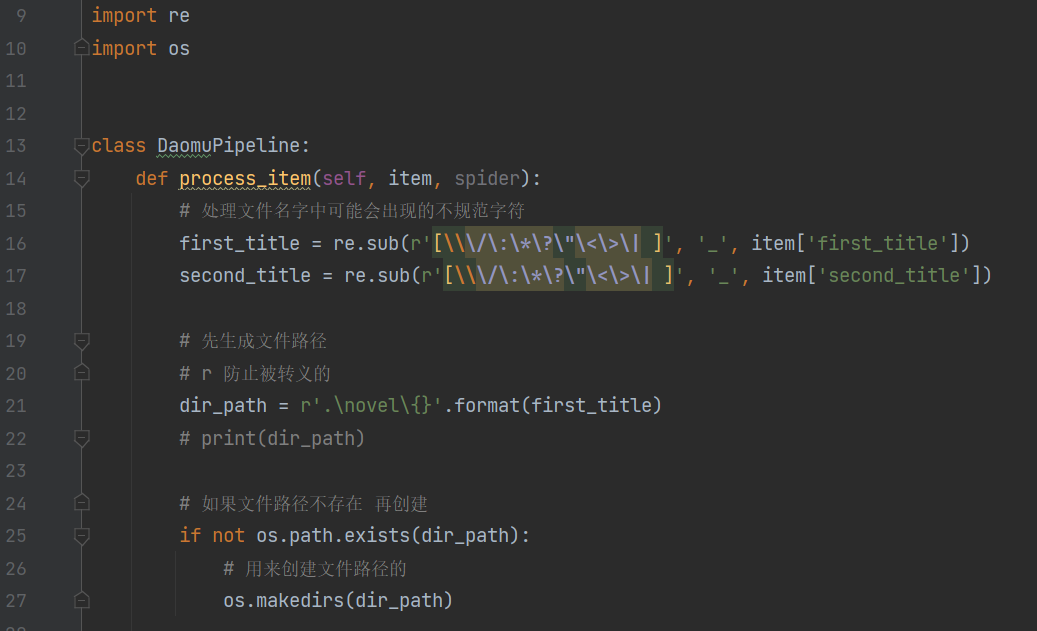
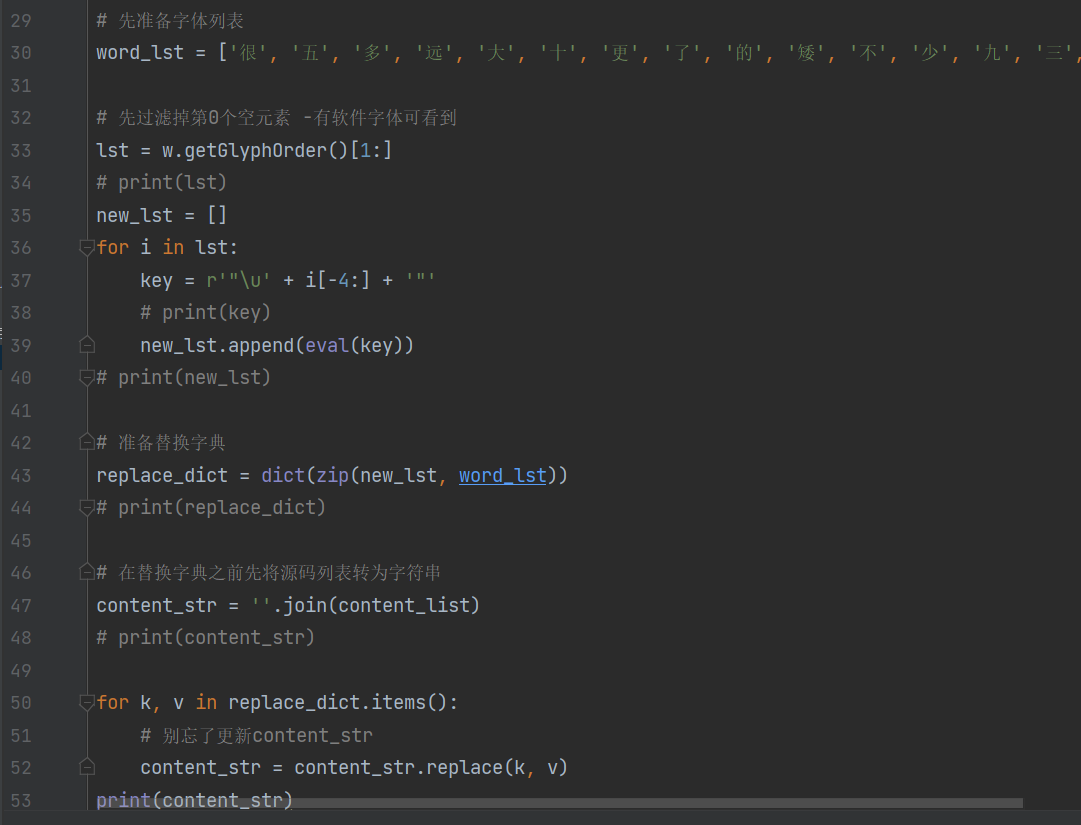
由于爬取数量较多为提高爬取速度选择用scrapy-redis分布式爬取 首先先分析网页,需要从一级页面获取大标题和二级页面的url,从二级页面获取各章节名称和三级页面url,在三级页面获取小说具体各章节的文本呢内容,再编写爬虫程序,运用xpath解析,再保存数据,再setting中设置请求头和redis等设置

案例判断参考
阿白的案例列表
scrapy-redis之盗墓笔记
由于爬取数量较多为提高爬取速度选择用scrapy-redis分布式爬取 首先先分析网页,需要从一级页面获取大标题和二级页面的url,从二级页面获取各章节名称和三级页面url,在三级页面获取小说具体各章节的文本呢内容,再编写爬虫程序,运用xpath解析,再保存数据,再setting中设置请求头和redis等设置...


