nuoya
案例介绍
构成表,统一将最终提取到的信息存库,用来对公司年度状况进行分析,并且提供公司年报数据给有需求的公司。
负责板块:
1.将pdf格式的年报数据进行转化,转化成txt格式的年报数据;
2.从转化好txt格式的年报数据中抽取出公司以及公司的主营业务;
3.从年报中的图表中抽取出公司的盈亏状况,并将所有信息入库。
技术方案:
1.利用OCR模型将pdf格式的年报数据转成txt格式(OCR模型可以高效的解析出pdf文件中的图片与表格);
2.应用BERT+bilstm+crf模型抽取出公司名以及公司的主营业务
3.利用规则从OCR输出的图表中匹配出公司营业收入构成
nuoya

案例介绍
项目概述:从pdf格式的年报中抽取出年报所涉及的公司以及公司的主营业务,从年报中的图表中抽取出公司的营业收入
构成表,统一将最终提取到的信息存库,用来对公司年度状况进行分析,并且提供公司年报数据给有需求的公司。
负责板块:
1.将pdf格式的年报数据进行转化,转化成txt格式的年报数据;
2.从转化好txt格式的年报数据中抽取出公司以及公司的主营业务;
3.从年报中的图表中抽取出公司的盈亏状况,并将所有信息入库。
技术方案:
1.利用OCR模型将pdf格式的年报数据转成txt格式(OCR模型可以高效的解析出pdf文件中的图片与表格);
2.应用BERT+bilstm+crf模型抽取出公司名以及公司的主营业务
3.利用规则从OCR输出的图表中匹配出公司营业收入构成
案例图片

相似案例推荐
-
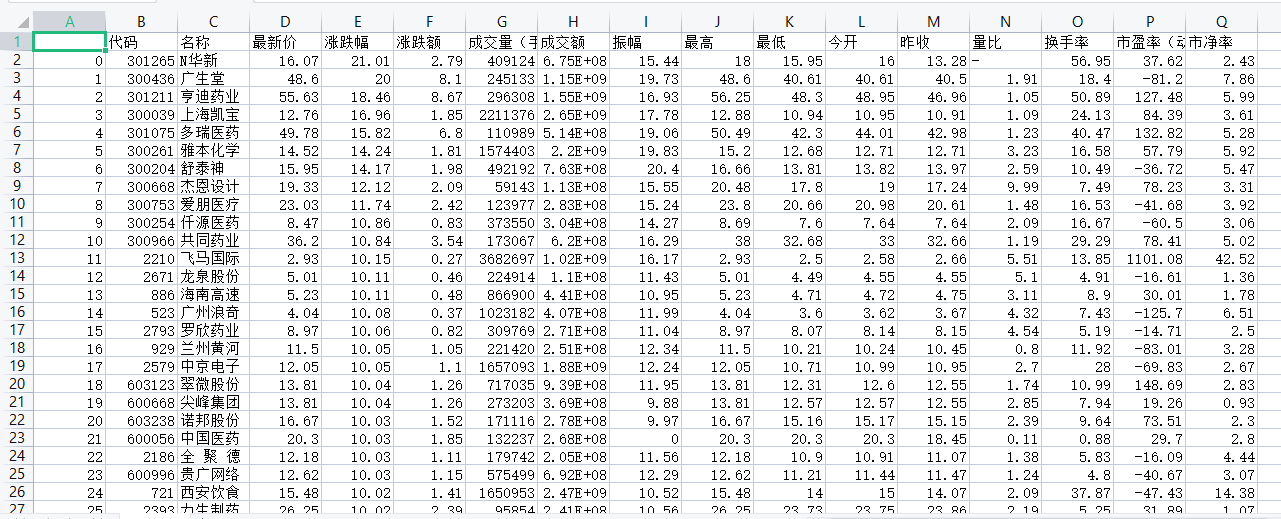
提取所有股票的信息进行数据分析
爬虫:爬取所有股票的相关信息,主要包括:最新价,涨跌幅、涨跌
-
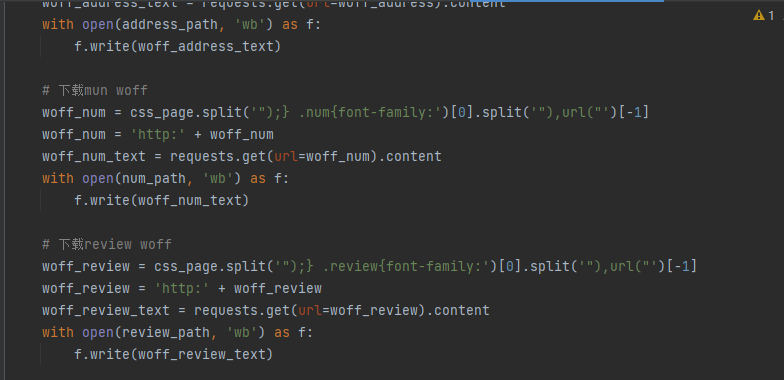
爬取大众点评商铺地址、评分等相关信息
爬虫:爬取大众点评某个城市某类美食的所有商家相关的有市场价值
-
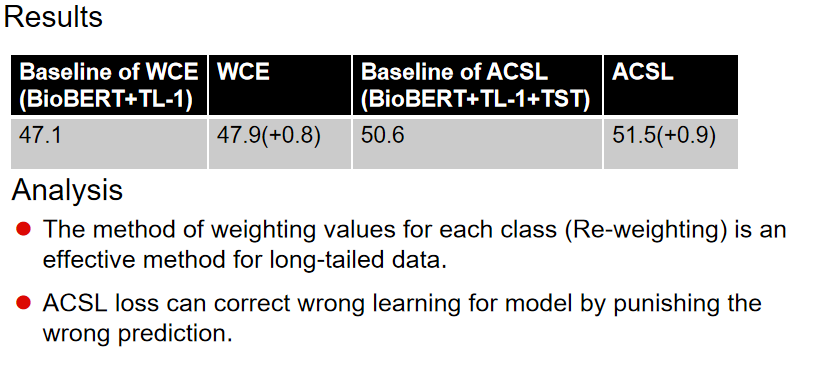
深度学习算法竞赛
NTCIR-16 Real-MedNLP Subtask3
-
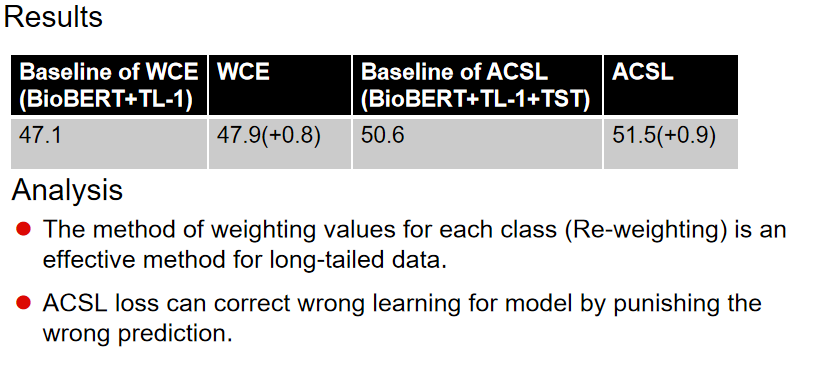
深度学习算法竞赛
NTCIR-16 Real-MedNLP Subtask3
-
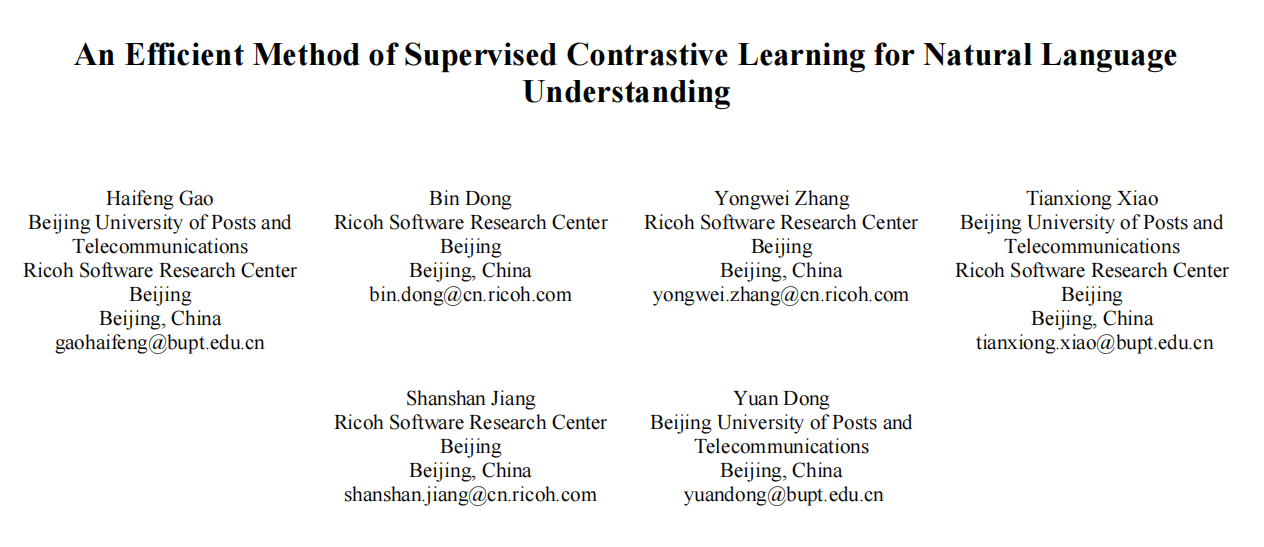
论文
An Efficient Method of Supervi
-
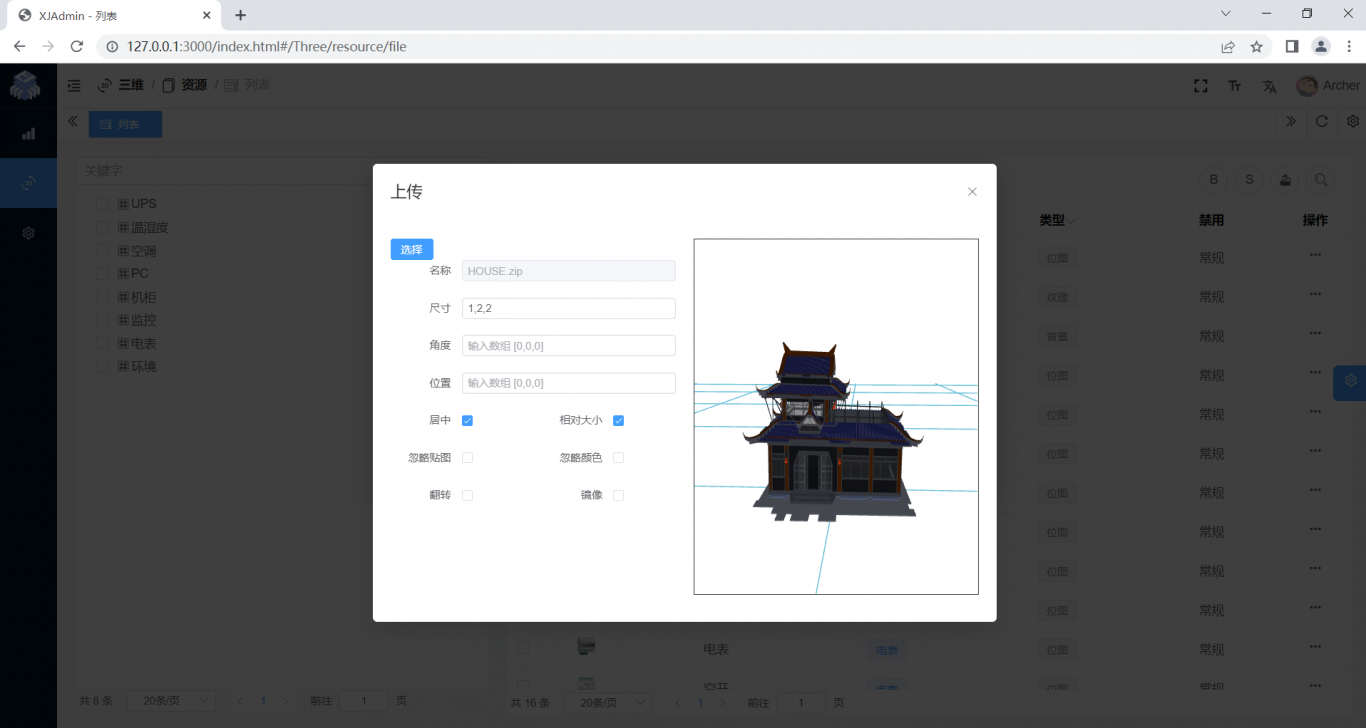
三维可视化
webgl在线预览
1小时精推人才
需求方专属客服,免费梳理匹配

