python轻量化抓取目标站点图片并下载
案例介绍
项目目标
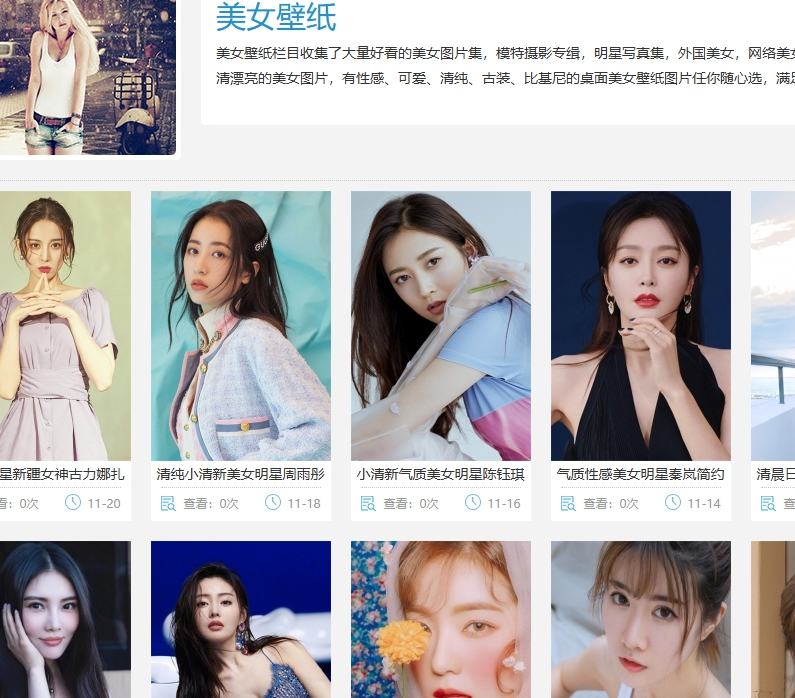
从目标网页抓取图片,并将这些图片保存到本地文件夹。
项目步骤
导入必要的模块:
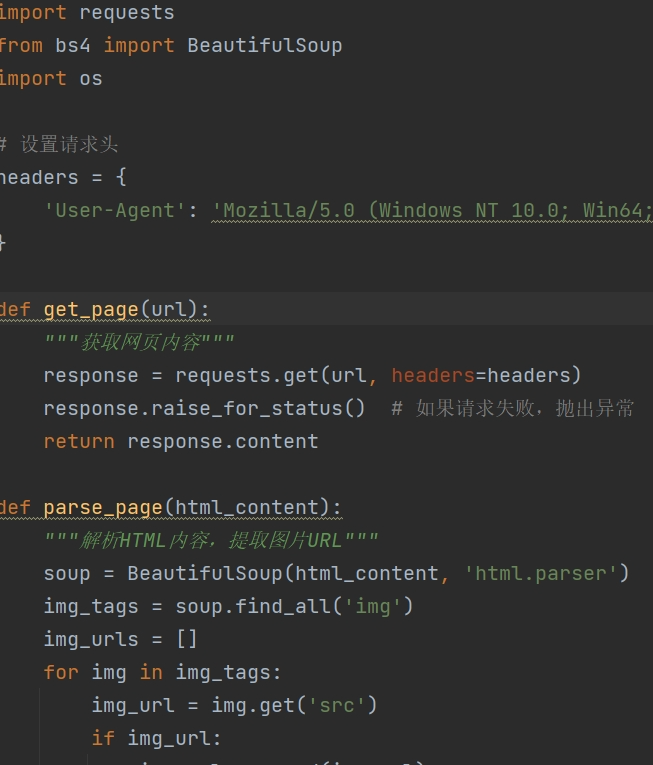
使用 requests 模块发送 HTTP 请求,获取网页内容。
使用 BeautifulSoup 模块解析 HTML,提取图片的 URL。
使用 os 模块创建文件夹和处理文件路径。
设置请求头:
为了避免被网站拒绝访问,设置了 User-Agent 请求头,使请求看起来像是来自普通的浏览器。
获取网页内容:
通过 requests.get 获取网页内容,并检查请求是否成功。
解析 HTML 内容:
使用 BeautifulSoup 解析 HTML 内容,并找到所有的 <img> 标签。
提取图片的 URL,并处理相对路径。
下载并保存图片:
对每个图片 URL 发送请求,获取图片内容。
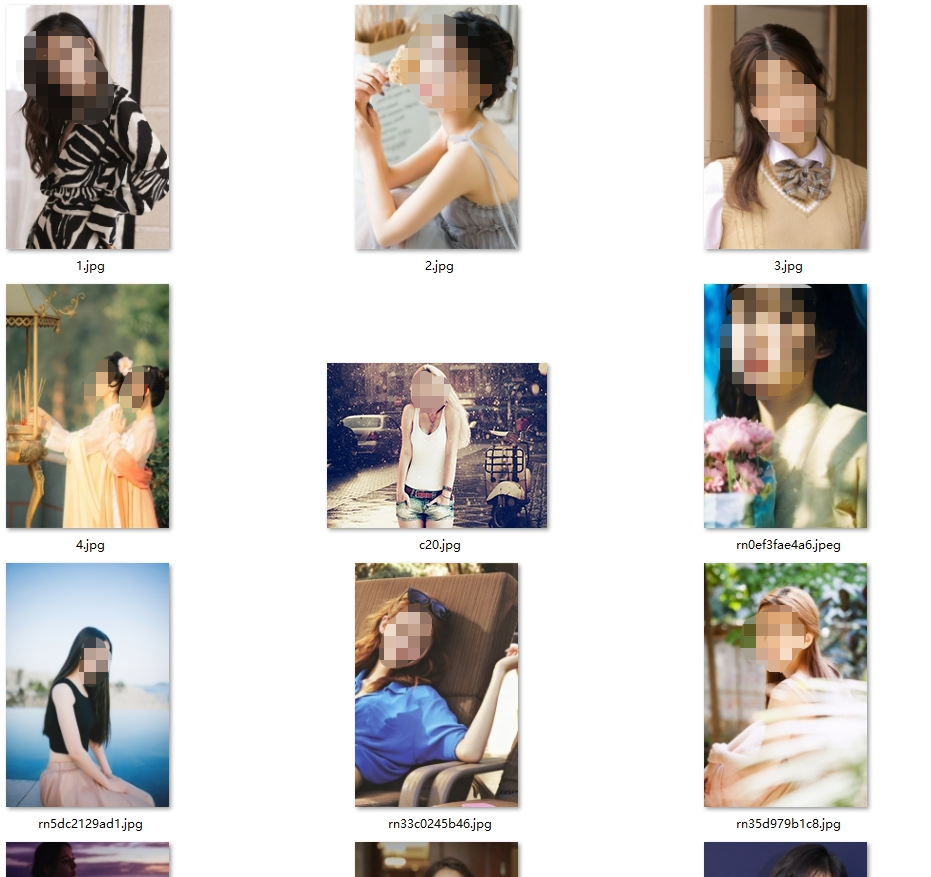
将图片内容保存到本地文件夹。
模块化代码:
将各个功能模块化,分别实现 get_page、parse_page 和 save_image 函数。
使用 main 函数串联各个步骤,并确保主程序在脚本执行时运行。
在本地算力可行的情况下,还可以用多线程来实现,快速抓取
python轻量化抓取目标站点图片并下载

案例介绍
在本项目是一个轻量化网络爬虫,利用 Python 的 requests 和 BeautifulSoup 模块,从指定的目标网站抓取图片并将其保存到本地。
项目目标
从目标网页抓取图片,并将这些图片保存到本地文件夹。
项目步骤
导入必要的模块:
使用 requests 模块发送 HTTP 请求,获取网页内容。
使用 BeautifulSoup 模块解析 HTML,提取图片的 URL。
使用 os 模块创建文件夹和处理文件路径。
设置请求头:
为了避免被网站拒绝访问,设置了 User-Agent 请求头,使请求看起来像是来自普通的浏览器。
获取网页内容:
通过 requests.get 获取网页内容,并检查请求是否成功。
解析 HTML 内容:
使用 BeautifulSoup 解析 HTML 内容,并找到所有的 <img> 标签。
提取图片的 URL,并处理相对路径。
下载并保存图片:
对每个图片 URL 发送请求,获取图片内容。
将图片内容保存到本地文件夹。
模块化代码:
将各个功能模块化,分别实现 get_page、parse_page 和 save_image 函数。
使用 main 函数串联各个步骤,并确保主程序在脚本执行时运行。
在本地算力可行的情况下,还可以用多线程来实现,快速抓取
案例图片
相似案例推荐
-

EPG电子节目指南
EPG是Electronic Program Guide的英
-

魔法表情
快手的魔法表情3D团队,支持各种3D魔法表情的玩法,渲染,优
-

某手直播回放视频导出工具
某手直播平台的直播回放视频只能看不能下载,通过协议分析,写了
-

视频生成软件
程序的功能是生成视频文件。根据excel配置文件,读取相关的
-

剧汇TV
剧汇TV(又名K365)是一个类似于爱奇艺、优酷、腾讯视频的
-

a站电影网视频pa虫
使用requests,json,BeautifulSoup,
1小时精推人才
需求方专属客服,免费梳理匹配

