高效数据爬取 小说数据爬取
案例介绍
高效数据爬取 小说数据爬取

案例介绍
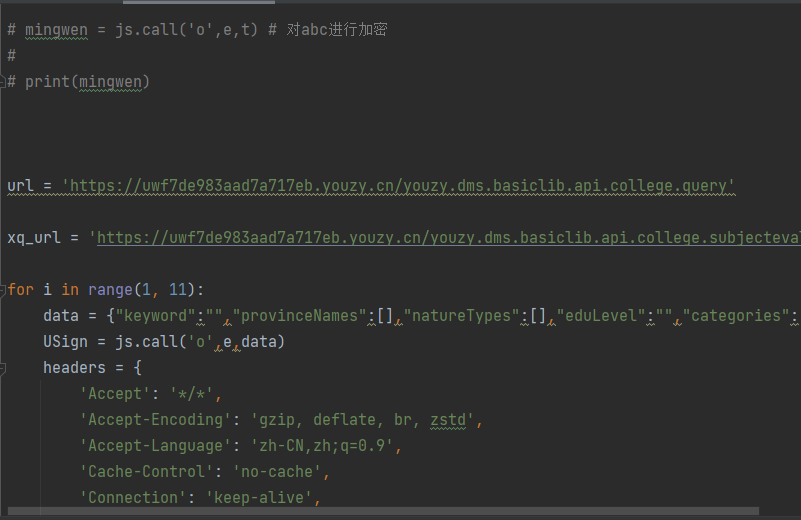
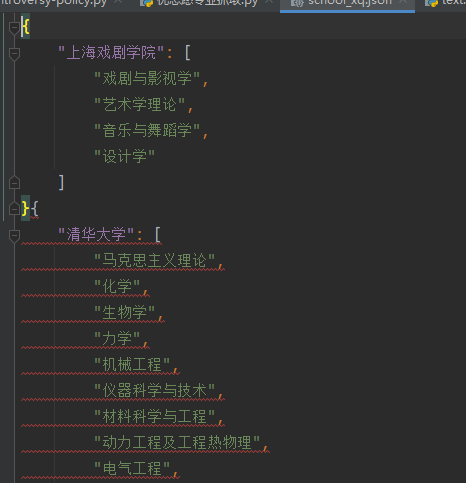
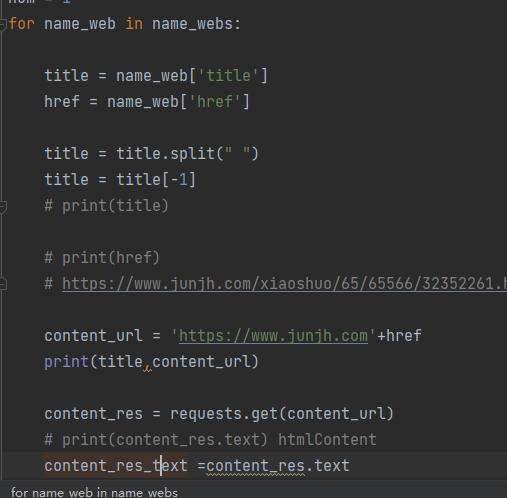
在优志愿网站上,我使用Python编程语言和爬虫技术成功抓取了学校的数据。通过分析网站的结构和URL规律,我能够自动化地访问各个学校的页面并提取相关信息。这些信息包括学校的基本信息、专业设置、录取要求、校园设施等。为了实现这个目标,我使用了requests库来发送HTTP请求,BeautifulSoup库来解析HTML内容,以及pandas库来处理和存储数据。首先,我编写了一个函数来获取每个学校的URL列表,然后遍历这些URL,发送请求并解析响应内容。通过定位到包含所需信息的HTML元素,我提取了学校的名称、地址、联系方式、专业设置等信息,并将它们保存到一个CSV文件中。这个项目不仅提高了我的编程技能,还让我了解了如何利用网络资源来获取实时的学校信息。这对于学生和家长来说非常有用,他们可以通过比较不同学校的特点和录取要求来做出更好的决策。此外,我还对抓取到的数据进行了清洗和整理,以确保其准确性和一致性,以便后续进行数据分析和可视化展示。
案例图片
相似案例推荐
-

北科大区块链溯源管理系统
建立了可覆盖全流程、全行业、全参数的完整的全固废材料数据库,
-

校园官网
主要为学校发布学校新闻、教师资质、优秀学生榜、招生、招聘信息
-

学浪教师端 APP
1、参与学浪老师端教室内、教室外的开发,跟进功能迭代,保证项
-

学浪老师端
1、参与学浪老师端教室内、教室外的开发,跟进功能迭代,保证项
-

智学谷(Zhixue Valley)
智学谷数智化教学平台 项目背景: 智学谷(Zhixue
-

智学谷(Zhixue Valley)
智学谷数智化教学平台 项目背景: 智学谷(Zhixue
1小时精推人才
需求方专属客服,免费梳理匹配

