唯丽是图
无
无 · 3年经验
日薪:
¥500/8h
地点:
其他 全区
时间:
下班后周六周日可工作日远程
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
作为一名拥有Python编程技能、数据分析知识以及前端开发基础的专业人士,我在处理复杂问题和实现高效解决方案方面具有显著的优势。根据IEEE计算机协会的研究,Python已经成为最受欢迎的编程语言之一,其强大的库支持和简洁的语法使得数据操作和分析变得轻松而高效。在数据分析领域,我能够运用NumPy、Pandas等工具进行数据清洗、转换和可视化,从而为决策提供科学依据。同时,我的前端基础知识让我能够使用HTML、CSS和JavaScript等技术创建直观、用户友好的界面,提升用户体验。这些技能的综合运用使我能够在多个领域发挥重要作用,为团队带来实质性的贡献。
项目经验
在数据项目中,我成功爬取了肯德基餐厅的数据。通过使用Python编程语言和BeautifulSoup库,我能够从肯德基的官方网站上抓取餐厅的位置、菜单、价格等信息。这些数据可以帮助我分析肯德基在不同地区的分布情况、热门菜品以及价格策略等。此外,我还对爬取到的数据进行了清洗和整理,以便后续进行数据分析和可视化展示。另一个数据项目是关于小说数据的爬取。我使用了Python的requests库和正则表达式来提取小说网站的内容。这个项目的目标是获取一本畅销小说的所有章节内容,并保存为本地文件。通过对小说内容的分析和挖掘,我可以了解小说的主题、人物关系以及情节发展等方面的特点。这些信息对于文学爱好者和研究者来说非常有价值。这两个数据项目的完成不仅提高了我的编程技能,还锻炼了我的数据处理和分析能力。同时,它们也为我提供了深入了解不同行业和领域的机会,使我能够更好地理解市场需求和消费者行为。


唯丽是图
无 · 3年经验 · 无
0
累计接单
0
用户评价
0
被收藏
信用行为
0
接单数
0
评价数
0
收藏数
技术能力
作为一名拥有Python编程技能、数据分析知识以及前端开发基础的专业人士,我在处理复杂问题和实现高效解决方案方面具有显著的优势。根据IEEE计算机协会的研究,Python已经成为最受欢迎的编程语言之一,其强大的库支持和简洁的语法使得数据操作和分析变得轻松而高效。在数据分析领域,我能够运用NumPy、Pandas等工具进行数据清洗、转换和可视化,从而为决策提供科学依据。同时,我的前端基础知识让我能够使用HTML、CSS和JavaScript等技术创建直观、用户友好的界面,提升用户体验。这些技能的综合运用使我能够在多个领域发挥重要作用,为团队带来实质性的贡献。
项目经验
在数据项目中,我成功爬取了肯德基餐厅的数据。通过使用Python编程语言和BeautifulSoup库,我能够从肯德基的官方网站上抓取餐厅的位置、菜单、价格等信息。这些数据可以帮助我分析肯德基在不同地区的分布情况、热门菜品以及价格策略等。此外,我还对爬取到的数据进行了清洗和整理,以便后续进行数据分析和可视化展示。另一个数据项目是关于小说数据的爬取。我使用了Python的requests库和正则表达式来提取小说网站的内容。这个项目的目标是获取一本畅销小说的所有章节内容,并保存为本地文件。通过对小说内容的分析和挖掘,我可以了解小说的主题、人物关系以及情节发展等方面的特点。这些信息对于文学爱好者和研究者来说非常有价值。这两个数据项目的完成不仅提高了我的编程技能,还锻炼了我的数据处理和分析能力。同时,它们也为我提供了深入了解不同行业和领域的机会,使我能够更好地理解市场需求和消费者行为。
案例展示
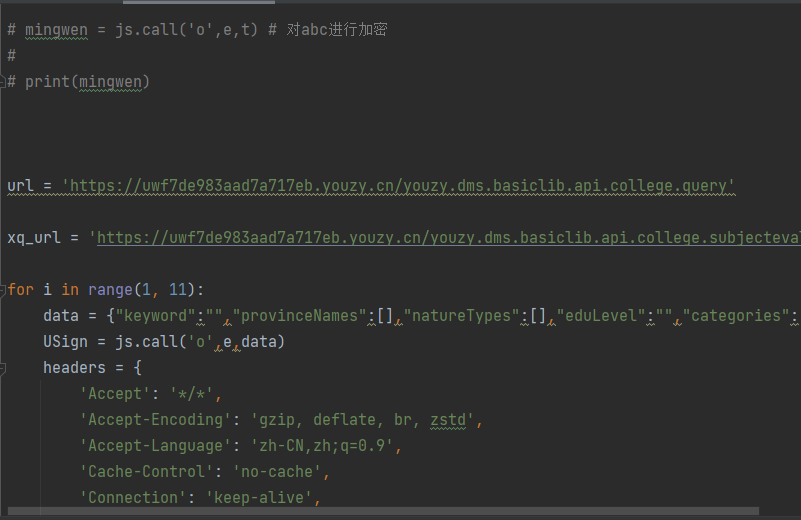
高效数据爬取 小说数据爬取
在优志愿网站上,我使用Python编程语言和爬虫技术成功抓取了学校的数据。通过分析网站的结构和URL规律,我能够自动化地访问各个学校的页面并提取相关信息。这些信息包括学校的基本信息、专业设置、录取要求、校园设施等。为了实现这个目标,我使用了requests库来发送HTTP请求,B
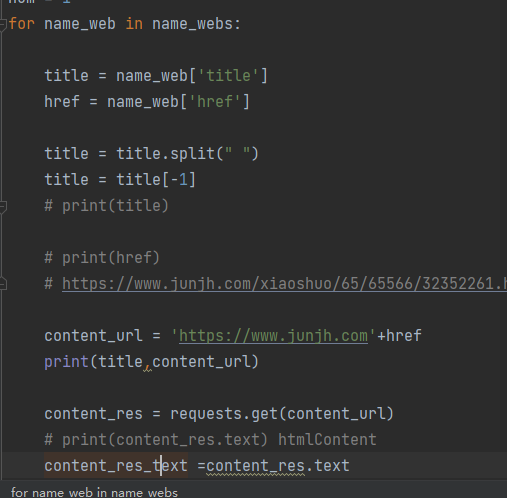
高效数据爬取 小说数据爬取
小说数据爬取通常涉及以下步骤:1. 确定目标网站:首先,你需要找到一个提供小说下载或阅读的网站。确保该网站允许你进行爬取操作,并且遵守其robots.txt文件的规定。 2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HT

 立即沟通


