唯丽是图的案例列表
高效数据爬取 小说数据爬取
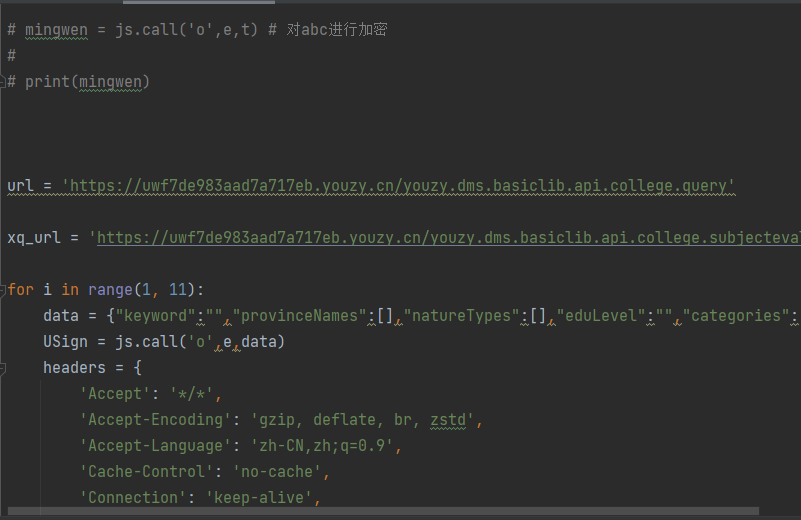
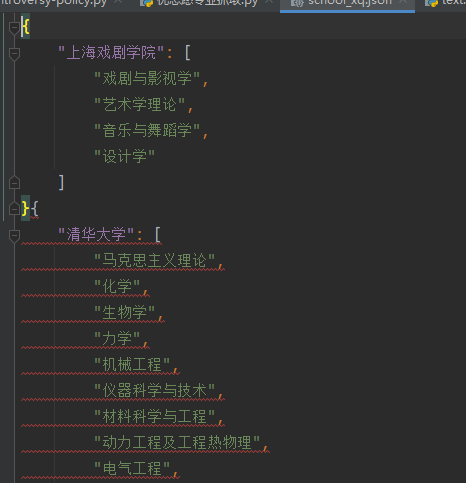
在优志愿网站上,我使用Python编程语言和爬虫技术成功抓取了学校的数据。通过分析网站的结构和URL规律,我能够自动化地访问各个学校的页面并提取相关信息。这些信息包括学校的基本信息、专业设置、录取要求、校园设施等。为了实现这个目标,我使用了requests库来发送HTTP请求,BeautifulSoup库来解析HTML内容,以及pandas库来处理和存储数据。首先,我编写了一个函数来获取每个学校的URL列表,然后遍历这些URL,发送请求并解析响应内容。通过定位到包含所需信息的HTML元素,我提取了学校的名称、地址、联系方式、专业设置等信息,并将它们保存到一个CSV文件中。这个项目不仅提高了我的
高效数据爬取 小说数据爬取
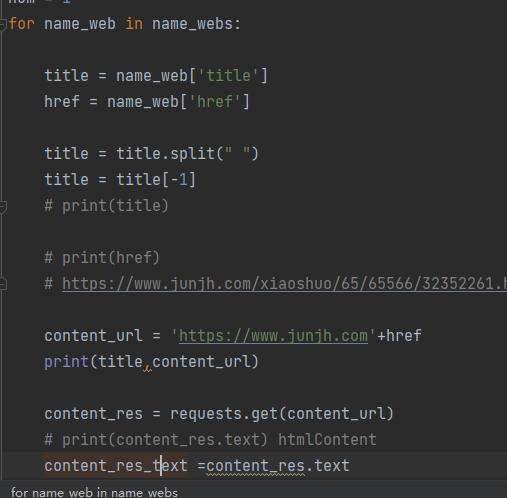
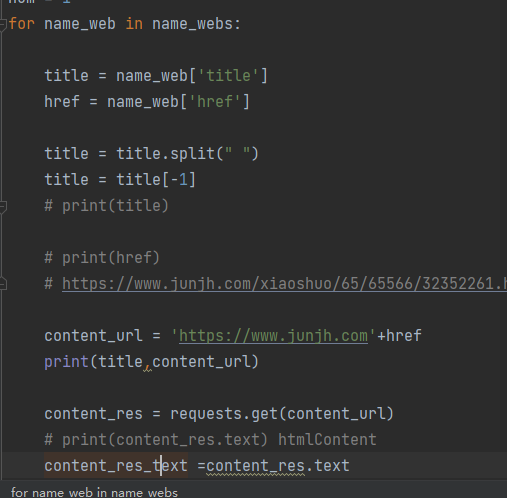
小说数据爬取通常涉及以下步骤:1. 确定目标网站:首先,你需要找到一个提供小说下载或阅读的网站。确保该网站允许你进行爬取操作,并且遵守其robots.txt文件的规定。 2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HTML标签和属性。这将帮助你定位到小说文本的位置。3. 编写爬虫代码:根据网页结构,你可以使用Python的requests库来获取网页内容,然后使用BeautifulSoup库来解析HTML并提取小说文本。
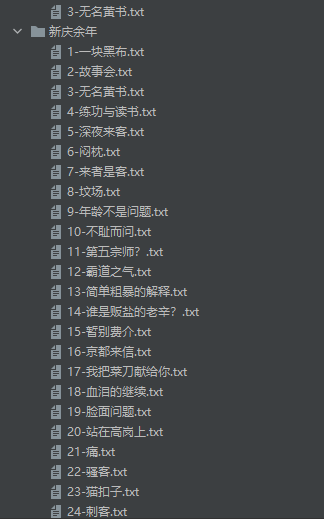
案例判断参考
唯丽是图的案例列表
高效数据爬取 小说数据爬取
在优志愿网站上,我使用Python编程语言和爬虫技术成功抓取了学校的数据。通过分析网站的结构和URL规律,我能够自动化地访问各个学校的页面并提取相关信息。这些信息包括学校的基本信息、专业设置、录取要求、校园设施等。为了实现这个目标,我使用了requests库来发送HTTP请求,BeautifulSoup库来解析HTML内容,以及pandas库来处理和存储数据。首先,我编写了一个函数来获取每个学校的URL列表,然后遍历这些URL,发送请求并解析响应内容。通过定位到包含所需信息的HTML元素,我提取了学校的名称、地址、联系方式、专业设置等信息,并将它们保存到一个CSV文件中。这个项目不仅提高了我的...
高效数据爬取 小说数据爬取
小说数据爬取通常涉及以下步骤:1. 确定目标网站:首先,你需要找到一个提供小说下载或阅读的网站。确保该网站允许你进行爬取操作,并且遵守其robots.txt文件的规定。 2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HTML标签和属性。这将帮助你定位到小说文本的位置。3. 编写爬虫代码:根据网页结构,你可以使用Python的requests库来获取网页内容,然后使用BeautifulSoup库来解析HTML并提取小说文本。...


