高效数据爬取 小说数据爬取
微信扫码沟通,客服可协助直接对接工程师;如当前档期不合,也可继续推荐相似案例作者。
案例介绍
小说数据爬取通常涉及以下步骤:1. 确定目标网站:首先,你需要找到一个提供小说下载或阅读的网站。确保该网站允许你进行爬取操作,并且遵守其robots.txt文件的规定。
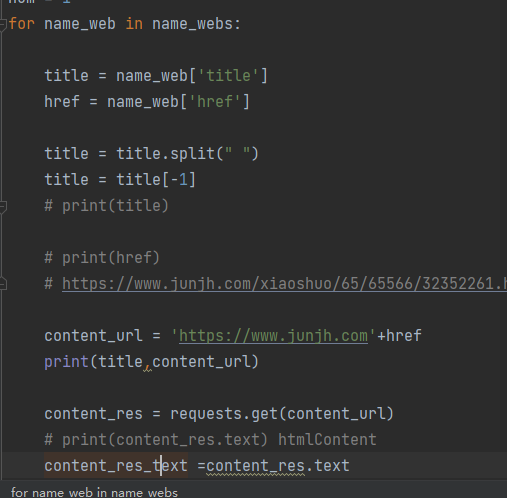
2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HTML标签和属性。这将帮助你定位到小说文本的位置。3. 编写爬虫代码:根据网页结构,你可以使用Python的requests库来获取网页内容,然后使用BeautifulSoup库来解析HTML并提取小说文本。
2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HTML标签和属性。这将帮助你定位到小说文本的位置。3. 编写爬虫代码:根据网页结构,你可以使用Python的requests库来获取网页内容,然后使用BeautifulSoup库来解析HTML并提取小说文本。
高效数据爬取 小说数据爬取
联系该工程师

微信扫码,建群沟通
案例介绍
小说数据爬取通常涉及以下步骤:1. 确定目标网站:首先,你需要找到一个提供小说下载或阅读的网站。确保该网站允许你进行爬取操作,并且遵守其robots.txt文件的规定。
2. 分析网页结构:使用浏览器的开发者工具(如Chrome的开发者工具)来查看网页源代码,找到小说内容的HTML标签和属性。这将帮助你定位到小说文本的位置。3. 编写爬虫代码:根据网页结构,你可以使用Python的requests库来获取网页内容,然后使用BeautifulSoup库来解析HTML并提取小说文本。
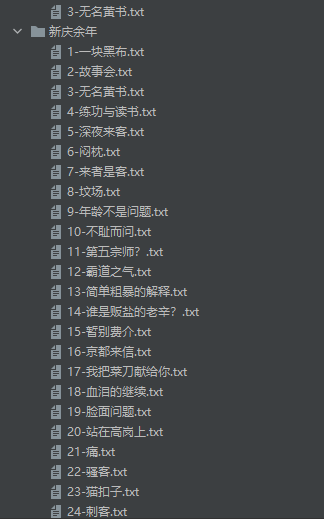
案例图片
相似案例推荐
-

北科大区块链溯源管理系统
建立了可覆盖全流程、全行业、全参数的完整的全固废材料数据库,
-

校园官网
主要为学校发布学校新闻、教师资质、优秀学生榜、招生、招聘信息
-

学浪教师端 APP
1、参与学浪老师端教室内、教室外的开发,跟进功能迭代,保证项
-

学浪老师端
1、参与学浪老师端教室内、教室外的开发,跟进功能迭代,保证项
-

智学谷(Zhixue Valley)
智学谷数智化教学平台 项目背景: 智学谷(Zhixue
-

智学谷(Zhixue Valley)
智学谷数智化教学平台 项目背景: 智学谷(Zhixue
1小时精推人才
需求方专属客服,免费梳理匹配

扫码加微信 · 客服人工对接
