虚假新闻挑战赛top分享
案例介绍
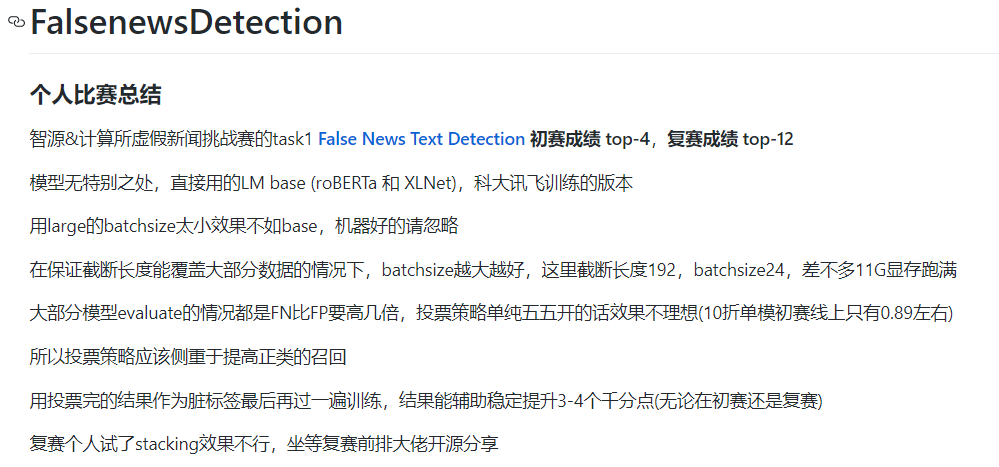
模型无特别之处,直接用的LM base (roBERTa 和 XLNet),科大讯飞训练的版本
用large的batchsize太小效果不如base,机器好的请忽略
在保证截断长度能覆盖大部分数据的情况下,batchsize越大越好,这里截断长度192,batchsize24,差不多11G显存跑满
大部分模型evaluate的情况都是FN比FP要高几倍,投票策略单纯五五开的话效果不理想(10折单模初赛线上只有0.89左右)
所以投票策略应该侧重于提高正类的召回
用投票完的结果作为脏标签最后再过一遍训练,结果能辅助稳定提升3-4个千分点(无论在初赛还是复赛)
虚假新闻挑战赛top分享

案例介绍
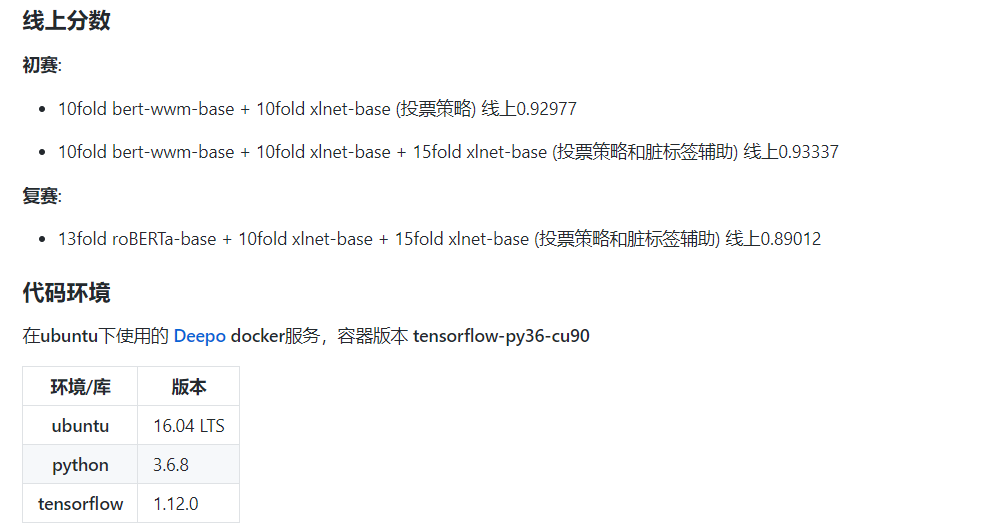
智源&计算所虚假新闻挑战赛的task1 False News Text Detection 初赛成绩 top-4,复赛成绩 top-12
模型无特别之处,直接用的LM base (roBERTa 和 XLNet),科大讯飞训练的版本
用large的batchsize太小效果不如base,机器好的请忽略
在保证截断长度能覆盖大部分数据的情况下,batchsize越大越好,这里截断长度192,batchsize24,差不多11G显存跑满
大部分模型evaluate的情况都是FN比FP要高几倍,投票策略单纯五五开的话效果不理想(10折单模初赛线上只有0.89左右)
所以投票策略应该侧重于提高正类的召回
用投票完的结果作为脏标签最后再过一遍训练,结果能辅助稳定提升3-4个千分点(无论在初赛还是复赛)
案例图片
相似案例推荐
-
聚类
对于上百万篇新闻或者文章,实现快速精准的把描述同一事件的新闻
-
自然语言处理
负责对文章的快速精确分类聚合以及分词、关键词提取、词属性、词
-
socks5协议代理
实现基于socks5协议的代理,包括客户端,服务端。 基于
-
socks5协议代理
实现基于socks5协议的代理,包括客户端,服务端。 基于
-
12306自动购票
通过配置可自动登录, 神经网络tensorflow自动过验
-

蒙草生态产业大数据平台
该产品可查看内蒙古草原生态现状以及蒙草公司针对草原生态所采取
1小时精推人才
需求方专属客服,免费梳理匹配

