Adrian的案例列表
爬虫监控分布式系统
本项目在 Celery 分布式爬虫的基础上构建监控方案 Demo,在编写 Statsd + InfluxDB 方案代码进行调研过程中,转向了 Prometheus 的怀抱 ,使用 Grafana 对监控序列进行可视化,爬虫部分完成对下载和解析进行简单解耦


NLP自然语言处理论文复现
使用tensorflow复现抽取式摘要论文 熟悉NLP深度学习的各个任务下的主流模型 熟悉深度学习框架的使用 包括keras,pytorch,tensorflow 和常见的自然语言处理包 包括gensim,sklearn等 和常见数据分析包 包括pandas,numpy等 主要技能:关键词挖掘,文本分类,命名实体识别,文本摘要,语义等价问题


虚假新闻挑战赛top分享
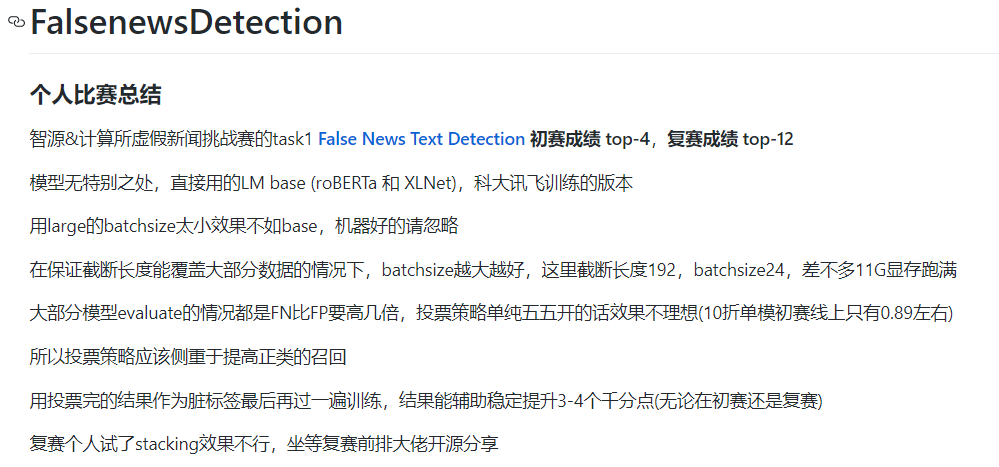
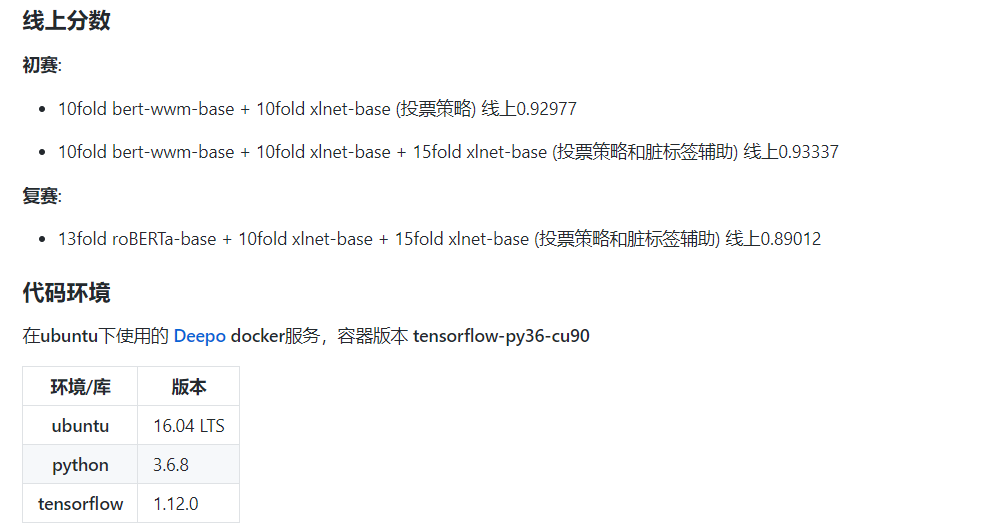
智源&计算所虚假新闻挑战赛的task1 False News Text Detection 初赛成绩 top-4,复赛成绩 top-12 模型无特别之处,直接用的LM base (roBERTa 和 XLNet),科大讯飞训练的版本 用large的batchsize太小效果不如base,机器好的请忽略 在保证截断长度能覆盖大部分数据的情况下,batchsize越大越好,这里截断长度192,batchsize24,差不多11G显存跑满 大部分模型evaluate的情况都是FN比FP要高几倍,投票策略单纯五五开的话效果不理想(10折单模初赛线上只有0.89左右)
案例判断参考
Adrian的案例列表
爬虫监控分布式系统
本项目在 Celery 分布式爬虫的基础上构建监控方案 Demo,在编写 Statsd + InfluxDB 方案代码进行调研过程中,转向了 Prometheus 的怀抱 ,使用 Grafana 对监控序列进行可视化,爬虫部分完成对下载和解析进行简单解耦 ...
NLP自然语言处理论文复现
使用tensorflow复现抽取式摘要论文 熟悉NLP深度学习的各个任务下的主流模型 熟悉深度学习框架的使用 包括keras,pytorch,tensorflow 和常见的自然语言处理包 包括gensim,sklearn等 和常见数据分析包 包括pandas,numpy等 主要技能:关键词挖掘,文本分类,命名实体识别,文本摘要,语义等价问题 ...
虚假新闻挑战赛top分享
智源&计算所虚假新闻挑战赛的task1 False News Text Detection 初赛成绩 top-4,复赛成绩 top-12 模型无特别之处,直接用的LM base (roBERTa 和 XLNet),科大讯飞训练的版本 用large的batchsize太小效果不如base,机器好的请忽略 在保证截断长度能覆盖大部分数据的情况下,batchsize越大越好,这里截断长度192,batchsize24,差不多11G显存跑满 大部分模型evaluate的情况都是FN比FP要高几倍,投票策略单纯五五开的话效果不理想(10折单模初赛线上只有0.89左右) ...


