数据仓库架构
案例介绍
数据源抽取:实现:基于库表及日志两类数据源进行数据ETL
工具:hdfs集成使用sqoop\databus\hdfsload\flume
kafka集成使用exp\flume
hbase集成使用自研工具
数据交换:实现:跨存储数据交换
交换场景:主要为kafka数据备份离线,实时维表集成hbase\clickhouse,实时明细集成hbase\clickhouse
kafka→hdfs\kafka→hbase\hbase→kafka\kafka→clickhouse
hdfs→clickhouse
ETL:实现:一套模型设计在离线&实时场景分别进行数据落地
ETL场景:使用hiveSQL离线流处理
使用flinkSQL实时线流处理
使用大型数据库如tidb\clickhouse\hbase,进行实时流&离线流数据合并及逻辑加工
工具:ELT工具flinkSQL\hiveSQL\跨存储数据交换工具
存储:hdfs\hbase\kafka\clickhouse\tidb
查询:实现:为产品端提供查询服务
场景:即时查询、实时查询、多维聚合查询
工具:即时查询:hive\spark直接查询
实时查询:mysql\hbase\clickhouse\presto
多维聚合查询: kylin\druid\doris\clickhouse
展现:实现:多产品可视化查询
工具:明细API、指标API、直联hive
数据仓库架构

案例介绍
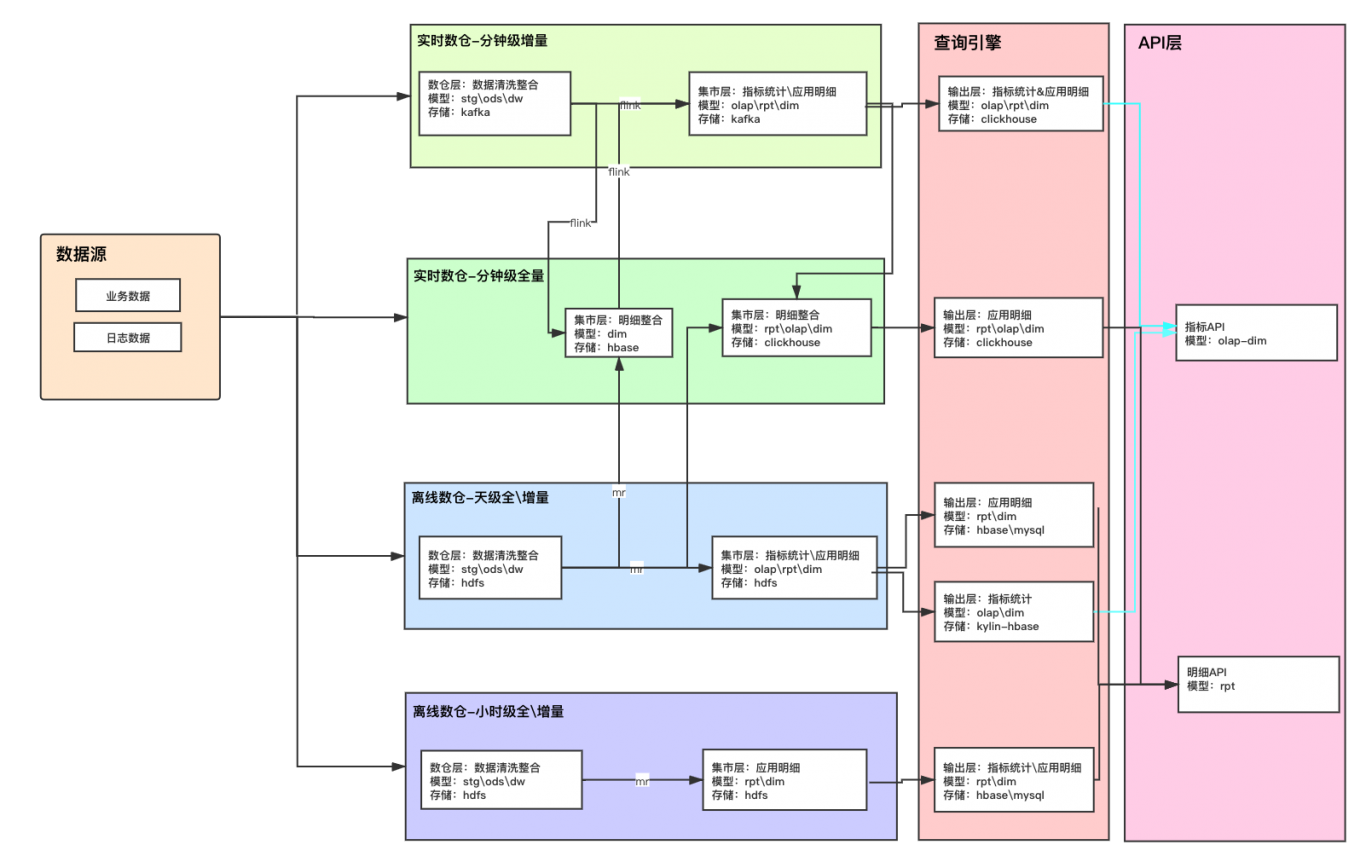
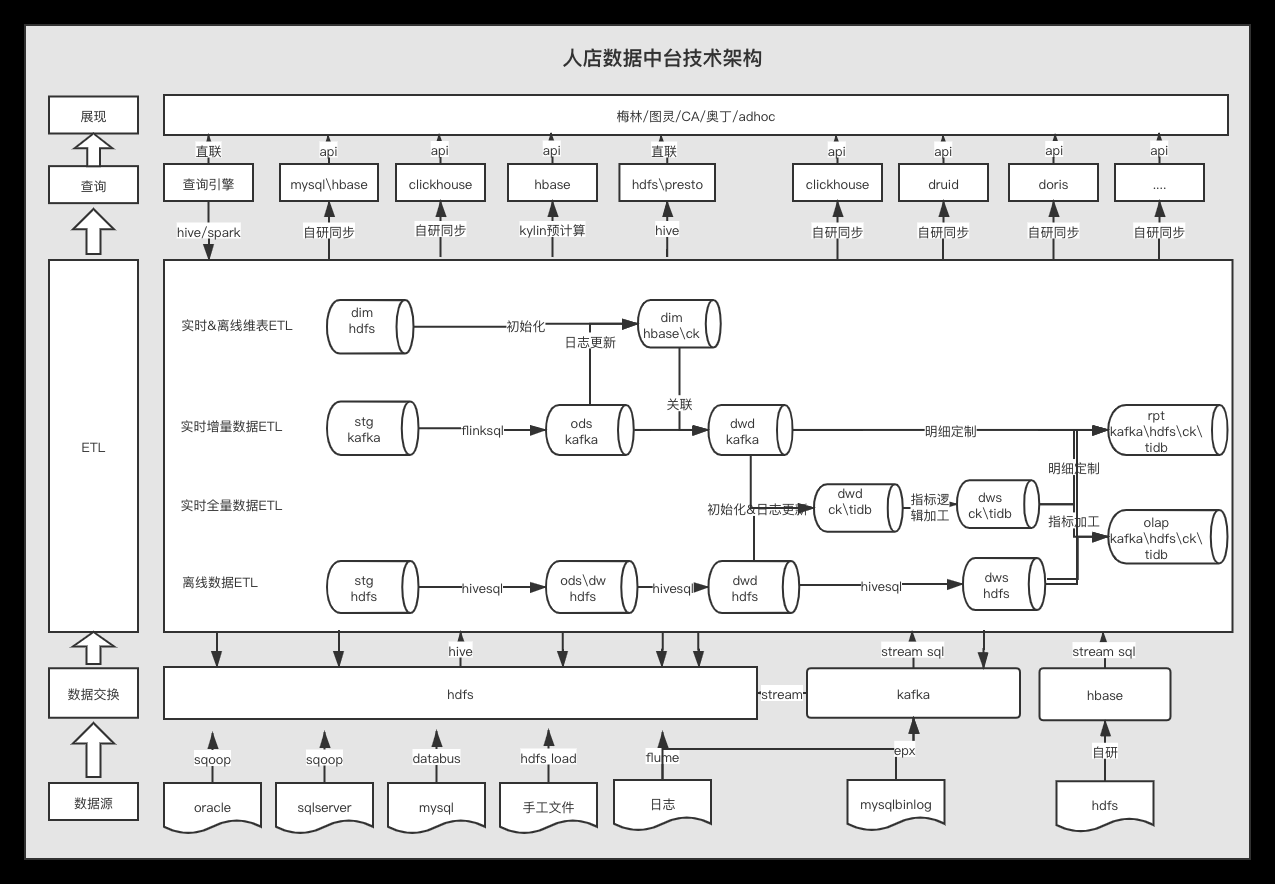
整个技术架构围绕数据源抽取、数据交换、ETL逻辑加工、数据查询、产品端展示展开。
数据源抽取:实现:基于库表及日志两类数据源进行数据ETL
工具:hdfs集成使用sqoop\databus\hdfsload\flume
kafka集成使用exp\flume
hbase集成使用自研工具
数据交换:实现:跨存储数据交换
交换场景:主要为kafka数据备份离线,实时维表集成hbase\clickhouse,实时明细集成hbase\clickhouse
kafka→hdfs\kafka→hbase\hbase→kafka\kafka→clickhouse
hdfs→clickhouse
ETL:实现:一套模型设计在离线&实时场景分别进行数据落地
ETL场景:使用hiveSQL离线流处理
使用flinkSQL实时线流处理
使用大型数据库如tidb\clickhouse\hbase,进行实时流&离线流数据合并及逻辑加工
工具:ELT工具flinkSQL\hiveSQL\跨存储数据交换工具
存储:hdfs\hbase\kafka\clickhouse\tidb
查询:实现:为产品端提供查询服务
场景:即时查询、实时查询、多维聚合查询
工具:即时查询:hive\spark直接查询
实时查询:mysql\hbase\clickhouse\presto
多维聚合查询: kylin\druid\doris\clickhouse
展现:实现:多产品可视化查询
工具:明细API、指标API、直联hive
案例图片
相似案例推荐
-
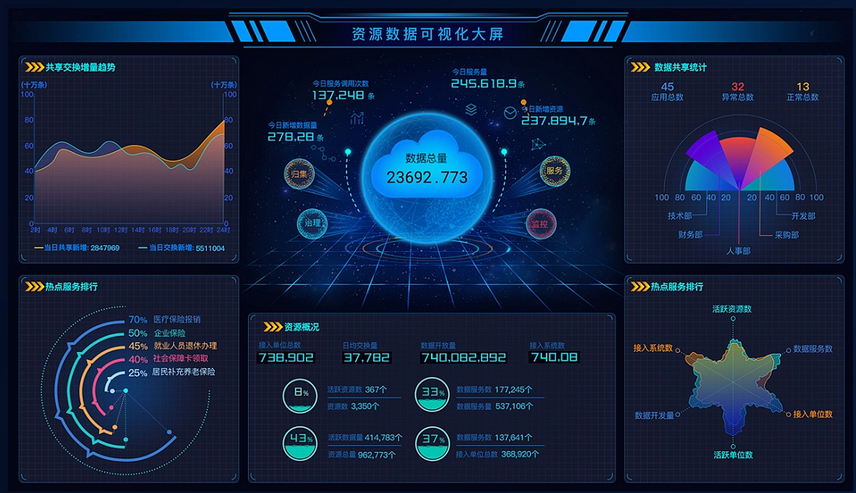
xxx大数据平台
1、负责首页导航中心界面的效果实现,及交互优化; 2、个人
-
皓辰仪联网
责任描述: 1、实现后台客户管理、供应商管理。 2、实
-
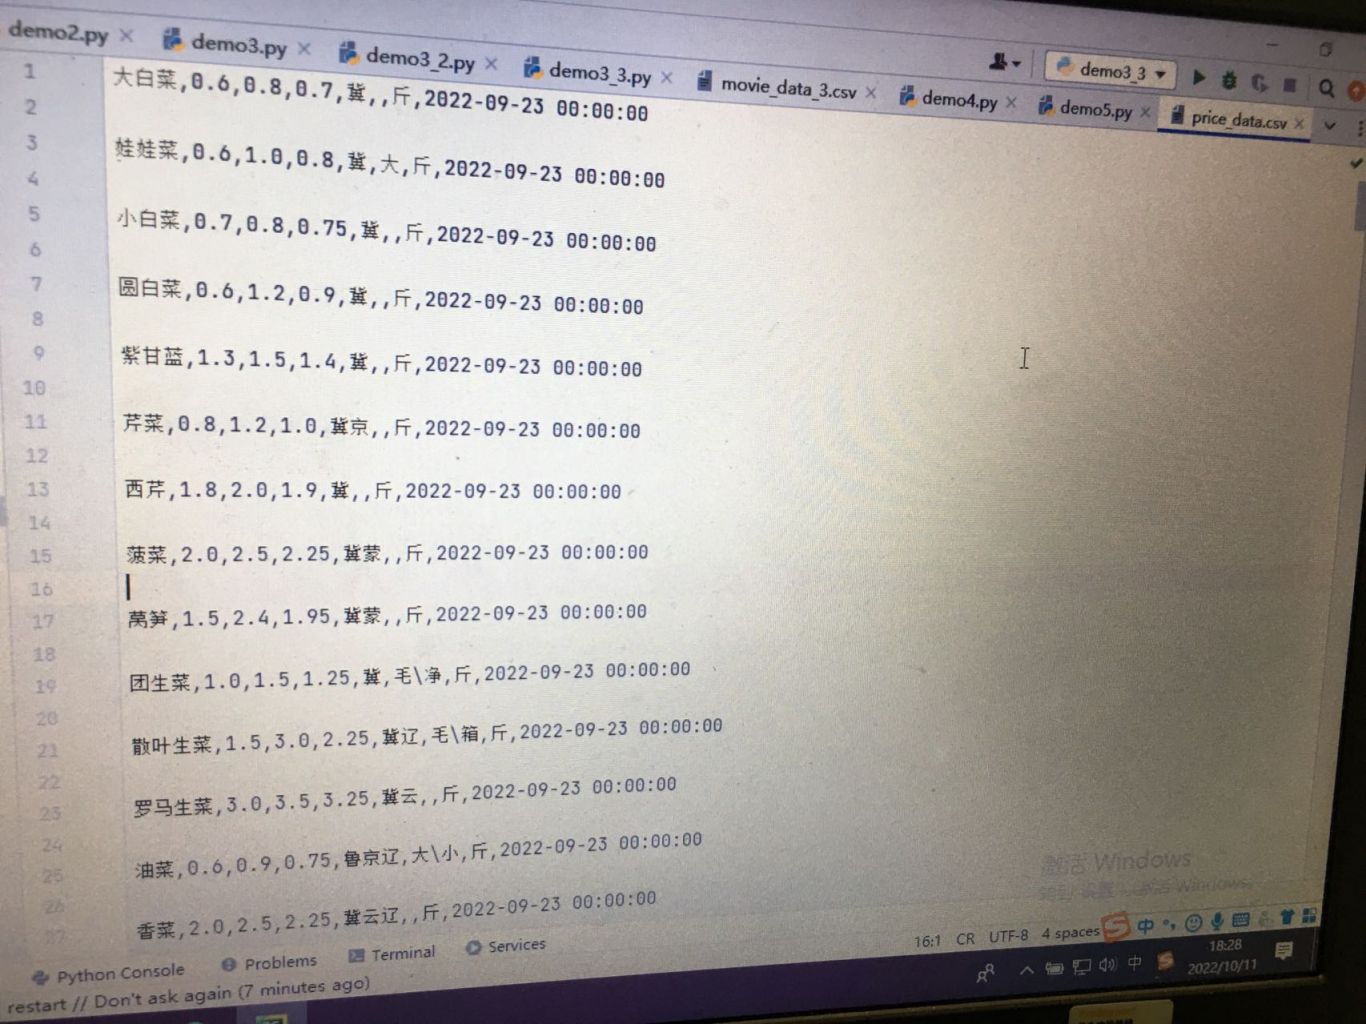
爬取北京新发地菜价数据
此项目是针对北京新发地网站上的不同蔬菜品种菜价做的爬虫项目,
-
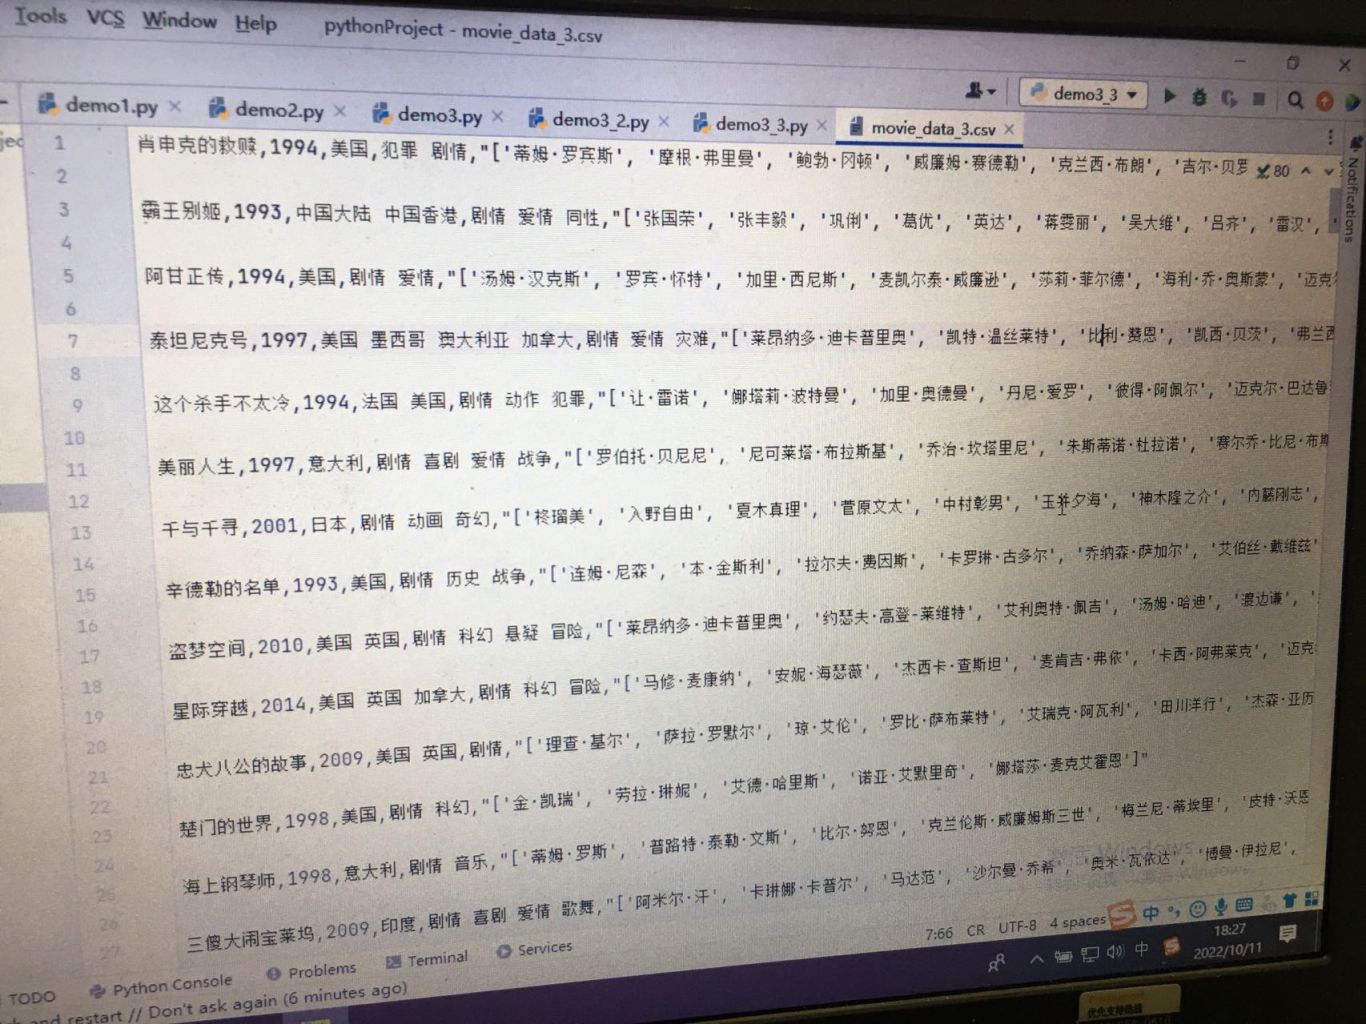
爬取豆瓣TOP250电影数据
此项目是针对豆瓣网站,对TOP250电影排行做的数据爬虫项目
-
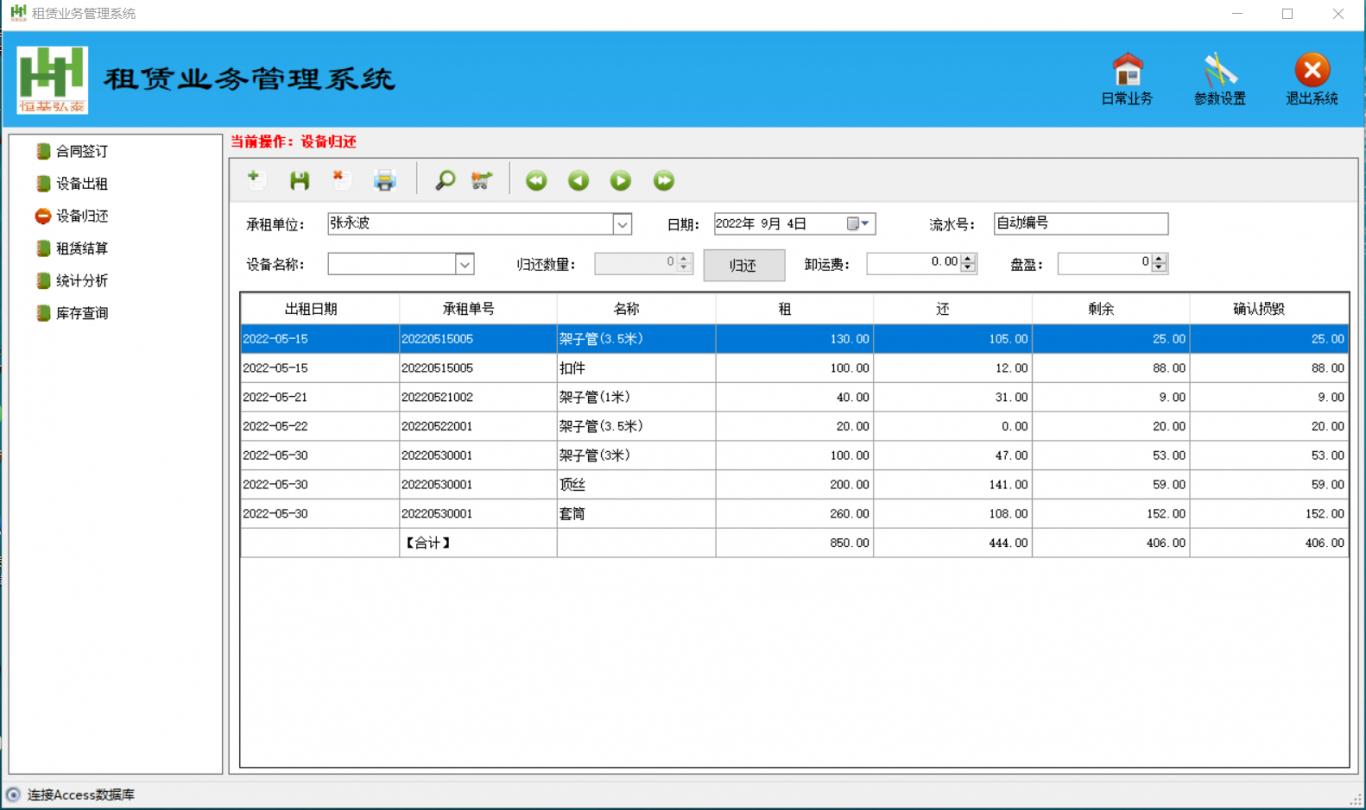
租赁行业业务管理系统
该系统旨在客户租赁,可按签订合同价格进行记录约定租金,管理多
-
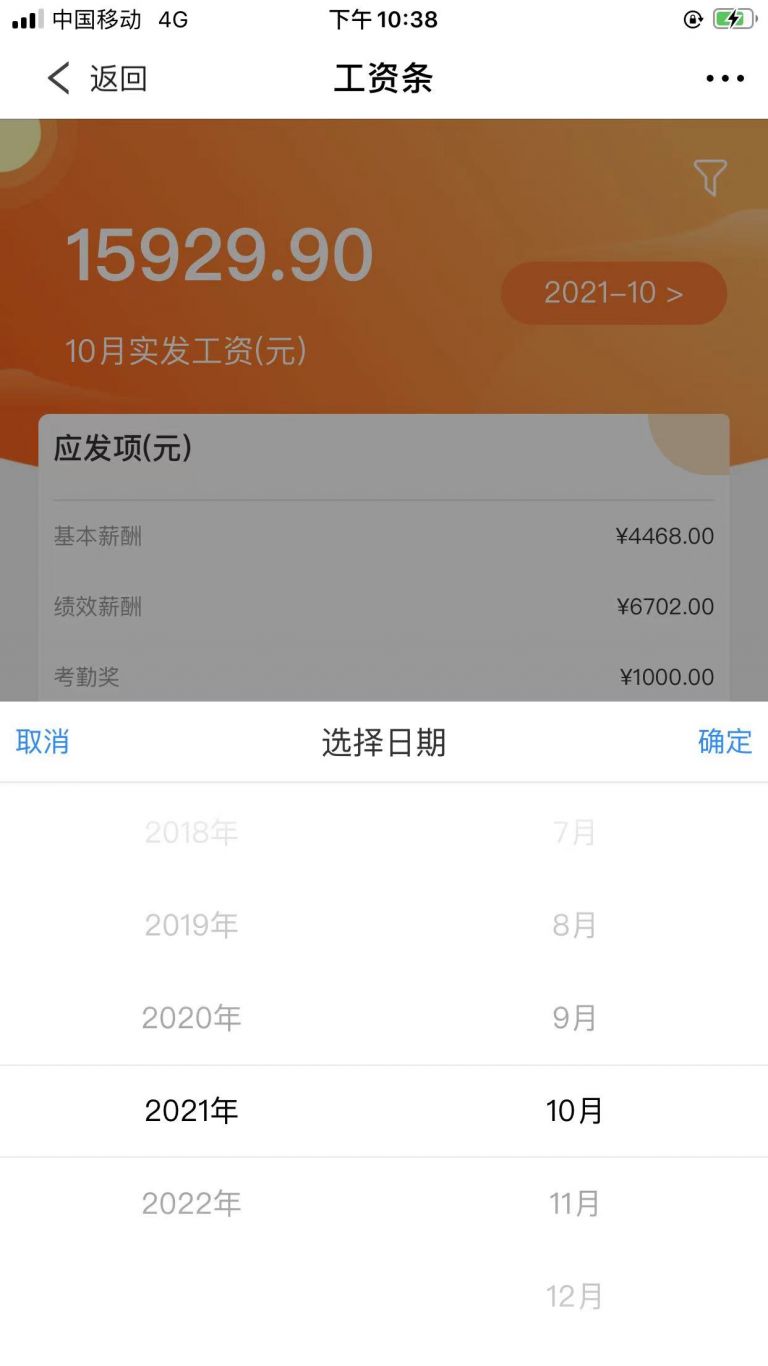
工资条
功能模块: 1、免登,获取用户信息 2、工资月份或季节汇
1小时精推人才
需求方专属客服,免费梳理匹配

