税憨憨的案例列表
作品集见git链接
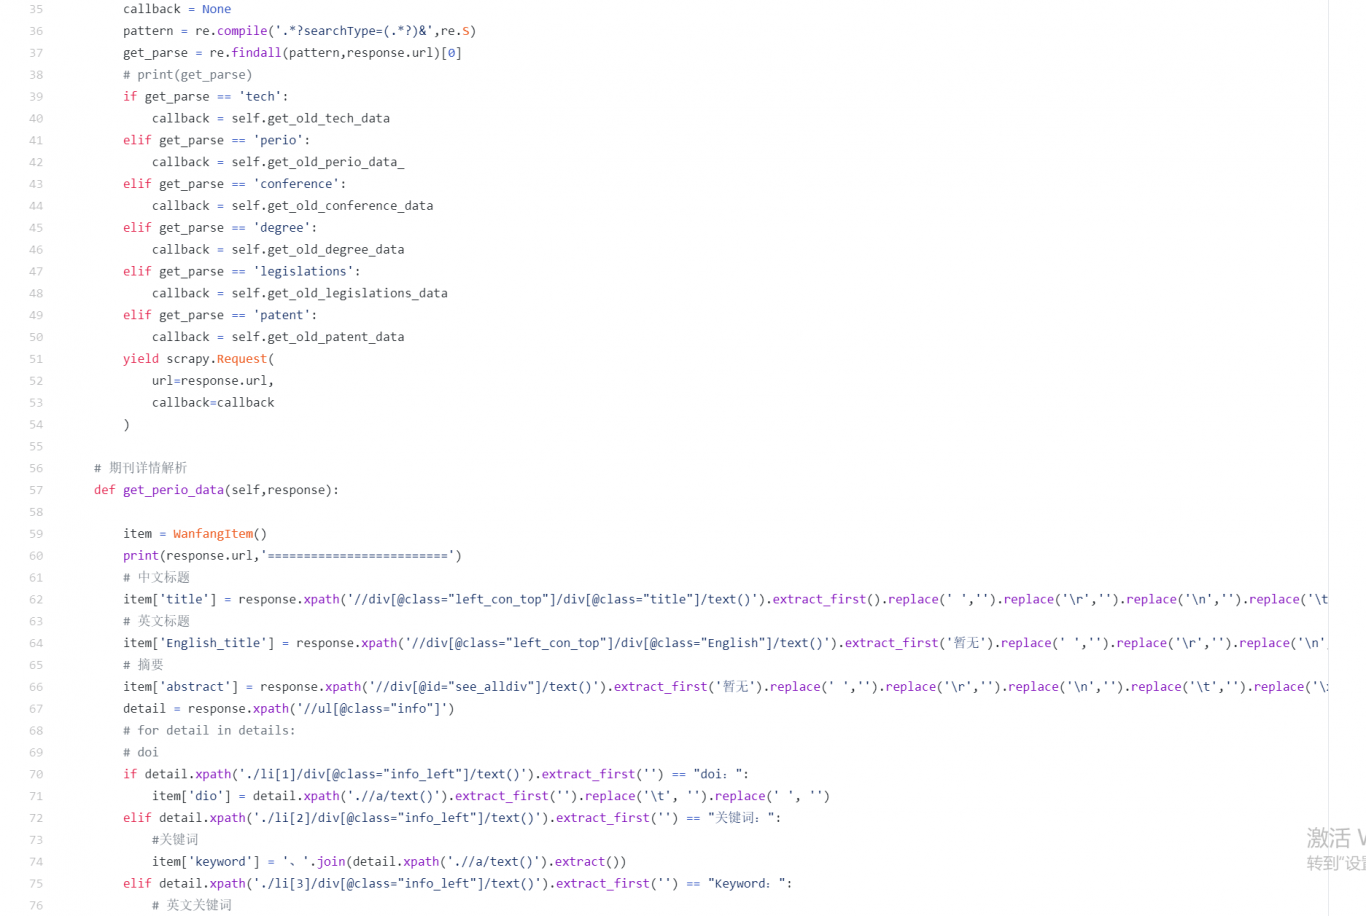
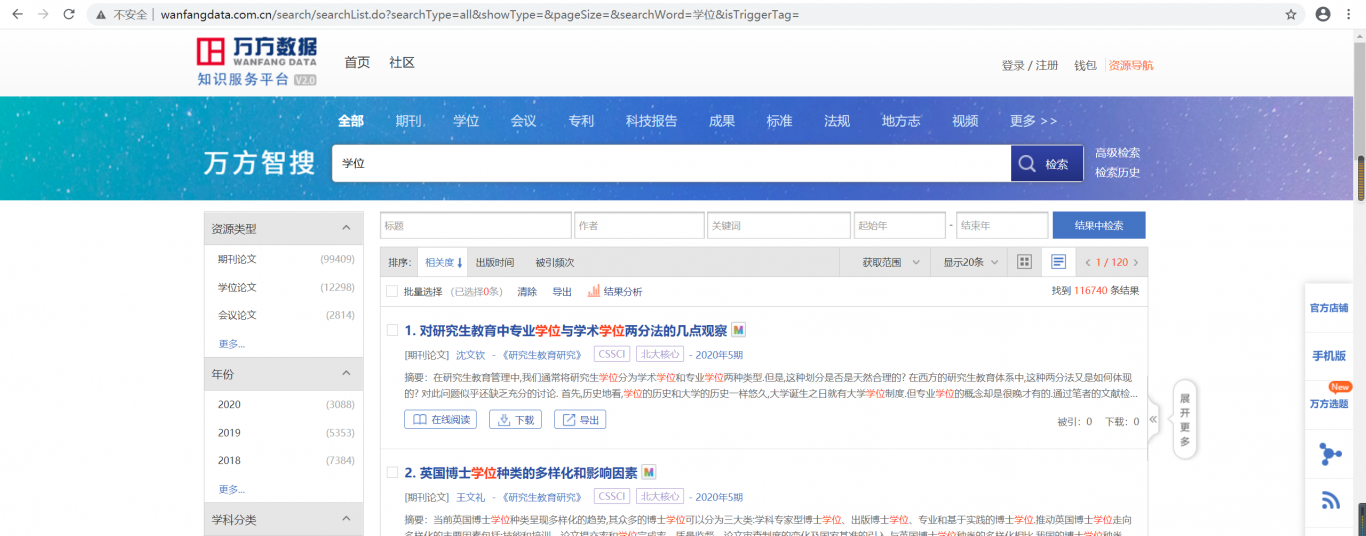
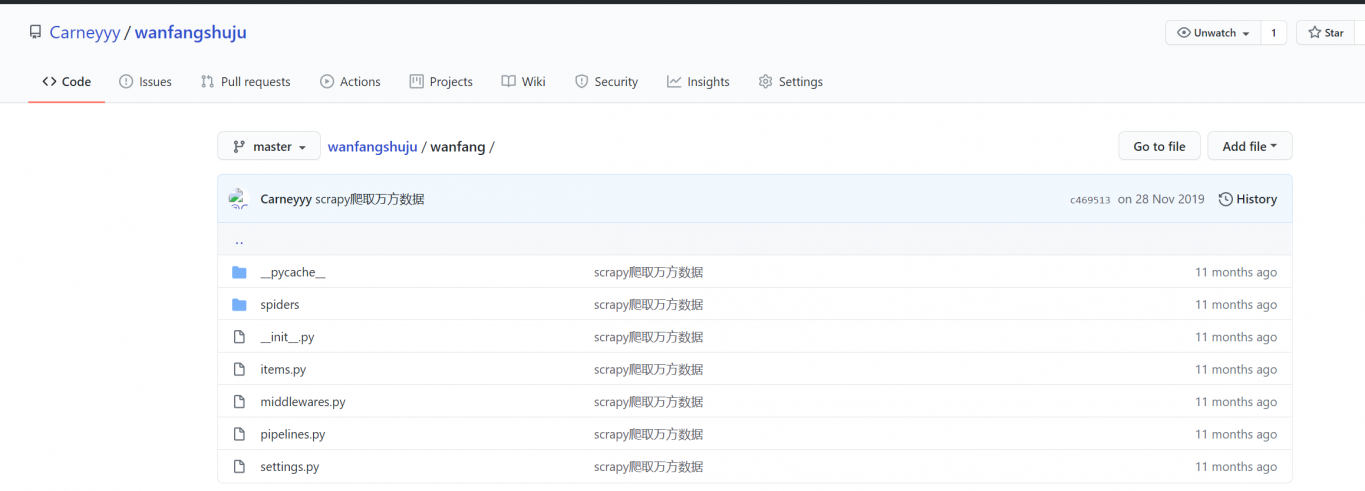
在作品中负责角色有 爬虫 使用 python 的 Scrapy 爬虫框架来实现对页面信息的抓取 根据万方的反爬机制,提出针对性的意见和应急性的处理 它是根据每页最大数量返回信息条数和共返回页数来限制用户获取信息量 由于此网页分旧,新两版 在旧网页没有对返回数据作出限制 用正则取出旧版详情 id 与新版详情 url 拼接 为了实现对商品信息的自动化爬取,利用 Scrapy 框架中的 CrawlSpider 模块对 url 进行过 滤 使用 MySQL 数据库进行信息存储
web网站
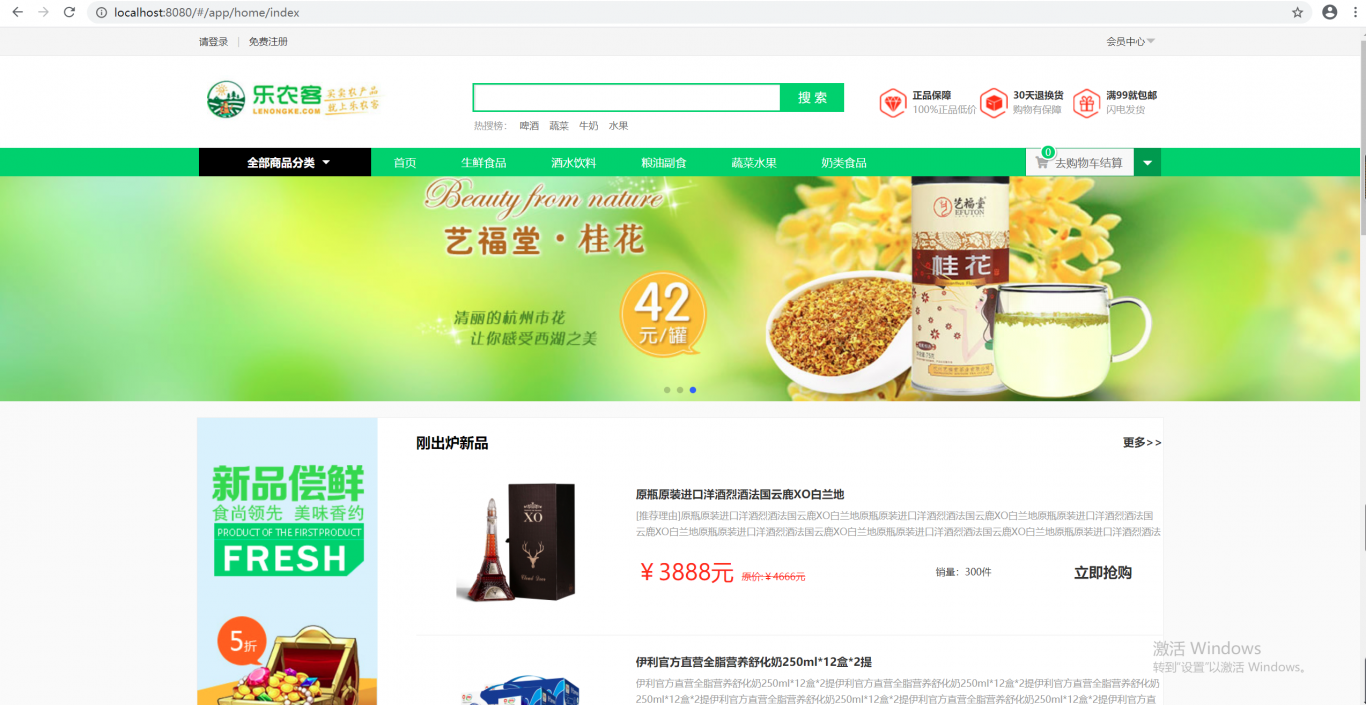
python web 框架 django+ vue 编写web端全栈 html js css 编写静态网站 auto.js 安卓自动化测试 使用python + selenium 编写web端自动化测试脚本
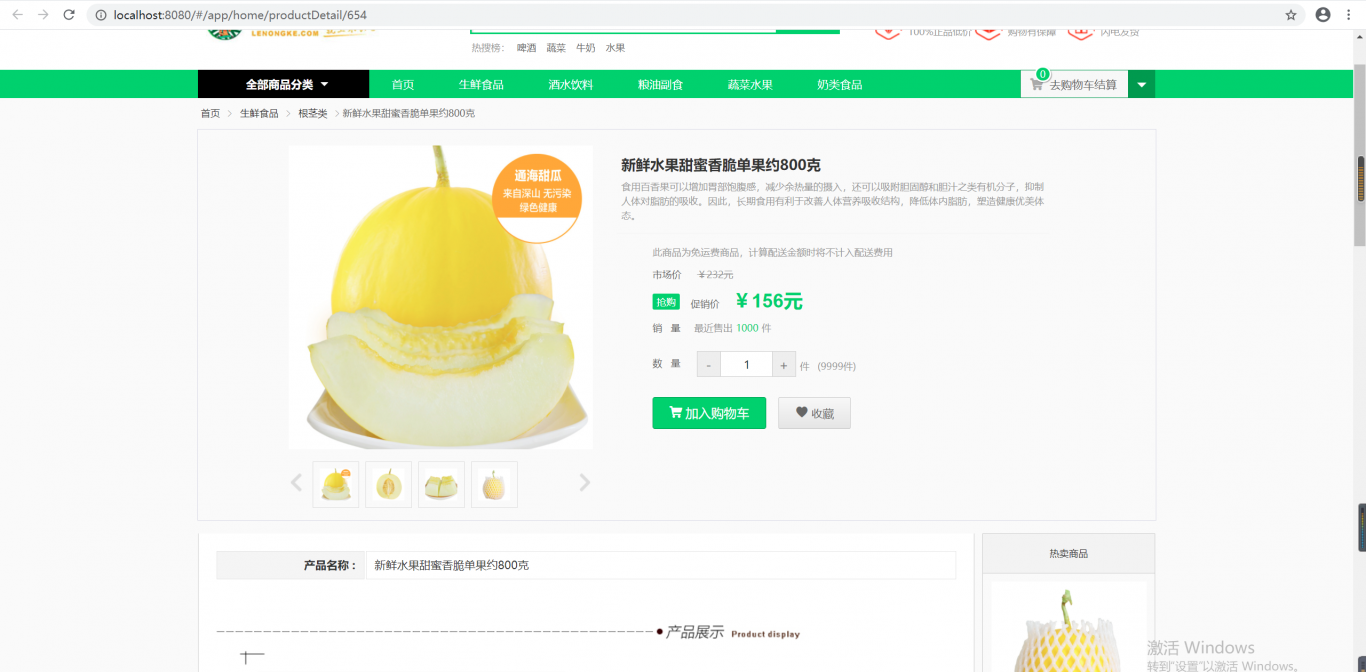
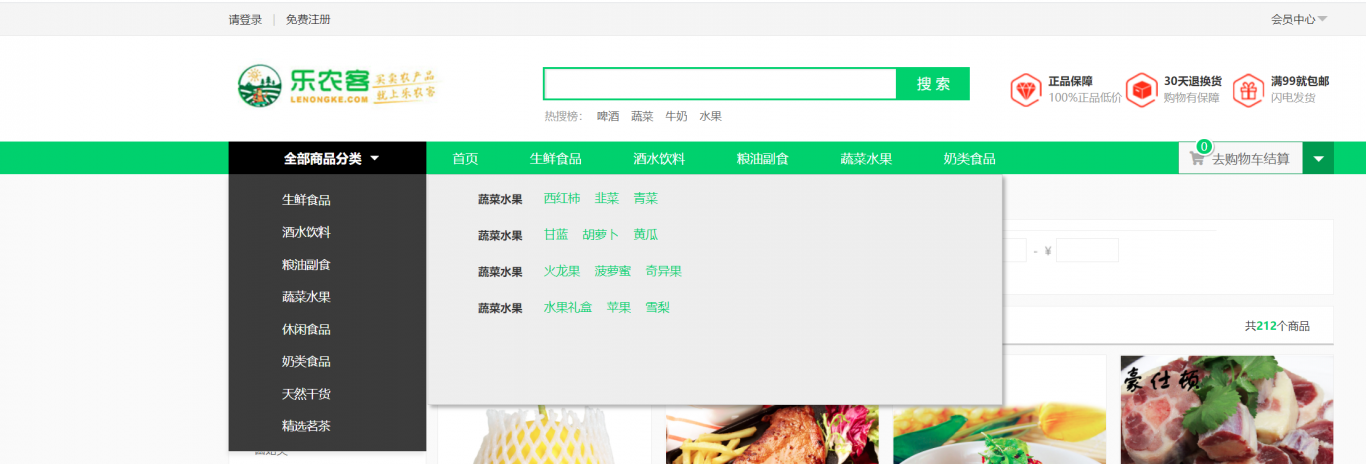
web网站
python web 框架 django+ vue 编写web端全栈 html js css 编写静态网站 auto.js 安卓自动化测试 使用python + selenium 编写web端自动化测试脚本
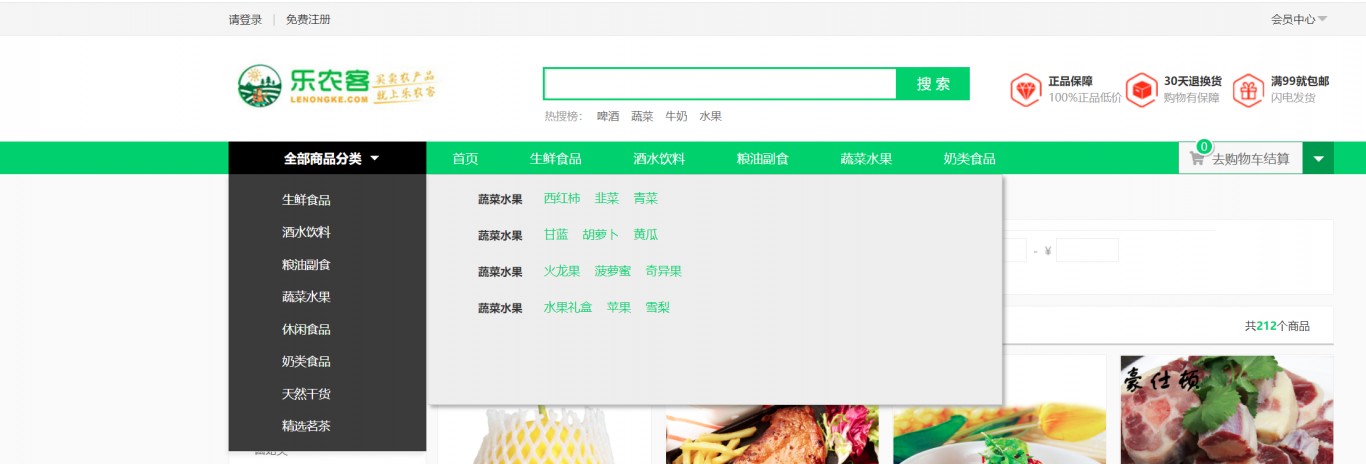

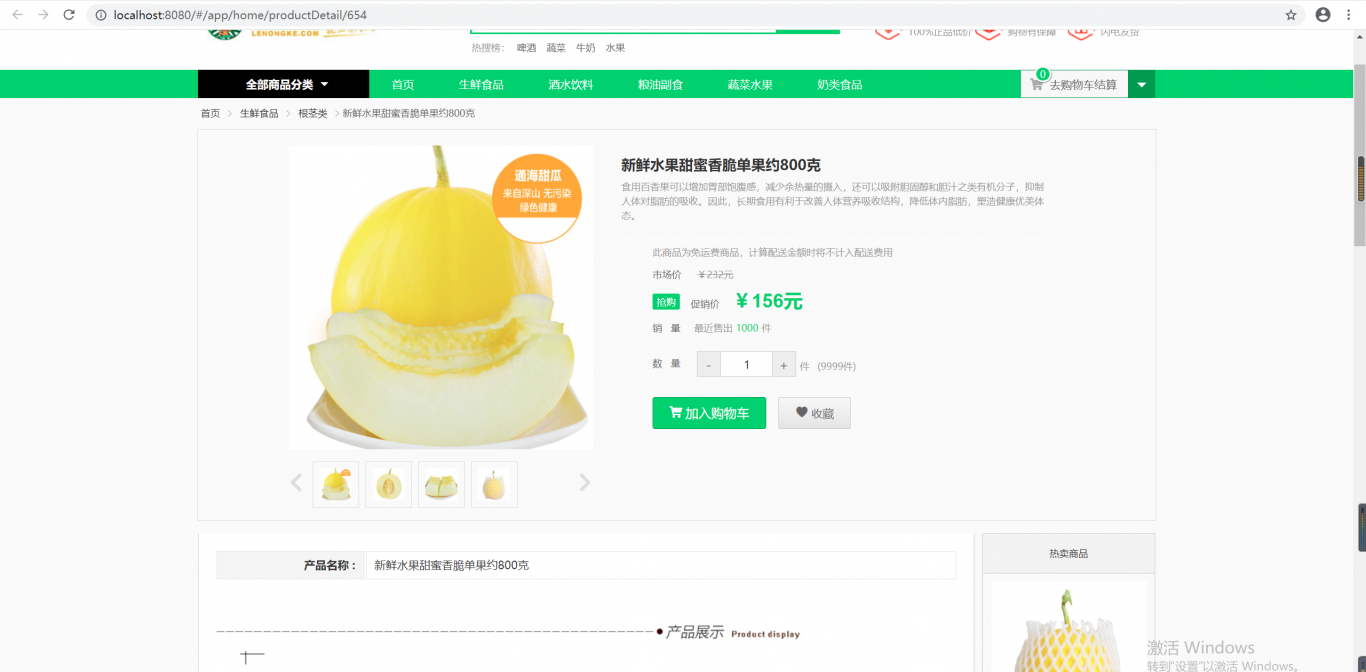
案例判断参考
税憨憨的案例列表
作品集见git链接
在作品中负责角色有 爬虫 使用 python 的 Scrapy 爬虫框架来实现对页面信息的抓取 根据万方的反爬机制,提出针对性的意见和应急性的处理 它是根据每页最大数量返回信息条数和共返回页数来限制用户获取信息量 由于此网页分旧,新两版 在旧网页没有对返回数据作出限制 用正则取出旧版详情 id 与新版详情 url 拼接 为了实现对商品信息的自动化爬取,利用 Scrapy 框架中的 CrawlSpider 模块对 url 进行过 滤 使用 MySQL 数据库进行信息存储...
web网站
python web 框架 django+ vue 编写web端全栈 html js css 编写静态网站 auto.js 安卓自动化测试 使用python + selenium 编写web端自动化测试脚本...
web网站
python web 框架 django+ vue 编写web端全栈 html js css 编写静态网站 auto.js 安卓自动化测试 使用python + selenium 编写web端自动化测试脚本...


